小米智慧攝影機雲台版2K 在台開賣:升級 2K 高畫質和 F1.4 大光圈,售價 1,095元_包裝設計

※產品缺大量曝光嗎?你需要的是一流包裝設計!

窩窩觸角包含自媒體、自有平台及其他國家營銷業務等,多角化經營並具有國際觀的永續理念。

小米智慧攝影機雲台版已經在台灣銷售一段時間,隨著近年民眾對於日常生活監控有更高畫質需求,在去年四月於中國率先推出了升級 2K 高畫質的更新機型,終於在今(13)日稍早「小米智慧攝影機雲台版 2K」終於在台灣正式開賣。新一代升級 2K 超高畫質版本的小米智慧攝影機雲台版在外型大致上延續前一代簡約的設計,在鏡頭圈處改為金黃色的搭配。

小米智慧攝影機雲台版2K 在台開賣:升級 2K 高畫質和 F1.4 大光圈,售價 1,095元

作為許多家庭的「看家神器」,不少人會選擇小米的智慧攝影機系列產品,而之前除了小米智慧攝影機雲台版 2K Pro ,對於想求價格更便宜的智慧攝影機消費者而言,「小米智慧攝影機雲台版」則是相對更符合需求的選擇,不過之前小米台灣只率先引進 2K Pro ,直到今日才正式在台灣發售小米智慧攝影機雲台版 2K 。

全新在台販售的小米智慧攝影機雲台版 2K 在畫質方面升級 2K(2340*1296)解析度的 300 萬像素,擁有更清晰的畫質、能呈現更多畫面細節。

光圈部分則升級為 F1.4 大光圈鏡頭,增加進光量使得微弱光線環境能捕捉到更多畫面細節。

鏡頭全面升級為 6P 鏡片,有效降低光線折損率、讓成像更清晰、透亮和細膩。

小米智慧攝影機雲台版 2K 內建 940nm 紅外線補光燈,搭配高感光靈敏度感光元件,開啟「微光全彩」功能,在微光調降下也能呈現彩色影像。

小米智慧攝影機雲台版 2K 無論正向安裝或者倒轉安裝,都能 180° 翻轉畫面進行居家監控。另外,由於採用雙電機雲台設計,可 360° 水平調整可視角度、 108° 調整垂直可視角度,只要透過米家 App 就能直接操控。

小米智慧攝影機雲台版 2K 亦支援雙向語音即時通話,即便在外也能透過 App 連接攝影機與在家的家人進行即時通話。

※南投搬家公司費用需注意的眉眉角角,別等搬了再說!

上新台中搬家公司提供您一套專業有效率且人性化的辦公室搬遷、公司行號搬家及工廠遷廠的搬家服務

售價方面,小米智慧攝影機雲台版 2K 在台灣的建議售價為 1,095 元,今日已經在台灣正式開賣:

以下為小米智慧攝影機雲台版 1080P、小米智慧攝影機雲台版 2K 以及小米智慧攝影機雲台版 2K Pro 之間的功能差異:

小米智慧攝影機雲台版 2K:點我前往購買(小米台灣)

圖片/消息來源:小米台灣

延伸閱讀:
Redmi K40 系列 S888 旗艦新機確定將於 2 月發表,官方提前公布售價約 12,912 元起

小米11 Pro 最新高清晰概念渲染圖曝光!傳聞搭載 50MP 四鏡頭主相機,支持 120x 混合變焦

您也許會喜歡:

【推爆】終身$0月租 打電話只要1元/分

立達合法徵信社-讓您安心的選擇

※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

網動廣告出品的網頁設計,採用精簡與質感的CSS語法,提升企業的專業形象與簡約舒適的瀏覽體驗,讓瀏覽者第一眼就愛上她。

OPPO Reno5 、Reno5 Pro 正式在台發表:全新升級 AI 錄影、獨家 Reno Glow 2.0 星鑽工藝打造精緻外觀_台中搬家

※台中搬家公司費用怎麼算?

擁有20年純熟搬遷經驗,提供免費估價且流程透明更是5星評價的搬家公司

今(12)日稍早, OPPO 正式在台灣發表旗下最新 Reno5 系列新機 OPPO Reno5 和 Reno5 Pro ,除了延續前一代輕薄的機身設計,在機身質感處理、 AI 錄影拍攝全面升級,讓用戶錄製生活影片帶來更豐富的樂趣。另外,在 OPPO Reno5 和 Reno5 Pro 皆支持最高 90Hz 螢幕更新率和 65W SuperVOOC 2.0 超級閃充技術。

OPPO Reno5 、Reno5 Pro 正式在台發表:全新升級 AI 錄影、獨家 Reno Glow 2.0 星鑽工藝打造精緻外觀

外觀設計方面,除了 Reno5 機身保持在 7.9mm 、Reno5 Pro 更僅有 7.6mm 的極致輕薄設計,顏色方面這次推出「星夜黑」以及此次 OPPO 為 Reno5 採用更閃耀的「Reno Glow 2.0 星鑽工藝」技術的全新顏色「幻彩銀」。

幻彩銀配色的 Reno5 系列在機身膜片疊層工藝進行了創新,通過 Picasus 炫彩層、菲尼爾紋理層、反光層的疊加,在炫彩層 70mm 的光學反光膜,接著經過光線的穿透與折射,反光出上千種顏色。另外,兩層疊加進一步增強了色彩的亮度,因此在轉動機身時可呈現出上千種顏色的閃爍變化。

螢幕方面, OPPO Reno5 配備 6.43 吋 FHD+ 解析度 OLED 螢幕,支持 90Hz 螢幕更新率和 180Hz 觸控採樣率,局部峰值最高亮度為 750nit ; Reno5 Pro 則配備更大的 6.55 吋 FHD+ 解析度 OLED 曲面螢幕,支持 90Hz 螢幕更新率和 180Hz 觸控採樣率,局部峰值最高亮度則為 1100nit。

Reno5 和 Reno5 Pro 在相機規格方面, OPPO Reno5 系列搭載後置 6,400 萬像素人像四鏡頭主相機,分別為 6,400 萬像素標準鏡頭+800 萬像素超廣角鏡頭+200 萬像素微距鏡頭+200 萬像素人像黑白鏡頭。

前置相機則配備 3,200 萬像素自拍鏡頭。在相機功能方面, Reno5 系列在錄影部分升級 AI 錄影增強結合「超級動態夜景」和「Live HDR」功能,透過先進的 AI 演算法提升暗光畫面亮度和細節表現。

這次 Reno5 系列加入的「雙重錄影」讓使用者可同時開啟前後鏡頭進行影片錄製,並提供左右均分、上下舉行切割以及圓形三種模式可選擇,對於生活記錄也更加有趣。

美顏方面, Reno5 系列更支援 AI 錄影美顏,透過 AI 檢測可針對臉部標記多達 194 個特徵點,並提供八重 100 級的自訂美顏選項,包括摩陂、小臉、瘦臉、下巴、大眼、補妝、瘦鼻、立體等設定,打造全面的美顏優化效果。

AI 錄影美顏還能智慧識別天生特徵與後天瑕疵,將瑕疵部分處理掉保留像是美人痣等天生特徵。

※台中搬家遵守搬運三大原則,讓您的家具不再被破壞!

台中搬家公司推薦超過30年經驗,首選台中大展搬家

Reno5 和 Reno5 Pro 在硬體規格方面略有差異, Reno5 搭載高通 Snapdragon 765G  5G 處理器、配備 8GB RAM 和 128GB ROM、內建等效 4300mAh 電池; Reno5 Pro 搭載聯發科天璣 1000+ 5G 處理器、配備 12GB RAM 和 256GB ROM、內建等效 4350mAh 電池。

OPPO Reno5 系列全面支援 65W SuperVOOC 2.0 超級閃充技術,只需充電 5 分鐘即可追劇 4 小時、充電 15 分鐘則最高可充電至 60% , Reno5 充電至 100% 只需要 35 分鐘、 Reno5 Pro 更只需要 30 分鐘即可充滿。

售價方面, OPPO Reno5 建議售價為 14,990 元;Reno5 Pro 建議售價則為 20,990 元:

OPPO Reno5 和 Reno5 Pro 於今(12)日起至 1 月 15 日 23:59 官方與電商通路開放預購、將於 1 月 16 日正式開賣, 1 月 25 日起則在各大電信通路全面開賣。

凡於指定通路預購 OPPO Reno5 、 Reno5 Pro 除可獲贈限量 Reno5 系列專屬禮盒,其中包含 OPPO Enco W31 無線藍牙耳機(市價 NT$1,899)和犀牛皮螢幕保護膜(市價 NT$890),另外在官網登錄再贈送 12 個月螢幕意外保障和 6 個月延長保固。

OPPO 也將於 1 月 16 日於以下指定通路舉辦首銷派對,現場排隊 VIP 交機限量加碼贈 7-Eleven 禮券,並可於現場抽獎還有機會免費獲得 OPPO Reno5(市價 NT$14,990)或 OPPO Watch Wi-Fi(市價 NT$8,990)。

OPPO Reno5|Reno5 Pro 官網預購頁面:點我前往

您也許會喜歡:

【推爆】終身$0月租 打電話只要1元/分

立達合法徵信社-讓您安心的選擇

※台中搬家公司費用怎麼算?

擁有20年純熟搬遷經驗,提供免費估價且流程透明更是5星評價的搬家公司

微軟推出新款 Surface Pro 7 Plus,SSD 採可拆式設計,擁有更好散熱、更大電池_台中搬家公司

※推薦台中搬家公司優質服務,可到府估價

台中搬鋼琴,台中金庫搬運,中部廢棄物處理,南投縣搬家公司,好幫手搬家,西屯區搬家

隨著 CES 2021 登場,各大品牌都陸續推出新產品、新技術,這次微軟也缺席,稍早就發表一款全新 Surface Pro 7 Plus 平板筆電(或稱 Surface Pro 7+),跟現行的 Surface Pro 7 相比,許多地方都有提升,像是採用最新 Intel 第 11 代處理器、更好的散熱設計與續航力、以及相當吸引人的可拆式 SSD,讓用戶可自行修理或替換。

微軟推出新款 Surface Pro 7 Plus

微軟最新 Surface Pro 7 Plus 平板筆電外型與螢幕跟 Surface Pro 7 相同,都是 12.3 吋與 2736×1824 的解析度,基本上沒改變,主要都是在內部硬體:

首先是 LTE,這可說是自 2015 年以來,Surface Pro 系列再次見到 LTE 的機型,內部搭載的晶片組為 Snapdragon X20 LTE,也因此很可惜不支援目前最夯的 5G 網路。

處理器部分 Surface Pro 7 Plus 搭載 Intel 第 11 代,效能預計提升一倍。另外跟大多數 Surface Pro 系列一樣,Surface Pro 7 Plus 也有 i3~i7 的選擇,i3 版將內建 8GB RAM 與 128GB SSD 儲存空間,i7 版則可以選擇最高 32GB RAM 與 1TB SSD 儲存空間,LTE 版僅限 i5 版:

散熱方面採用全新石墨散熱設計,相較於 Surface Pro 7 散熱效果更好,還加入跟 Surface Pro X 一樣的技術,減少螢幕厚度並增加內部空間,然後再把這多餘空間加裝更大的電池,Surface Pro 7 Plus 是目前 Surface Pro 系列中,電池最大的一款,容量為 50.4 Wh:

根據微軟測試,最高可提供長達 15 小時的續航力,比 Surface Pro 7 多 4.5 小時,且支援快速充電,大約一小時內就能充飽 80%。

背面用螺絲打開就能看到可拆式 SSD:

※台中搬家公司教你幾個打包小技巧,輕鬆整理裝箱!

還在煩惱搬家費用要多少哪?台中大展搬家線上試算搬家費用,從此不再擔心「物品怎麼計費」、「多少車才能裝完」

I/O 端也跟 Surface Pro 7 一樣,具有一個 USB-C、USB-A、3.5mm 耳機孔與 Surface 連接介面:

Surface Pro 7 Plus 建議售價為 899 美金起,最旗艦機型要價 2799 美金,LTE 版起價為 1419 美金。

資料來源:微軟

微軟將推出對使用者更友善、更容易使用的檔案恢復工具

您也許會喜歡:

【推爆】終身$0月租 打電話只要1元/分

立達合法徵信社-讓您安心的選擇

※推薦台中搬家公司優質服務,可到府估價

台中搬鋼琴,台中金庫搬運,中部廢棄物處理,南投縣搬家公司,好幫手搬家,西屯區搬家

說了這麼多次 I/O,但你知道它的原理么_網頁設計公司

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!

以設計的實用美學觀點,規劃出舒適、美觀的視覺畫面,有效提昇使用者的心理期待,營造出輕鬆、愉悅的網站瀏覽體驗。

IO 軟件目標

設備獨立性

現在讓我們轉向對 I/O 軟件的研究,I/O 軟件設計一個很重要的目標就是設備獨立性(device independence)。啥意思呢?這意味着我們能夠編寫訪問任何設備的應用程序,而不用事先指定特定的設備。比如你編寫了一個能夠從設備讀入文件的應用程序,那麼這個應用程序可以從硬盤、DVD 或者 USB 進行讀入,不必再為每個設備定製應用程序。這其實就體現了設備獨立性的概念。

再比如說你可以輸入一條下面的指令

sort 輸入 輸出

那麼上面這個 輸入 就可以接收來自任意類型的磁盤或者鍵盤,並且 輸出 可以寫入到任意類型的磁盤或者屏幕。

計算機操作系統是這些硬件的媒介,因為不同硬件它們的指令序列不同,所以需要操作系統來做指令間的轉換。

與設備獨立性密切相關的一個指標就是統一命名(uniform naming)。設備的代號應該是一個整數或者是字符串,它們不應該依賴於具體的設備。在 UNIX 中,所有的磁盤都能夠被集成到文件系統中,所以用戶不用記住每個設備的具體名稱,直接記住對應的路徑即可,如果路徑記不住,也可以通過 ls 等指令找到具體的集成位置。舉個例子來說,比如一個 USB 磁盤被掛載到了 /usr/cxuan/backup 下,那麼你把文件複製到 /usr/cxuan/backup/device 下,就相當於是把文件複製到了磁盤中,通過這種方式,實現了向任何磁盤寫入文件都相當於是向指定的路徑輸出文件。

錯誤處理

除了設備獨立性外,I/O 軟件實現的第二個重要的目標就是錯誤處理(error handling)。通常情況下來說,錯誤應該交給硬件層面去處理。如果設備控制器發現了讀錯誤的話,它會盡可能的去修復這個錯誤。如果設備控制器處理不了這個問題,那麼設備驅動程序應該進行處理,設備驅動程序會再次嘗試讀取操作,很多錯誤都是偶然性的,如果設備驅動程序無法處理這個錯誤,才會把錯誤向上拋到硬件層面(上層)進行處理,很多時候,上層並不需要知道下層是如何解決錯誤的。這就很像項目經理不用把每個決定都告訴老闆;程序員不用把每行代碼如何寫告訴項目經理。這種處理方式不夠透明。

同步和異步傳輸

I/O 軟件實現的第三個目標就是 同步(synchronous) 和 異步(asynchronous,即中斷驅動)傳輸。這裏先說一下同步和異步是怎麼回事吧。

同步傳輸中數據通常以塊或幀的形式發送。發送方和接收方在數據傳輸之前應該具有同步時鐘。而在異步傳輸中,數據通常以字節或者字符的形式發送,異步傳輸則不需要同步時鐘,但是會在傳輸之前向數據添加奇偶校驗位。下面是同步和異步的主要區別

比較條件 同步傳輸 異步傳輸
概念 塊頭序列開始 它分別在字符前面和後面使用開始位和停止位。
傳輸方式 以塊或幀的形式發送數據 發送字節或者字符
同步方式 同步時鐘 無
傳輸速率 同步傳輸比較快 異步傳輸比較慢
時間間隔 同步傳輸通常是恆定時間 異步傳輸時間隨機
開銷 同步開銷比較昂貴 異步傳輸開銷比較小
是否存在間隙 不存在 存在
實現 硬件和軟件 只有硬件
示例 聊天室,視頻會議,電話對話等。 信件,电子郵件,論壇

回到正題。大部分物理IO(physical I/O) 是異步的。物理 I/O 中的 CPU 是很聰明的,CPU 傳輸完成後會轉而做其他事情,它和中斷心靈相通,等到中斷髮生后,CPU 才會回到傳輸這件事情上來。

I/O 分為兩種:物理I/O 和 邏輯I/O(Logical I/O)。

物理 I/O 通常是從磁盤等存儲設備實際獲取數據。邏輯 I/O 是對存儲器(塊,緩衝區)獲取數據。

緩衝

I/O 軟件的最後一個問題是緩衝(buffering)。通常情況下,從一個設備發出的數據不會直接到達最後的設備。其間會經過一系列的校驗、檢查、緩衝等操作才能到達。舉個例子來說,從網絡上發送一個數據包,會經過一系列檢查之後首先到達緩衝區,從而消除緩衝區填滿速率和緩衝區過載。

共享和獨佔

I/O 軟件引起的最後一個問題就是共享設備和獨佔設備的問題。有些 I/O 設備能夠被許多用戶共同使用。一些設備比如磁盤,讓多個用戶使用一般不會產生什麼問題,但是某些設備必須具有獨佔性,即只允許單個用戶使用完成后才能讓其他用戶使用。

下面,我們來探討一下如何使用程序來控制 I/O 設備。一共有三種控制 I/O 設備的方法

  • 使用程序控制 I/O
  • 使用中斷驅動 I/O
  • 使用 DMA 驅動 I/O

使用程序控制 I/O

使用程序控制 I/O 又被稱為 可編程I/O,它是指由 CPU 在驅動程序軟件控制下啟動的數據傳輸,來訪問設備上的寄存器或者其他存儲器。CPU 會發出命令,然後等待 I/O 操作的完成。由於 CPU 的速度比 I/O 模塊的速度快很多,因此可編程 I/O 的問題在於,CPU 必須等待很長時間才能等到處理結果。CPU 在等待時會採用輪詢(polling)或者 忙等(busy waiting) 的方式,結果,整個系統的性能被嚴重拉低。可編程 I/O 十分簡單,如果需要等待的時間非常短的話,可編程 I/O 倒是一個很好的方式。一個可編程的 I/O 會經歷如下操作

  • CPU 請求 I/O 操作
  • I/O 模塊執行響應
  • I/O 模塊設置狀態位
  • CPU 會定期檢查狀態位
  • I/O 不會直接通知 CPU 操作完成
  • I/O 也不會中斷 CPU
  • CPU 可能會等待或在隨後的過程中返回

使用中斷驅動 I/O

鑒於上面可編程 I/O 的缺陷,我們提出一種改良方案,我們想要在 CPU 等待 I/O 設備的同時,能夠做其他事情,等到 I/O 設備完成后,它就會產生一个中斷,這个中斷會停止當前進程並保存當前的狀態。一個可能的示意圖如下

儘管中斷減輕了 CPU 和 I/O 設備的等待時間的負擔,但是由於還需要在 CPU 和 I/O 模塊之前進行大量的逐字傳輸,因此在大量數據傳輸中效率仍然很低。下面是中斷的基本操作

  • CPU 進行讀取操作
  • I/O 設備從外圍設備獲取數據,同時 CPU 執行其他操作
  • I/O 設備中斷通知 CPU
  • CPU 請求數據
  • I/O 模塊傳輸數據

所以我們現在着手需要解決的就是 CPU 和 I/O 模塊間數據傳輸的效率問題。

使用 DMA 的 I/O

DMA 的中文名稱是直接內存訪問,它意味着 CPU 授予 I/O 模塊權限在不涉及 CPU 的情況下讀取或寫入內存。也就是 DMA 可以不需要 CPU 的參与。這個過程由稱為 DMA 控制器(DMAC)的芯片管理。由於 DMA 設備可以直接在內存之間傳輸數據,而不是使用 CPU 作為中介,因此可以緩解總線上的擁塞。DMA 通過允許 CPU 執行任務,同時 DMA 系統通過系統和內存總線傳輸數據來提高系統併發性。

I/O 層次結構

I/O 軟件通常組織成四個層次,它們的大致結構如下圖所示

每一層和其上下層都有明確的功能和接口。下面我們採用和計算機網絡相反的套路,即自下而上的了解一下這些程序。

下面是另一幅圖,這幅圖显示了輸入/輸出軟件系統所有層及其主要功能。

下面我們具體的來探討一下上面的層次結構

中斷處理程序

在計算機系統中,中斷就像女人的脾氣一樣無時無刻都在產生,中斷的出現往往是讓人很不爽的。中斷處理程序又被稱為中斷服務程序 或者是 ISR(Interrupt Service Routines),它是最靠近硬件的一層。中斷處理程序由硬件中斷、軟件中斷或者是軟件異常啟動產生的中斷,用於實現設備驅動程序或受保護的操作模式(例如系統調用)之間的轉換。

中斷處理程序負責處理中斷髮生時的所有操作,操作完成后阻塞,然後啟動中斷驅動程序來解決阻塞。通常會有三種通知方式,依賴於不同的具體實現

  • 信號量實現中:在信號量上使用 up 進行通知;
  • 管程實現:對管程中的條件變量執行 signal 操作
  • 還有一些情況是發送一些消息

不管哪種方式都是為了讓阻塞的中斷處理程序恢復運行。

中斷處理方案有很多種,下面是 《ARM System Developer’s Guide

Designing and Optimizing System Software》列出來的一些方案

  • 非嵌套的中斷處理程序按照順序處理各个中斷,非嵌套的中斷處理程序也是最簡單的中斷處理
  • 嵌套的中斷處理程序會處理多个中斷而無需分配優先級
  • 可重入的中斷處理程序可使用優先級處理多个中斷
  • 簡單優先級中斷處理程序可處理簡單的中斷
  • 標準優先級中斷處理程序比低優先級的中斷處理程序在更短的時間能夠處理優先級更高的中斷
  • 高優先級 中斷處理程序在短時間能夠處理優先級更高的任務,並直接進入特定的服務例程。
  • 優先級分組中斷處理程序能夠處理不同優先級的中斷任務

下面是一些通用的中斷處理程序的步驟,不同的操作系統實現細節不一樣

  • 保存所有沒有被中斷硬件保存的寄存器
  • 為中斷服務程序設置上下文環境,可能包括設置 TLB、MMU 和頁表,如果不太了解這三個概念,請參考另外一篇文章
  • 為中斷服務程序設置棧
  • 對中斷控制器作出響應,如果不存在集中的中斷控制器,則繼續響應中斷
  • 把寄存器從保存它的地方拷貝到進程表中
  • 運行中斷服務程序,它會從發出中斷的設備控制器的寄存器中提取信息
  • 操作系統會選擇一個合適的進程來運行。如果中斷造成了一些優先級更高的進程變為就緒態,則選擇運行這些優先級高的進程
  • 為進程設置 MMU 上下文,可能也會需要 TLB,根據實際情況決定
  • 加載進程的寄存器,包括 PSW 寄存器
  • 開始運行新的進程

上面我們羅列了一些大致的中斷步驟,不同性質的操作系統和中斷處理程序能夠處理的中斷步驟和細節也不盡相同,下面是一個嵌套中斷的具體運行步驟

設備驅動程序

在上面的文章中我們知道了設備控制器所做的工作。我們知道每個控制器其內部都會有寄存器用來和設備進行溝通,發送指令,讀取設備的狀態等。

因此,每個連接到計算機的 I/O 設備都需要有某些特定設備的代碼對其進行控制,例如鼠標控制器需要從鼠標接受指令,告訴下一步應該移動到哪裡,鍵盤控制器需要知道哪個按鍵被按下等。這些提供 I/O 設備到設備控制器轉換的過程的代碼稱為 設備驅動程序(Device driver)。

為了能夠訪問設備的硬件,實際上也就意味着,設備驅動程序通常是操作系統內核的一部分,至少現在的體繫結構是這樣的。但是也可以構造用戶空間的設備驅動程序,通過系統調用來完成讀寫操作。這樣就避免了一個問題,有問題的驅動程序會幹擾內核,從而造成崩潰。所以,在用戶控件實現設備驅動程序是構造系統穩定性一個非常有用的措施。MINIX 3 就是這麼做的。下面是 MINI 3 的調用過程

然而,大多數桌面操作系統要求驅動程序必須運行在內核中。

操作系統通常會將驅動程序歸為 字符設備 和 塊設備,我們上面也介紹過了

在 UNIX 系統中,操作系統是一個二進製程序,包含需要編譯到其內部的所有驅動程序,如果你要對 UNIX 添加一個新設備,需要重新編譯內核,將新的驅動程序裝到二進製程序中。

※自行創業缺乏曝光? 網頁設計幫您第一時間規劃公司的形象門面

網站的第一印象網頁設計,決定了客戶是否繼續瀏覽的意願。台北網動廣告製作的RWD網頁設計,採用精簡與質感的CSS語法,提升企業的專業形象與簡約舒適的瀏覽體驗,讓瀏覽者第一眼就愛上它。

然而隨着大多數個人計算機的出現,由於 I/O 設備的廣泛應用,上面這種靜態編譯的方式不再有效,因此,從 MS-DOS 開始,操作系統轉向驅動程序在執行期間動態的裝載到系統中。

設備驅動程序具有很多功能,比如接受讀寫請求,對設備進行初始化、管理電源和日誌、對輸入參數進行有效性檢查等。

設備驅動程序接受到讀寫請求后,會檢查當前設備是否在使用,如果設備在使用,請求被排入隊列中,等待後續的處理。如果此時設備是空閑的,驅動程序會檢查硬件以了解請求是否能夠被處理。在傳輸開始前,會啟動設備或者馬達。等待設備就緒完成,再進行實際的控制。控制設備就是對設備發出指令。

發出命令后,設備控制器便開始將它們寫入控制器的設備寄存器。在將每個命令寫入控制器后,會檢查控制器是否接受了這條命令並準備接受下一個命令。一般控制設備會發出一系列的指令,這稱為指令序列,設備控制器會依次檢查每個命令是否被接受,下一條指令是否能夠被接收,直到所有的序列發出為止。

發出指令后,一般會有兩種可能出現的情況。在大多數情況下,設備驅動程序會進行等待直到控制器完成它的事情。這裏需要了解一下設備控制器的概念

設備控制器的主要主責是控制一個或多個 I/O 設備,以實現 I/O 設備和計算機之間的數據交換。

設備控制器接收從 CPU 發送過來的指令,繼而達到控制硬件的目的

設備控制器是一個可編址的設備,當它僅控制一個設備時,它只有一個唯一的設備地址;如果設備控制器控制多個可連接設備時,則應含有多個設備地址,並使每一個設備地址對應一個設備。

設備控制器主要分為兩種:字符設備和塊設備

設備控制器的主要功能有下面這些

  • 接收和識別命令:設備控制器可以接受來自 CPU 的指令,並進行識別。設備控制器內部也會有寄存器,用來存放指令和參數

  • 進行數據交換:CPU、控制器和設備之間會進行數據的交換,CPU 通過總線把指令發送給控制器,或從控制器中并行地讀出數據;控制器將數據寫入指定設備。

  • 地址識別:每個硬件設備都有自己的地址,設備控制器能夠識別這些不同的地址,來達到控制硬件的目的,此外,為使 CPU 能向寄存器中寫入或者讀取數據,這些寄存器都應具有唯一的地址。

  • 差錯檢測:設備控制器還具有對設備傳遞過來的數據進行檢測的功能。

在這種情況下,設備控制器會阻塞,直到中斷來解除阻塞狀態。還有一種情況是操作是可以無延遲的完成,所以驅動程序不需要阻塞。在第一種情況下,操作系統可能被中斷喚醒;第二種情況下操作系統不會被休眠。

設備驅動程序必須是可重入的,因為設備驅動程序會阻塞和喚醒然後再次阻塞。驅動程序不允許進行系統調用,但是它們通常需要與內核的其餘部分進行交互。

與設備無關的 I/O 軟件

I/O 軟件有兩種,一種是我們上面介紹過的基於特定設備的,還有一種是設備無關性的,設備無關性也就是不需要特定的設備。設備驅動程序與設備無關的軟件之間的界限取決於具體的系統。下面显示的功能由設備無關的軟件實現

與設備無關的軟件的基本功能是對所有設備執行公共的 I/O 功能,並且向用戶層軟件提供一個統一的接口。

緩衝

無論是對於塊設備還是字符設備來說,緩衝都是一個非常重要的考量標準。下面是從 ADSL(調製解調器) 讀取數據的過程,調製解調器是我們用來聯網的設備。

用戶程序調用 read 系統調用阻塞用戶進程,等待字符的到來,這是對到來的字符進行處理的一種方式。每一個到來的字符都會造成中斷。中斷服務程序會給用戶進程提供字符,並解除阻塞。將字符提供給用戶程序后,進程會去讀取其他字符並繼續阻塞,這種模型如下

這一種方案是沒有緩衝區的存在,因為用戶進程如果讀不到數據會阻塞,直到讀到數據為止,這種情況效率比較低,而且阻塞式的方式,會直接阻止用戶進程做其他事情,這對用戶來說是不能接受的。還有一種情況就是每次用戶進程都會重啟,對於每個字符的到來都會重啟用戶進程,這種效率會嚴重降低,所以無緩衝區的軟件不是一個很好的設計。

作為一個改良點,我們可以嘗試在用戶空間中使用一個能讀取 n 個字節緩衝區來讀取 n 個字符。這樣的話,中斷服務程序會把字符放到緩衝區中直到緩衝區變滿為止,然後再去喚醒用戶進程。這種方案要比上面的方案改良很多。

但是這種方案也存在問題,當字符到來時,如果緩衝區被調出內存會出現什麼問題?解決方案是把緩衝區鎖定在內存中,但是這種方案也會出現問題,如果少量的緩衝區被鎖定還好,如果大量的緩衝區被鎖定在內存中,那麼可以換進換出的頁面就會收縮,造成系統性能的下降。

一種解決方案是在內核中內部創建一塊緩衝區,讓中斷服務程序將字符放在內核內部的緩衝區中。

當內核中的緩衝區要滿的時候,會將用戶空間中的頁面調入內存,然後將內核空間的緩衝區複製到用戶空間的緩衝區中,這種方案也面臨一個問題就是假如用戶空間的頁面被換入內存,此時內核空間的緩衝區已滿,這時候仍有新的字符到來,這個時候會怎麼辦?因為緩衝區滿了,沒有空間來存儲新的字符了。

一種非常簡單的方式就是再設置一個緩衝區就行了,在第一個緩衝區填滿后,在緩衝區清空前,使用第二個緩衝區,這種解決方式如下

當第二個緩衝區也滿了的時候,它也會把數據複製到用戶空間中,然後第一個緩衝區用於接受新的字符。這種具有兩個緩衝區的設計被稱為 雙緩衝(double buffering)。

還有一種緩衝形式是 循環緩衝(circular buffer)。它由一個內存區域和兩個指針組成。一個指針指向下一個空閑字,新的數據可以放在此處。另外一個指針指向緩衝區中尚未刪除數據的第一個字。在許多情況下,硬件會在添加新的數據時,移動第一個指針;而操作系統會在刪除和處理無用數據時會移動第二個指針。兩個指針到達頂部時就回到底部重新開始。

緩衝區對輸出來說也很重要。對輸出的描述和輸入相似

緩衝技術應用廣泛,但它也有缺點。如果數據被緩衝次數太多,會影響性能。考慮例如如下這種情況,

數據經過用戶進程 -> 內核空間 -> 網絡控制器,這裏的網絡控制器應該就相當於是 socket 緩衝區,然後發送到網絡上,再到接收方的網絡控制器 -> 接收方的內核緩衝 -> 接收方的用戶緩衝,一條數據包被緩存了太多次,很容易降低性能。

錯誤處理

在 I/O 中,出錯是一種再正常不過的情況了。當出錯發生時,操作系統必須盡可能處理這些錯誤。有一些錯誤是只有特定的設備才能處理,有一些是由框架進行處理,這些錯誤和特定的設備無關。

I/O 錯誤的一類是程序員編程錯誤,比如還沒有打開文件前就讀流,或者不關閉流導致內存溢出等等。這類問題由程序員處理;另外一類是實際的 I/O 錯誤,例如向一個磁盤壞塊寫入數據,無論怎麼寫都寫入不了。這類問題由驅動程序處理,驅動程序處理不了交給硬件處理,這個我們上面也說過。

設備驅動程序統一接口

我們在操作系統概述中說到,操作系統一個非常重要的功能就是屏蔽了硬件和軟件的差異性,為硬件和軟件提供了統一的標準,這個標準還體現在為設備驅動程序提供統一的接口,因為不同的硬件和廠商編寫的設備驅動程序不同,所以如果為每個驅動程序都單獨提供接口的話,這樣沒法搞,所以必須統一。

分配和釋放

一些設備例如打印機,它只能由一個進程來使用,這就需要操作系統根據實際情況判斷是否能夠對設備的請求進行檢查,判斷是否能夠接受其他請求,一種比較簡單直接的方式是在特殊文件上執行 open操作。如果設備不可用,那麼直接 open 會導致失敗。還有一種方式是不直接導致失敗,而是讓其阻塞,等到另外一個進程釋放資源后,在進行 open 打開操作。這種方式就把選擇權交給了用戶,由用戶判斷是否應該等待。

注意:阻塞的實現有多種方式,有阻塞隊列等

設備無關的塊

不同的磁盤會具有不同的扇區大小,但是軟件不會關心扇區大小,只管存儲就是了。一些字符設備可以一次一個字節的交付數據,而其他的設備則以較大的單位交付數據,這些差異也可以隱藏起來。

用戶空間的 I/O 軟件

雖然大部分 I/O 軟件都在內核結構中,但是還有一些在用戶空間實現的 I/O 軟件,凡事沒有絕對。一些 I/O 軟件和庫過程在用戶空間存在,然後以提供系統調用的方式實現。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

台中景泰電動車行只是一個單純的理由,將來台灣的環境,出門可以自由放心的深呼吸,讓空氣回歸自然的乾淨,減少污染,留給我們下一代有好品質無空污的優質環境

從軟件開發到 AI 領域工程師:模型訓練篇_如何寫文案

※別再煩惱如何寫文案,掌握八大原則!

什麼是銷售文案服務?A就是幫你撰寫適合的廣告文案。當您需要販售商品、宣傳活動、建立個人品牌,撰寫廣告文案都是必須的工作。

前言

4 月熱播的韓劇《王國》,不知道大家有沒有看?我一集不落地看完了。王子元子出生時,正逢宮內殭屍作亂,元子也被咬了一口,但是由於大腦神經元尚未形成,寄生蟲無法控制神經元,所以醫女在做了簡單處理后,判斷不會影響大腦。這裏提到了人腦神經元,它也是 AI 神經網絡的研究起源,具體展開講講。

人腦中總共有 860 億個神經元,其中大腦皮層有 160 億個神經元。大腦皮層的神經元數量決定了動物的智力水平,人的大腦皮層中神經元數量遠高於其他物種,所以人類比其他物種更聰明。大象的腦子總共有 2570 億個神經元,但是其中 98% 的神經元都存在於大象的小腦中,而大象的大腦皮層只有 56 億個神經元,無法與人類相比。大腦皮層中的神經元數量越大,能耗也越大。人腦每天消耗的能量占人體全部耗能的 25%,這也就是為什麼我們每天都要吃多餐,很容易餓的原因。人之所以能夠很快超越其他物種,主要是因為人類掌握了烹飪技術,能夠在短時間內攝入大量卡路里以支持大腦運轉,其他物種則將攝入的卡路里用於維護身體運轉,不得不犧牲大腦皮層的神經元數量。

之所以先談大腦神經元原理,也是為了引出本文的重點–現代 AI 技術。在正式進入 AI 技術前,我先講講軟件工程師這份工作,因為現在有很多軟件工程師準備轉入 AI 行業。

軟件工程師

我是軟件工程師出身,2004 年剛畢業時我寫的是 JSP 代碼(一種將 Java 語言嵌入在 HTML 代碼中的編寫方式),工作幾年後轉入分佈式軟件技術,再後來進入大數據技術領域,最近的 4 年時間我一直在從事 AI 平台研發工作。

軟件工程師的要求,我總體分為基礎編碼和系統架構兩方面,因此我對於軟件工程師的考察,特別是校招學生時,為了進一步考察他們的綜合能力,我每次都會自己準備面試題,這些題目包括了編程基本概念、算法編程題、操作系統、數據庫編程、開源代碼閱讀、垃圾回收機制、系統架構描述等。

編碼的話題展開來可以講很久,發展歷史很悠久,我 15 歲學編程時用的是 Basic 語言,讀大學時學的是 C 語言,大學畢業參加工作后第一門用的語言是 Java,其中的各種故事和理解可以寫幾篇文章,這裏不展開談。

我覺得談到軟件工程師工作,避不開軟件架構設計。大眾談軟件架構,很多人會認為軟件架構就是一堆框架的組合,其實不對,軟件架構本身是對於軟件實體的組織形式的闡述,使用框架的意義是快速完成軟件架構設計,而不是取代軟件架構設計,兩者本質上不是一類事物,更像是設計圖紙和所使用的原材料。軟件架構就是通過對軟件生命周期的拆分,在符合業務架構的前提下,以達到軟件本身訪問增長目的的方式。這個增長需要軟件開發的增長,也需要軟件運行的增長,由此達到所支撐業務的增長。

市面上也確實有很多例如“分佈式系統架構”、“微服務架構”等等跟隨着潮流的書籍,但是看完后只停留在會採用一些開源框架進行整體框架搭建,我說的是搭建,而不是設計。確實是搭建,你所擁有的能力就好像小孩子搭積木,只會採用固定討論,或者學得差點,連固定套路都沒學會,這樣對你的個人能力發展其實沒有多大好處,這也是為什麼很多程序員在完成了程序員 – 架構師的轉型后,沒過多久就轉為純管理,或者徹底離開了技術界,因為從來沒有大徹大悟理解系統架構。

之所以談了這麼多系統架構相關的工作理解,是因為我認為系統架構師系統化的思維,我們搞 AI 系統也是系統化的思維,從有較強編程能力的系統架構師轉 AI 技術,相對容易一些。

AI 工程師

為什麼要從軟件工程師轉行到 AI 產品研發?因為 AI 產品研發有更大的吸引力,因為它更難,難到我們並不確定什麼時候才能真正做出來,做出來真正能夠可複製的 AI 產品。表面上看它也是一個門檻—一個“可用”且“可複製”的 AI 技術,但因為難度足夠大,所以有挑戰性,必須不斷地改善技術,做全球範圍內還沒有做出來的技術。搞軟件開發時處理的一些問題可能是其他公司已經解決的,並非“人類”都還沒有解決的問題。

AI 的研究最早可以被追溯到亞里士多德的三段論,然後萊布尼茨創立了處理邏輯,布爾在布爾代數上的貢獻,弗雷德在近代邏輯上的貢獻,羅素在邏輯主義方面的貢獻,這些工作都是在數據邏輯上的。一般認為,現代 AI 技術討論,起源於 1956 年在達特茅斯學院召開的夏季研討會,而這門學科的源頭可能是 Alan Turing(阿蘭. 圖靈) 1948 年在英國國家物理實驗室(NPL)寫過的一份內部報告,這份報告中提到了肉體智能和無肉體智能,從某種意義上預示了後來符號派和統計派之爭,或是 Turing 在 1950 年在哲學雜誌《心》(Mind)上發表的文章“計算機與智能”,反正都是 Turing。

可以這麼認為,現代 AI 是一系列通用目的技術的總稱。現代 AI 技術,主要指基於機器學習(Machine Learning,簡稱 ML)/ 深度學習(Deep Learning,簡稱 DL)的一系列方法和應用,這隻是 AI 領域的一個分支,也是目前發展最快、應用最廣的分支。

機器學習 / 深度學習的原理可以這樣理解:建立一個模型,給一個輸入,通過模型的運算,得到一個輸出。可以用於解決一個簡單問題,例如識別圖片是不是狗,也可以用來解決複雜問題,例如下棋、開車、醫療診斷、交通治理等等,也可以理解為,模型就是一個函數 f(x),上述過程,可以表達為:f(一張圖片)= 狗 / 不是狗。

一個 AI 應用開發,大概分為三個階段:

  • 第一階段,識別問題、構建模型、選擇模型。AI 的開發和培養一個小孩子類似,不同的孩子有不同的愛好和特長,同樣地,AI 也有很多模型 / 算法,不同的模型 / 算法適合解決不同的問題。所以,首先要識別你要解決的是個什麼問題,然後選擇一個合適的模型 / 算法;
  • 第二階段,訓練模型。和培養小孩子一樣,即使你發現小孩子有音樂天分,他也不可能天生就是鋼琴家,他需要專業的訓練。AI 開發也一樣,選定模型 / 算法后,即使算法再好,也不能馬上有效工作,你需要用大量的數據訓練這個模型,訓練過程中不斷優化參數,讓模型能夠更為有效地工作。這個階段 AI 模型的工作狀態,叫做“訓練”;
  • 第三階段,模型部署。模型訓練結束后就可以部署了。比如一個人臉識別的模型,你可以把它部署在手機上,用於開機鑒權,也可以把它部署在園區閘機上,用於出入管理,還可以把它部署在銀行的客戶端上,用於業務鑒權,等等。如同一個孩子成長為鋼琴家后,既可以在音樂會上演奏,也可以在家庭聚會上表演。AI 模型部署之後的工作狀態,專業的說法,叫做“推理”。

通過上述 AI 開發過程的簡述,可以發現,算法、數據和算力,是驅動 AI 發展的三大動力,三者缺一不可。

  • 算法相當於是基因。基因不好,再努力也白搭。如何識別問題,並根據問題選擇算法,甚至開發新的算法,是高端 AI 專家的核心競爭力;
  • 數據相當於是學習材料。光基因好,沒有好的教材,也教不出大師。AI 的訓練,需要海量的、高質量的數據作為輸入。AlhpaGo 通過自己和自己下棋,下了幾千萬盤,人類一輩子最多也就下幾千盤。沒有這樣的訓練量,AlhpaGo 根本不可戰勝人類。自動駕駛,Google 已經搞了 10 年,訓練了幾十萬小時,遠遠超過一個專業賽車手的訓練量,但離真正的無人駕駛還差很遠。另外,數據的質量也很重要,如果你給 AI 輸入的數據是錯的,那麼訓練出來的 AI,也會做出錯誤的結果。簡單的說,如果你把貓的圖片當做狗的圖片去訓練 AI,那麼訓練出來的 AI,就一定會把貓當做狗。數據的重要性直接導致了中國湧現了大批以數據標註為生存手段的公司和個人;
  • 一個小孩,光有天分和好的學習材料,自己如果不努力,不投入時間和精力好好學習,絕對不可能成為大師。同樣的道理,一個 AI 模型,算法再好、數據再多,如果沒有足夠的算力,支撐它持續不斷的訓練,這個模型永遠也不能成為一個真正好用的模型。這就是為什麼英偉達崛起的原因,這家公司的 GPU 芯片提供了最為適配於人腦神經網絡的計算算力,現在國內工業界也有了類似的公司產品 – 華為的達芬奇芯片。

訓練 AI 應用模型

動手實踐前

接下來,我們通過對一個 AI 應用模型的訓練和推理過程介紹,開始動手實踐。

訓練模型需要算力,對於算力的獲取,訓練和推理可以根據自己的業務需求,選擇使用公有雲或自己購買帶算力芯片的服務器,本文案我選擇的是某花廠的 AI 開發平台,因為近期他們剛推出一個免費算力的推廣活動,可以省下一筆訓練費用。為了便於調試,我首先在自己的 CPU 個人電腦上編寫代碼、訓練模型,這樣做的缺點是模型收斂的時間長了一些。

疫情期間,對於民眾來說,佩戴口罩是最有效防止被傳染新冠病毒的方式,保護自己的同時也保護他人。所以本文的案例是佩戴口罩的識別模型訓練。識別算法離不開目標檢測。目標檢測(Object Detection)的任務是找出圖像中所有感興趣的目標(物體),確定它們的位置和大小。由於各類物體有不同的形狀、大小和數量,加上物體間還會相互遮擋, 因此目標檢測一直都是機器視覺領域中最具挑戰性的難題之一。

基於深度學習的人臉檢測算法,多數都是基於深度學習目標檢測算法進行的改進,或者說是把通用的目標檢測模型,為適應人臉檢測任務而進行的特定配置。而眾多的目標檢測模型(Faster RCNN、SSD、YOLO)中,人臉檢測算法最常用的是 SSD 算法(Single Shot MultiBox Detector,“Single Shot”指的是單目標檢測,“MultiBox”中的“Box”就像是我們平時拍攝時用到的取景框,只關注框內的畫面,屏蔽框外的內容。創建“Multi”個 “Box”,將每個 “Box” 的單目標檢測結果匯總起來就是多目標檢測。換句話說,SSD 將圖像切分為 N 片,並對每片進行獨立的單目標檢測,最後匯總每片的檢測結果。),其他如 SSH 模型、S3FD 模型、RetinaFace 算法,都是受 SSD 算法的啟發,或者基於 SSD 進行的任務定製化改進, 例如將定位層提到更靠前的位置,Anchor 大小調整、Anchor 標籤分配規則的調整,在 SSD 基礎上加入 FPN 等。本文訓練口罩識別模型採用了 YOLO。

目標檢測過程都可以分解為兩個獨立的操作:

  • 定位(location): 用一個矩形(bounding box)來框定物體,bounding box 一般由 4 個整數組成,分別表示矩形左上角和右下角的 x 和 y 坐標,或矩形的左上角坐標以及矩形的長和高。
  • 分類(classification): 識別 bounding box 中的(最大的)物體。

我選擇採用 keras-yolo3-Mobilenet 方案,開源項目地址:
https://github.com/Adamdad/keras-YOLOv3-mobilenet。
MobileNet 的創新亮點是 Depthwise Separable Convolution(深度可分離卷積),與 VGG16 相比,在很小的精度損失情況下,將運算量減小了 30 倍。YOLOv3 的創新亮點是 DarkNet-53、Prediction Across Scales、多標籤多分類的邏輯回歸層。

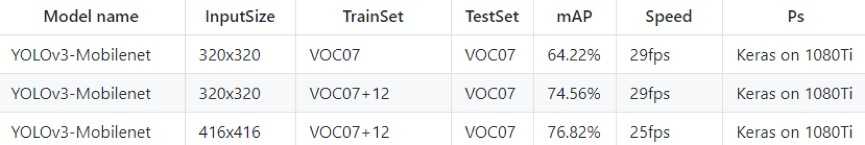
基於開源數據集的實驗結果:

動手訓練模型

訓練模型自然需要訓練數據集和測試數據集,大家可以在這裏下載:

https://modelarts-labs-bj4.obs.cn-north-4.myhuaweicloud.com/casezoo/maskdetect/datasets/maskdetectdatasets.zip

Yolo v3-MobileNet 目標檢測工程的目錄結構如下:

|--model_data
 |--voc_classes.txt
 |--yolo_anchors.txt
|--yolo3
 |--model.py
 |--model_Mobilenet.py
 |--utiles.py
|--convert.py
|--kmeans.py
|--train.py
|--train_Mobilenet.py
|--train_bottleneck.py
|--voc_annotation.py
|--yolo.py
|--yolo_Mobilenet.py
|--yolo_video.py

開源項目的好處是已經幫你封裝了流程,例如涉及的 Yolo 代碼不用修改,本次訓練過程需要修改的代碼主要是以下三個:

1.train_Mobilenet.py:模型訓練代碼;
2.yolo/model_Mobilenet.py:基於 mobilenet 的 yolo 的模型代碼,如果相對模型代碼仔細研究的人,可以研究這個代碼;
3.yolo_Mobilenet.py:模型推理代碼。

接下來具體介紹我們需要修改的代碼,按照功能分為數據類、模型類、可視化類、遷移上雲準備類。

※教你寫出一流的銷售文案?

銷售文案是什麼?A文案是廣告用的文字。舉凡任何宣傳、行銷、販賣商品時所用到的文字都是文案。在網路時代,文案成為行銷中最重要的宣傳方式,好的文案可節省大量宣傳資源,達成行銷目的。

•數據類:

仿照 modeldata/vocclasses.txt 寫一個是否有戴口罩的類別的 txt,內容只有 yes_mask、no_mask 兩個字符。

如果你下載我給出的數據集,你會發現,口罩數據集中給出的 xml 標註格式是 VOC 的標準的,仿照 convert.py 和 voc_annotation.py 寫一個數據轉換文件,代碼如下所示:

import xml.etree.ElementTree as ET 
import os 
 
def convert_annotation(classes, label_path): 
    in_file = open(label_path) 
    tree=ET.parse(in_file) 
    root = tree.getroot() 
    output_list = [] 
    for obj in root.iter('object'): 
        difficult = obj.find('difficult').text 
        cls = obj.find('name').text 
        if cls not in classes or int(difficult)==1: 
            continue 
        cls_id = classes.index(cls) 
        xmlbox = obj.find('bndbox') 
        b = (int(xmlbox.find('xmin').text), int(xmlbox.find('ymin').text), int(xmlbox.find('xmax').text), int(xmlbox.find('ymax').text)) 
        output_list.append(" " + ",".join([str(a) for a in b]) + ',' + str(cls_id)) 
    return (' '.join(output_list)) 
 
 
def mask_convert(data_path, classes): 
    img_list = [] 
    for i in list(os.listdir(data_path)): 
        if i.split('.')[1] == 'jpg': 
            img_list.append(i.split('.')[0]) 
 
    output_list = [] 
    for image_id in img_list: 
        img_path = (data_path + '/%s.jpg' % (image_id)) 
        label_path = (data_path + '/%s.xml' % (image_id)) 
        annotation = convert_annotation(classes, label_path) 
        output_list.append(img_path + annotation) 
 
    return output_list

•模型類:

訓練過程中會有一個 tensor 對不上的錯誤,需要修改 model_data/model.py 這個代碼中的 140-141 行,如下所示:

box_xy = (K.sigmoid(feats[..., :2]) + grid) / K.cast(grid_shape[..., ::-1], K.dtype(feats)) 
box_wh = K.exp(feats[..., 2:4]) * anchors_tensor / K.cast(input_shape[..., ::-1], K.dtype(feats))

•可視化類:

為了直觀判斷模型效果,增加了一個在圖片上直接標註的可視化代碼,也就是在圖片上打印輸出結果(yes_mask 或 no_mask),代碼如下所示:

#!/usr/bin/env python 
# coding: utf- 
 
img_path = "D:/Code/mask_detection/data/test" 
save_path = "D:/Code/mask_detection/data/test_result/" 
 
 
import matplotlib 
matplotlib.use('Agg') 
import matplotlib.pyplot as plt 
import matplotlib.patches as patches 
import matplotlib.image as mpimg 
import random 
import json 
 
# 推理輸出路徑 
with open('D:/Code/mask_detection/keras-YOLOv3-mobilenet-master/annotation_YOLOv3.json') as json_file: 
    data = json.load(json_file) 
 
imgs = list(data.keys()) 
 
def parse_json(json): 
    bbox = [] 
    for item in json['annotations']: 
        name = item['label'] 
        xmin = item['x'] 
        ymin = item['y'] 
        xmax = item['x']+item['width'] 
        ymax = item['y']+item['height'] 
        bbox_i = [name, xmin, ymin, xmax, ymax] 
        bbox.append(bbox_i) 
    return bbox 
 
 
def visualize_bbox(image, bbox, name): 
    fig, ax = plt.subplots() 
    plt.imshow(image) 
    colors = dict()#指定標註某個對象的邊框的顏色 
    for bbox_i in bbox: 
        cls_name = bbox_i[0] #得到 object 的 name 
        if cls_name not in colors: 
            colors[cls_name] = (random.random(), random.random(), random.random()) #隨機生成標註 name 為 cls_name 的 object 的邊框顏色 
        xmin = bbox_i[1] 
        ymin = bbox_i[2] 
        xmax = bbox_i[3] 
        ymax = bbox_i[4] 
        #指明對應位置和大小的邊框 
        rect = patches.Rectangle(xy=(xmin, ymin), width=xmax-xmin, height=ymax-ymin, edgecolor=colors[cls_name],facecolor='None',linewidth=3.5) 
        plt.text(xmin, ymin-2, '{:s}'.format(cls_name), bbox=dict(facecolor=colors[cls_name], alpha=0.5)) 
        ax.add_patch(rect) 
    plt.axis('off') 
    plt.savefig(save_path+'{}_gt.png'.format(name)) #將該圖片保存下來 
    plt.close() 
 
 
for item in imgs: 
    img = mpimg.imread(img_path+item) 
    bbox = parse_json(data[item]) 
    visualize_bbox(img, bbox, item.split('.')[0])

•上雲準備類:

開源代碼寫的比較隨意,直接就是在訓練代碼 trian_Mobilenet.py 代碼中一開頭指定所有的參數。華為雲中訓練作業是需要指定 OBS 的輸入路徑和輸出路徑的,最好使用 argparse 的形式將路徑參數傳進去。其他參數可以按照自己需求做增加,修改樣例如下:

import argparse 
 
parser = argparse.ArgumentParser(description="training a maskmodel in modelarts") 
# 訓練輸出路徑 
parser.add_argument("--train_url", default='logs/maskMobilenet/003_Mobilenet_finetune/', type=str) 
# 數據輸入路徑 
parser.add_argument("--data_url", default="D:/code/mask_detection/data/MASK_MERGE/", type=str) 
# GPU 數量 
parser.add_argument("--num_gpus", default=0, type=int) 
args = parser.parse_args()

開源代碼中,數據處理的部分是將 xml 轉換成 yolo 讀的 txt 文檔,這樣導致數據輸入需要有一個寫入到 txt 文件,然後訓練工程讀取這個 txt 文件和圖片的過程。上雲后,這種流程不太方便,需要將數據處理,數據轉換和訓練代碼打通。這裏我使用緩存將數據直接傳到訓練代碼中,這樣改起來比較方便,但是當數據量較大的時候並不科學,有興趣的人可以自己修改。

遷移公有雲

我使用某廠商公有雲的 AI 訓練平台,用的是 OBS 桶上傳已經調試好的代碼(建議大家體驗 Notebook 方式,在線編程、編譯),如下圖所示:

接着啟動 Notebook,不過我沒有用 jupyter 方式寫代碼,而是採用同步 OBS 桶的資源,通過 Notebook 啟動一個 GPU 鏡像:

創建一個 Notebook 環境:

確認計算資源規格:

創建 Notebook 環境成功:

從 OBS 桶同步相關文件:

接下來進入該 Notebook 的終端環境,運行以下代碼,啟動訓練任務:

訓練過程輸出片段如下所示:

2020-04-07 18:58:14.497319: I tensorflow/stream_executor/dso_loader.cc:152] successfully opened CUDA library libcublas.so.10.0 locally
7/7 [==============================] - 17s 2s/step - loss: 4226.4421 - val_loss: 22123.3750
Epoch 2/50
7/7 [==============================] - 6s 855ms/step - loss: 1083.1558 - val_loss: 1734.1427
Epoch 3/50
7/7 [==============================] - 6s 864ms/step - loss: 521.8567 - val_loss: 455.0971
Epoch 4/50
7/7 [==============================] - 6s 851ms/step - loss: 322.8907 - val_loss: 193.3107
Epoch 5/50
7/7 [==============================] - 6s 841ms/step - loss: 227.7257 - val_loss: 150.8902
Epoch 6/50
7/7 [==============================] - 6s 851ms/step - loss: 179.0605 - val_loss: 154.9351
Epoch 7/50
7/7 [==============================] - 6s 868ms/step - loss: 150.4297 - val_loss: 147.3101
Epoch 8/50
7/7 [==============================] - 8s 1s/step - loss: 129.5681 - val_loss: 144.8283

模型生成后,創建一個 python 腳本,代碼如下,實現了模型文件拷貝到 OBS 桶:

from modelarts.session import Session
session = Session()
session.upload_data(bucket_path="/mask-detection-modelarts-test/run/log/", path="/home/ma-user/work/log/trained_weights_final.h5")

運行推理腳本,我把推測結果打印在了測試圖片上,如下圖所示,識別出了口罩:

後記

AI 技術的興起,已經帶動了科技行業的革命,而每一次業界的革命,都會讓一些公司落寞而讓另一些公司崛起,程序員也一樣,每一次技術換代也都會讓一些程序員沒落而讓另一些程序員崛起。抓住目前正在流行的 AI 技術趨勢,使用雲端的免費計算資源,上手學習並實踐 AI 技術,會是相當一部分軟件工程師、數據科學家的選擇。此外,由於在圖像識別、文本識別、語音識別等技術領域,算法的精度已經給有大幅度的提升,在很多場景下已經達到可商用級別,也進一步讓自動機器學習技術(模型的自動設計和訓練)的發展成為可能。因此,在上述幾個技術領域的很多應用場景下,公有雲已經可以做到根據用戶自定義數據進行 AI 模型的自動訓練。

點擊關注,第一時間了解華為雲新鮮技術~

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

擁有後台管理系統的網站,將擁有強大的資料管理與更新功能,幫助您隨時新增網站的內容並節省網站開發的成本。

前後端分離,如何在前端項目中動態插入後端API基地址?(in docker)_網頁設計公司

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

當全世界的人們隨著網路時代而改變向上時您還停留在『網站美醜不重要』的舊有思維嗎?機會是留給努力改變現況的人們,別再浪費一分一秒可以接觸商機的寶貴時間!

開門見山,本文分享前後端分離,容器化前端項目時動態插入後端API基地址,這是一個很贊的實踐,解決了前端項目容器化過程中受制後端調用的尷尬。

尷尬從何而來

常見的web前後端分離:前後端分開部署,前端項目由nginx承載打包文件,反向代理請求。
應用的某些部分必須是可配置的,比如API調用基地址,
前端打包的時候需要統一插入該地址形成完整chunk files。

# ------------------------------------------------------
# generate chunk file
# ------------------------------------------------------
FROM node:10-alpine as builder

# install and cache app dependencies
COPY package.json package-lock.json ./
RUN npm install && mkdir /react-frontend && mv ./node_modules ./react-frontend
WORKDIR /react-frontend
COPY . .
RUN npm run build


# ------------------------------------------------------
# Production Build
# ------------------------------------------------------
FROM nginx:latest
COPY  nginx.conf  /etc/nginx/nginx.conf
COPY --from=builder /react-frontend/build /usr/share/nginx/html
EXPOSE 80
CMD ["nginx", "-g", "daemon off;"]

當在Docker中打包前端,或許會嘗試用鏡像構建參數Arg/Env來傳遞後端API調用基地址,但這樣是很不理想的:
打包時參數被統一插入,打包結果chunk files作為最終鏡像的一部分,導致最終的前端鏡像會與後端API地址強關聯。

或許你會針對不用的後端環境(canary、staging、production)構建不同的前端鏡像,但這是一次又一次的工作量,並不是最佳實踐。

下面分享一個容器執行階段動態插入後端API基地址的實踐

前端獨立部署,動態插入後端API基地址(in Docker)

我希望將API基地址延遲到生成容器階段(與構建鏡像的過程解耦), 這樣我就可以使用一個鏡像,針對不同的環境傳參形成不同的前端容器。

※網頁設計一頭霧水該從何著手呢? 台北網頁設計公司幫您輕鬆架站!

透過資料庫的網站架設建置,建立公司的形象或購物系統,並提供最人性化的使用介面,讓使用者能即時接收到相關的資訊

前端項目插入配置的腳本如下:

// FILE: set-env.ts
...
export const environment = {
  production: ${isProd},
  apiBaseUrl: 'API_BASE_URL',
  version: 'v${require('../package.json').version}'
};
...

我們在前端配置中寫入API_BASE_URL佔位符,按照既定流程前端打包;

Dockerfile CMD指令指示容器如何運行:

  • 用真實值替換前端chunk files中原插入的API_BASE_URL佔位符
  • 使用nginx承載替換后的chunk files
# FILE: Dockerfile
...
EXPOSE 80

COPY --from=builder /react-frontend/replace_api_url.sh /
CMD ["sh", "replace_api_url.sh"]

下面是replace_api_url.sh的內容:

#!/usr/bin/env sh

find '/usr/share/nginx/html' -name '*.js' -exec sed -i -e 's,API_BASE_URL,'"$API_BASE_URL"',g' {} \;
nginx -g "daemon off;"

正常構建鏡像之後;現在生成容器時,可通過環境變量傳參替換原前端chunk files的API_BASE_URL字符串

docker build -t front .
docker run -p 80:80 -e API_BASE_URL=http://somebackend.com/api front

總結輸出

這是一個巧妙的設計,讓我們在前端獨立容器化部署時,能解耦後端API基地址,避免了一次又一次的構建鏡像工作量。

Dockerfile CMD指令包裝的容器啟動腳本:讓我們在nginx承載前端打包文件之前,做一次字符串替換,成功將後端API基地址“延遲”到容器運行階段。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※想知道最厲害的網頁設計公司嚨底家"!

RWD(響應式網頁設計)是透過瀏覽器的解析度來判斷要給使用者看到的樣貌

循序漸進VUE+Element 前端應用開發(6)— 常規Element 界面組件的使用,循序漸進VUE+Element 前端應用開發(5)— 表格列表頁面的查詢,列表展示和字段轉義處理,循序漸進VUE+Element 前端應用開發(5)— 表格列表頁面的查詢,列表展示和字段轉義處理_網頁設計

※台北網頁設計公司這麼多該如何選擇?

網動是一群專業、熱情、向前行的工作團隊,我們擁有靈活的組織與溝通的能力,能傾聽客戶聲音,激發創意的火花,呈現完美的作品

在我們開發BS頁面的時候,往往需要了解常規界面組件的使用,小到最普通的單文本輸入框、多文本框、下拉列表,以及按鈕、圖片展示、彈出對話框、表單處理、條碼二維碼等等,本篇隨筆基於普通表格業務的展示錄入的場景介紹這些常規Element組件的使用,使得我們對如何利用Element組件有一個大概的認識。

1、列表界面和其他模塊展示處理

在前面隨筆《循序漸進VUE+Element 前端應用開發(5)— 表格列表頁面的查詢,列表展示和字段轉義處理》介紹了基於列表展示了相關數據,並在列表界面整合了增刪改查等常規的業務操作處理。

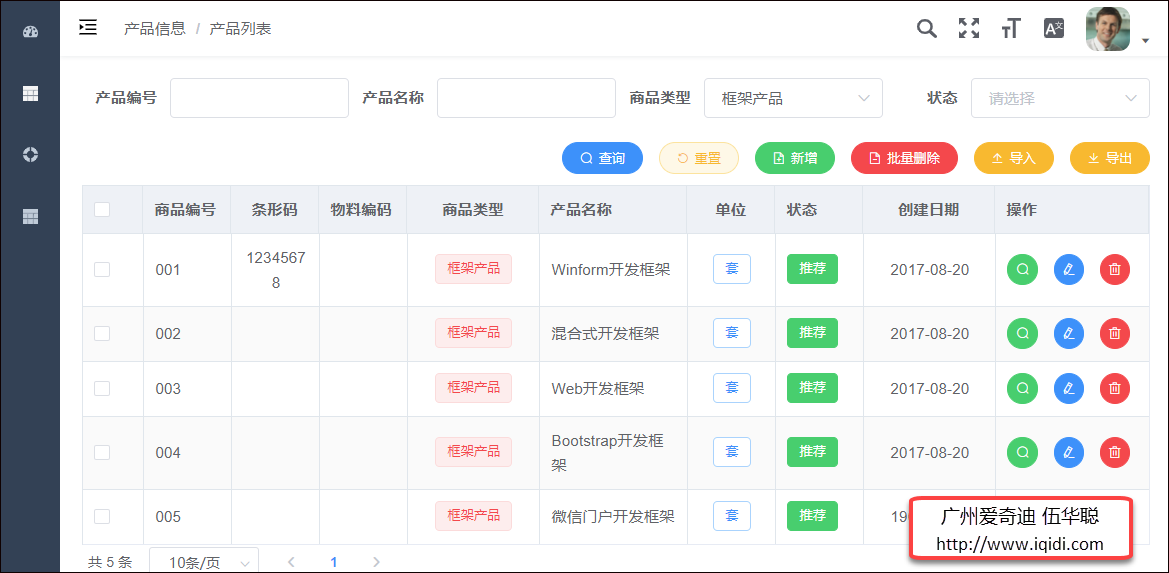
 常規的列表展示界面,一般分為幾個區域,一個是查詢區域,一個是列表展示區域,一個是底部的分頁組件區域。查詢區域主要針對常規條件進行布局,以及增加一些全局或者批量的操作,如導入、導出、添加、批量添加、批量刪除等按鈕;而其中主體的列表展示區域,是相對比較複雜一點的地方,需要對各項數據進行比較友好的展示,可以結合Tag,圖標,按鈕等界面元素來展示,其中列表一般後面會包括一些對單行記錄處理的操作,如查看、編輯、刪除的操作,如果是批量刪除,可以放到頂部的按鈕區域。

對於常規按鈕、表格、分頁組件,前面已經做了相關的介紹,這裏就不再贅述。

在介紹具體界面組件的時候,我們先來了解下,整體的界面布局,我們把常規的列表界面,新增、編輯、查看、導入等界面放在一起,除了列表頁面,其他內容以彈出層對話框的方式進行處理,如下界面示意所示。

 每個對話框的:visible的屬性值,則是確定哪個模態對話框的显示和隱藏。

在Vue的JS模塊裏面,我們除了定義對應的對話框显示的變量外,對每個對話框,我們定義一個表單信息用來進行數據的雙向綁定處理。

 常規的新增、編輯、查看、導入等內容的定義,作為一個對話框組件定義,常規的對話框組件的使用代碼如下所示。

<el-dialog
  title="提示"
  :visible.sync="dialogVisible"
  width="30%"
  :before-close="handleClose">
  <span>這是一段信息</span>
  <span slot="footer" class="dialog-footer">
    <el-button @click="dialogVisible = false">取 消</el-button>
    <el-button type="primary" @click="dialogVisible = false">確 定</el-button>
  </span>
</el-dialog>

為了控制對話框的樣式,我們這裏注意下footer的slot,這個我們一般是把處理按鈕放在這裏,如對於查看界面對話框,我們定義如下所示。

  一般來說,對於表單內容比較多的場景,我們一般分開多個選項卡進行展示或者錄入,這樣方便管理,查看界面整體效果如下所示。

 對於對話框的數據綁定,我們在打開對話框前,先通過API模塊請求獲得JSON數據,然後綁定在對應的對話框模型屬性上即可,如對於查看界面,我們的處理邏輯如下所示。

    showView(id) {
      var param = { id: id }
      GetProductDetail(param).then(data => {
        Object.assign(this.viewForm, data);
      })
      this.isView = true
    },

對於表格的雙擊,我們同樣綁定它的查看明細處理操作,如下模板代碼和JS代碼所示。

模板HTML代碼如下:

<el-table
  v-loading="listLoading"
  :data="productlist"
  border
  fit
  stripe
  highlight-current-row
  :header-cell-style="{background:'#eef1f6',color:'#606266'}"
  @selection-change="selectionChange"
  @row-dblclick="rowDbclick"
>

JS邏輯代碼如下  

    rowDbclick(row, column) {
      var id = row.ID
      this.showView(id);
    },


2、常規界面組件的使用

 一般情況下,我們使用界面組件的時候,參考下官網《Element組件使用》,尋找對應組件的代碼進行參考,就差不多了,這裏還是就各種常規的Element組件進行大概的介紹吧。

1)表單和表單項、單文本框

對於表單,我們一般定義一個對應的名稱,並設置它的data對應的模型名稱即可,如下所示。

<el-form ref="viewForm" :model="viewForm" label-width="80px">

而表單項,一般是定義好表單項的Label即可,然後在其中插入對應的錄入控件或者展示控件。如對於單文本組件使用,如下所示。

 <el-form-item label="產品編號">
   <el-input v-model="editForm.ProductNo" />
 </el-form-item>

其中 v-model=”editForm.ProductNo”  就是對應綁定的數據。

而表單項,可以添加對字段的驗證處理,在數據提交前,可以校驗客戶的錄入是否有效等。

  <el-form-item
    prop="email"
    label="郵箱"
    :rules="[
      { required: true, message: '請輸入郵箱地址', trigger: 'blur' },
      { type: 'email', message: '請輸入正確的郵箱地址', trigger: ['blur', 'change'] }
    ]"
  >
    <el-input v-model="dynamicValidateForm.email"></el-input>
  </el-form-item>

注意這裏表單項,必須添加一個prop的屬性設置,如 prop=”email” 所示。

一般為了控制布局,我們還結合el-row進行一個布局的處理,如下代碼所示(一行等於span為24,span=12也就是一行放兩個控件組)。

<el-row>
  <el-col :span="12">
    <el-form-item label="產品編號">
      <el-input v-model="editForm.ProductNo" />
    </el-form-item>
  </el-col>
  <el-col :span="12">
    <el-form-item label="條碼">
      <el-input v-model="editForm.BarCode" />
    </el-form-item>
  </el-col>
</el-row>


2)、下拉列表控件的綁定

下拉列表的綁定處理,也是通過 v-model 進行值的綁定,而選項則可以通過數據列表進行綁定。

<el-form-item label="商品類型">
  <el-select v-model="editForm.ProductType" filterable="" placeholder="請選擇">
    <el-option
      v-for="(item, key) in typeList"
      :key="key"
      :label="item.value"
      :value="item.key"
    />
  </el-select>
</el-form-item>

而選項中的 typeList,我們可以在頁面初始化的時候獲取出來即可。

  created() {
    // 獲取產品類型,用於綁定字典等用途
    GetProductType().then(data => {
      if (data) {
        data.forEach(item => {
          this.productTypes.set(item.id, item.name)
          this.typeList.push({ key: item.id, value: item.name })
        })

        // 獲取列表信息
        this.getlist()
      }
    });
  },

對於textarea常規的多行文本框,其實和普通單行文本框處理差不多,指定它的type=”textarea” 和 rows的數值即可。

  <el-tab-pane label="說明" name="second">
    <el-form-item label="說明">
      <el-input v-model="editForm.Description" type="textarea" :rows="10" />
    </el-form-item>
  </el-tab-pane>

而對於一些可能需要展示HTML內容的,我們可以使用DIV控件來展示,通過v-html標識來處理包含HTML代碼的內容。

  <el-tab-pane label="詳細說明">
    <el-form-item label="詳細說明">
      <div class="border-radius" v-html="viewForm.Note" />
    </el-form-item>
  </el-tab-pane>


3)、圖片展示

對於一些需要展示服務器圖片,我們請求后,根據Element圖片組件的設置處理即可,如下包括單個圖片和多個圖片的展示和預覽操作。

 圖片展示的代碼如下所示。

  <el-tab-pane label="圖片信息">
    <el-form-item label="封面圖片">
      <el-image
        style="width: 100px; height: 100px"
        :src="viewForm.Picture"
        :preview-src-list="[viewForm.Picture]"
      />
    </el-form-item>
    <el-form-item label="Banner圖片">
      <el-image
        style="width: 100px; height: 100px"
        :src="viewForm.Banner"
        :preview-src-list="[viewForm.Banner]"
      />
    </el-form-item>
    <el-form-item label="商品展示圖片">
      <el-image
        v-for="item in viewForm.pics"
        :key="item.key"
        class="border-radius"
        :src="item.pic"
        style="width: 100px; height: 100px;padding:10px"
        :preview-src-list="getPreviewPics()"
      />
    </el-form-item>
  </el-tab-pane>

上圖中,如果是單個圖片,那麼預覽我們設置一個集合為一個url即可,如 [viewForm.Banner],如果是多個圖片,需要通過一個函數來獲取圖片列表,如 getPreviewPics() 函數所示。

    getPreviewPics() {
      // 轉換ViewForm.pics裏面的pic集合
      var list = []
      if (this.viewForm.pics) {
        this.viewForm.pics.forEach(item => {
          if (item.pic) {
            list.push(item.pic)
          }
        })
      }
      return list
    }


※網頁設計最專業,超強功能平台可客製化

窩窩以「數位行銷」「品牌經營」「網站與應用程式」「印刷品設計」等四大主軸,為每一位客戶客製建立行銷脈絡及洞燭市場先機。

4)、第三方擴展控件

對於一些需要使用擴展組件的,我們一般搜索下解決方案,通過npm安裝對應的組件即可解決,如對於條碼和二維碼,我使用 @chenfengyuan/vue-barcode和 @chenfengyuan/vue-qrcode,一般在Github上搜索下關鍵字,總能找到一些很受歡迎的第三方組件。

  安裝這些組件都有具體的說明,如下所示(如果卸載,直接修改install為uninstall即可)。

npm install @chenfengyuan/vue-barcode vue

以及

npm install @chenfengyuan/vue-qrcode vue

條碼和二維碼的展示效果如下所示

如果全局引入barcode和qrcode 組件,我們在main.js裏面引入即可,如下代碼所示

// 引入barcode,qrcode
import VueBarcode from '@chenfengyuan/vue-barcode';
import VueQrcode from '@chenfengyuan/vue-qrcode';
Vue.component(VueBarcode.name, VueBarcode);


 富文本編輯,我這裏採用了 Tinymce 第三方組件來實現編輯處理,展示效果如下所示。

  代碼如下所示

  <el-tab-pane label="詳細說明" name="third">
    <el-form-item label="詳細說明">
      <tinymce v-model="editForm.Note" :height="300" />
    </el-form-item>
  </el-tab-pane>

以上就是一些常規的界面組件的使用,後面在繼續介紹文件上傳和圖片結合的操作。

3、自定義組件的創建使用

使用Vue的比以往BS開發的好處,就是可以很容易實現組件化,這點很好,一旦我們定義好一個控件,就可以在多個界面裏面進行使用,非常方便,而且封裝性可以根據自己的需要進行處理。

查詢區域一般的界面效果如下所示,除了包含一些常用的查詢條件,一般會有一些下拉列表,這些可能是後台字典裏面綁定的內容,可以考慮作為一個通用的字典下拉列表組件來做。

其實界面錄入的時候,也往往需要這些條件下拉列表的。

  那麼我們來定義一個自定義組件,並在界面上使用看看。

在Components目錄創建一個目錄,並創建一個組件的vue文件,命名為my-dictdata.vue,如下所示。

 界面模板代碼我們就一個select組件為主即可。

<template>
  <el-select v-model="svalue" filterable clearable placeholder="請選擇">
    <el-option
      v-for="(item, index) in dictItems"
      :key="index"
      :label="item.Text"
      :value="item.Value"
    />
  </el-select>
</template>

script腳本邏輯代碼如下所示。

<script>
// 引入API模塊類方法
import { GetDictData } from '@/api/dictdata'

export default {
  name: 'MyDictdata', // 組件的名稱
  props: {
    typeName: { // 字典類型方式,從後端字典接口獲取數據
      type: String,
      default: ''
    },
    options: {// 固定列表方式,直接綁定
      type: Array,
      default: () => { return [] }
    }
  },
  data() {
    return {
      dictItems: [], // 設置的字典列表
      svalue: '' // 選中的值
    }
  },
  watch: {
    // 判斷下拉框的值是否有改變
    svalue(val, oldVal) {
      if (val !== oldVal) {
        this.$emit('input', this.svalue);
      }
    }
  },
  mounted() {
    var that = this;

    if (this.typeName && this.typeName !== '') {
      // 使用字典類型,從服務器請求數據
      GetDictData(this.typeName).then(data => {
        if (data) {
          data.forEach(item => {
            if (item && typeof (item.Value) !== 'undefined' && item.Value !== '') {
              that.dictItems.push(item)
            }
          });
        }
      })
    } else if (this.options && this.options.length > 0) {
      // 使用固定字典列表
      this.options.forEach(item => {
        if (item && typeof (item.Value) !== 'undefined' && item.Value !== '') {
          that.dictItems.push(item)
        }
      });
    }
    // 設置默認值
    this.svalue = this.value;
  },
  methods: {

  }
}
</script>

主要就是處理字典數據的獲取,並綁定到模型對象上即可。

在頁面上使用前,需要引入我們定義的組件

import myDictdata from '@/components/Common/my-dictdata'

然後包含進去components裏面即可

export default {
  components: { myDictdata },

那麼原來需要直接使用select組件的代碼

<el-select v-model="searchForm.ProductType" filterable clearable placeholder="請選擇">
  <el-option
    v-for="(item, key) in typeList"
    :key="key"
    :label="item.value"
    :value="item.key"
  />
</el-select>

則可以精簡為一行代碼

<my-dictdata v-model="searchForm.ProductType" type-name="商品類型" />

而對於固定列表的,我們也可以通用的處理代碼

<my-dictdata v-model="searchForm.Status" :options="Status" />

其中Status是定義的一個對象集合

  Status: [
    { Text: '正常', Value: 0 },
    { Text: '推薦', Value: 1 },
    { Text: '停用', Value: 2 }
  ]

是不是非常方便,而得到的效果則不變。


 以上就是多個頁面內容,通過對話框層模式整合在一起,並介紹如何使用,以及對界面中常見的Element組件進行介紹如何使用,以及定義一個字典列表的主定義組件,用於簡化界面代碼使用,


列出以下前面幾篇隨筆的連接,供參考:

循序漸進VUE+Element 前端應用開發(1)— 開發環境的準備工作

循序漸進VUE+Element 前端應用開發(2)— Vuex中的API、Store和View的使用

循序漸進VUE+Element 前端應用開發(3)— 動態菜單和路由的關聯處理

循序漸進VUE+Element 前端應用開發(4)— 獲取後端數據及產品信息頁面的處理

循序漸進VUE+Element 前端應用開發(5)— 表格列表頁面的查詢,列表展示和字段轉義處理


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※推薦評價好的iphone維修中心

擁有專業的維修技術團隊,同時聘請資深iphone手機維修專家,現場說明手機問題,快速修理,沒修好不收錢

設計模式之單例模式_貨運

※評比南投搬家公司費用收費行情懶人包大公開

搬家價格與搬家費用透明合理,不亂收費。本公司提供下列三種搬家計費方案,由資深專業組長到府估價,替客戶量身規劃選擇最經濟節省的計費方式

目錄:

  • 什麼是單例模式
  • 單例模式的應用場景
  • 單例模式的優缺點
  • 單例模式的實現
  • 總借

一、什麼是單例模式

  單例模式顧名思義就是只存在一個實例,也就是系統代碼中只需要一個對象的實例應用到全局代碼中,有點類似全局變量。例如,在系統運行時,系統需要讀取配置文件中的參數,在設計系統的時候讀取配置文件的類往往設計成單例類。因為系統從啟動運行到結束,只需要讀取一次配置文件,這個讀取配置文件全部由該類負責讀取,在全局代碼中只需要使用該類即可。這樣不僅簡化了配置文件的管理,也避免了代碼讀取配置文件數據的不一致性。


 單例模式的特點:

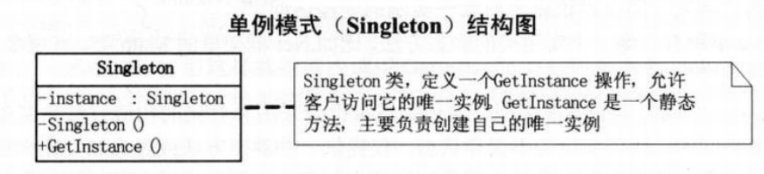
  1、該類的構造方法聲明為private,這樣其他類無法初始花該類,只能通過該類的public方法獲取該類的對象。

  2、裏面有個私有的對象成員,該成員對象是類本身,用於public方法返回該類的實例。

  3、該類中提供一個public的靜態方法,返回該類的私有成員對象。


二、單例的應用場景


  舉一個小例子,在我們的windows桌面上,我們打開了一個回收站,當我們試圖再次打開一個新的回收站時,Windows系統並不會為你彈出一個新的回收站窗口。,也就是說在整個系統運行的過程中,系統只維護一個回收站的實例。這就是一個典型的單例模式運用。


  繼續說回收站,我們在實際使用中並不存在需要同時打開兩個回收站窗口的必要性。假如我每次創建回收站時都需要消耗大量的資源,而每個回收站之間資源是共享的,那麼在沒有必要多次重複創建該實例的情況下,創建了多個實例,這樣做就會給系統造成不必要的負擔,造成資源浪費。


  再舉一個例子,網站的計數器,一般也是採用單例模式實現,如果你存在多個計數器,每一個用戶的訪問都刷新計數器的值,這樣的話你的實計數的值是難以同步的。但是如果採用單例模式實現就不會存在這樣的問題,而且還可以避免線程安全問題。同樣多線程的線程池的設計一般也是採用單例模式,這是由於線程池需要方便對池中的線程進行控制


  同樣,對於一些應用程序的日誌應用,或者web開發中讀取配置文件都適合使用單例模式,如HttpApplication 就是單例的典型應用。


  從上述的例子中我們可以總結出適合使用單例模式的場景和優缺點:  


   適用場景:

  1.需要生成唯一序列的環境

  2.需要頻繁實例化然後銷毀的對象。

  3.創建對象時耗時過多或者耗資源過多,但又經常用到的對象。 

  4.方便資源相互通信的環境


三、單例模式的優缺點

  優點:

    1、在內存中只有一個對象,節省內存空間;

※智慧手機時代的來臨,RWD網頁設計為架站首選

網動結合了許多網際網路業界的菁英共同研發簡單易操作的架站工具,及時性的更新,為客戶創造出更多的網路商機。

    2、避免頻繁的創建銷毀對象,可以提高性能;

    3、避免對共享資源的多重佔用,簡化訪問;

    4、為整個系統提供一個全局訪問點。

  缺點:

    1、不適用於變化頻繁的對象;

    2、濫用單例將帶來一些負面問題,如為了節省資源將數據庫連接池對象設計為的單例類,可能會導致共享連接池對象的程序過多而出現連接池溢出;

    3、如果實例化的對象長時間不被利用,系統會認為該對象是垃圾而被回收,這可能會導致對象狀態的丟失;


四、單例模式的實現

  1、餓漢式

public class Mgr{
    //創建自己的實例,並初始化私有靜態final成員
    private static final Mgr mgr = new Mgr();
    //私有構造方法
    private Mgr() {}; 
    //公共方法,返回自己的實例化成員
    public static Mgr getMgr() { 
        return  mgr;
    }
}

  備註:該單例實現方法簡單明了,推薦使用。該類被JVM加到內存的時候,只會加載一次,並且只實例化一個單例,優點是具有線程安全性,缺點是:不用他也在內存中實例化,浪費內存。所以提出了懶散式實現方式。

  2、懶漢式

public class Mgr{
   //聲明私有靜態對象成員,作為返回值
    private static Mgr mgr;
   //私有構造函數
    private Mgr() {}; 
   //懶漢的特點,提供公共靜態方法,如果該成員對象為空,實例化並返回
    public static Mgr getMgr() {
        if(mgr == null){
            mgr =  = new Mgr();
        }
         return  mgr;
     }
}

  備註:(不推薦用)這種實現方法只有程序在調用該類的getMgr方法才實例話對象並返回,特點就是調用的時候再實例化並返回,延遲加載的被動形式。但是該實現方法不是線程安全的,因為當同時有有兩個線程執行到if(mgr==null)語句的時候,由於某些原因其中一個線程先一步執行下一句,實例化了對象並返回;兩一個線程再實例化對象在返回,這兩個線程返回的對象不是同一個對象(這難道還是單例嗎!),所以該實現方法的缺點也很明顯。那為了避免線程不安全問題,在懶漢寫法上提出加鎖的實現方式。

  3、給公共方法加鎖

public class Mgr{
    //聲明私有靜態對象成員,作為返回值
    private static Mgr mgr;
    //私有構造函數
    private Mgr() {}; 
    //給公共方法加鎖,只有一個線程第一次獲得鎖實例化對象並返回
    public static syncnronized Mgr getMgr() {
        if(mgr == null){
            mgr = new Mgr();
        }
        return  mgr;
   }
}

  備註:(推薦使用)這種實現方式比較完善,既保證了懶散式的延遲加載方式,也保證了線程安全。缺點是在整個方法上加鎖,導致性能下降。因為只有第一次獲得鎖的線程實例化對象並返回,以後的線程獲得鎖的時候執行 if(mgr == null)語句的時候,由於mgr已經實例化了不為空,直接跳過返回實例。整個過程要競爭鎖,不能併發執行導致性能下降。那為優化性能下降問題,那我只在mgr = new Mgr()上加鎖,保證鎖粒度最小化的同時保證單例實例化。

  4、給實例化加鎖

public class Mgr{
    //私有靜態成員對象
    private static Mgr mgr;
    //私有構造函數
    private Mgr() {}; 
    //公共方法,在實例化語句塊加鎖,保證單例
    public static  Mgr getMgr() {
        if(mgr == null){
            syncnronized(Mgr.class){
                mgr = new Mgr();
            }
        }
         return  mgr;
  }
}

  備註:(不推薦使用)該實現方法雖然相較方法3性能有所提升,但並不能保證線程安全。因為當兩個線程同時執行if(mgr == null)語句時,其中線程1獲取鎖,實例化對象並返回,線程2在獲得鎖又在實例化對象並返回。線程1和線程2獲取的對象並不是同一個。所以在此基礎上提出了雙重判斷方式。

5、雙重判斷加鎖

public class Mgr{
    //私有靜態成員對象
    private static  Mgr mgr;
    //私有構造函數
    private Mgr() {}; 
    //公共方法提供雙重判斷並在實例化代碼塊加鎖
    public static  Mgr getMgr() {
        if(mgr == null){ //第一次判斷
            syncnronized(Mgr.class){
                if(mgr == null){ //第二次判斷
                    mgr =  = new Mgr();
                }      
            }
        }
         return  mgr;
  }
}

  備註:(推薦使用)相較於方法4,該方法雙重判定,如果多線程同時執行到第一次判斷語句位置,其中一個線程獲得鎖,由於是第一次該對象成員為空,實例化后並返回。其後其它線程調用公共方法的時候,由於實例化了,在第一次判斷自接返回實例,不在產生鎖競爭。大大提高了效率,保證了線程的安全性,也保證了延遲加載的特性。

 6、靜態內部類

public class Mgr{
    private Mgr() {};
    //定義靜態內部類
    private static class MgrHolder{
        private final static Mgr mgr = new Mgr();
    } 
    //公共方法直接返回靜態內部類的實例對象
    public static  Mgr getMgr() {
        return  MgrHolder.mgr;
  }
}

  備註:(可使用)該實現方法通過JVM來保證線程安全性,靜態內部類MgrHolder來New一個Mgr對象,JVM只會加載一次Mgr類(靜態內部類不會加載),當類調用getMgr方法的時候,也只會調用一次,公共方法調用靜態內部類,獲取一個對象(也是實現懶加載)。所以也是線程安全的。

7、枚舉類單例模式

public enum Mgr{
    mgr;
    public void m(){} //業務方法
}

  備註:(推薦使用)jdk1.5之後才能正常達到單例效果,參考來自《Effective Java》。注意枚舉類的枚舉變量必須寫在第一行,後面實現業務代碼。調用方式是:Mgr.mgr.Function_Name();具備枚舉類型的特點,有點是:線程同步,防止反序列化。

五、總結

  通過上面幾種單例模式的實現方式的列舉,但是在實際應用中其中的2,3,4三種方式並不適用,列出來只是讓讀者更好的理解方式5的由來,起到拋磚引玉的作用,更好的理解單例模式。總之常用的四種,懶漢,雙重校驗鎖,靜態內部類,枚舉單例。

  餓漢:類加載的時候就創建實例,所以是線程安全的,但不能延遲加載。

  雙重校驗鎖:線程安全,效率較高,延遲加載。

  靜態內部類:實現起來比較麻煩,在不同的編譯器上會出現不可預知的錯誤。

  枚舉單例:很好,不僅避免了多線程同步問題,而且能反正反序列化重新創建對象,但是不能延遲加載,用的人少。


  • 讀者發現有什麼有問題的地方謝謝留言指正。部分參考自:https://www.cnblogs.com/xuwendong/p/9633985.html#_label0


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※回頭車貨運收費標準

宇安交通關係企業,自成立迄今,即秉持著「以誠待人」、「以實處事」的企業信念

Keycloak快速上手指南,只需10分鐘即可接入Spring Boot/Vue前後端分離應用實現SSO單點登錄_網頁設計公司

※網頁設計公司推薦不同的風格,搶佔消費者視覺第一線

透過選單樣式的調整、圖片的縮放比例、文字的放大及段落的排版對應來給使用者最佳的瀏覽體驗,所以不用擔心有手機版網站兩個後台的問題,而視覺效果也是透過我們前端設計師優秀的空間比例設計,不會因為畫面變大變小而影響到整體視覺的美感。

登錄及身份認證是現代web應用最基本的功能之一,對於企業內部的系統,多個系統往往希望有一套SSO服務對企業用戶的登錄及身份認證進行統一的管理,提升用戶同時使用多個系統的體驗,Keycloak正是為此種場景而生。本文將簡明的介紹Keycloak的安裝、使用,並給出目前較流行的前後端分離應用如何快速接入Keycloak的示例。

Keycloak是什麼

Keycloak是一種面向現代應用和服務的開源IAM(身份識別與訪問管理)解決方案

Keycloak提供了單點登錄(SSO)功能,支持OpenID Connect、OAuth 2.0、SAML 2.0標準協議,擁有簡單易用的管理控制台,並提供對LDAP、Active Directory以及Github、Google等社交賬號登錄的支持,做到了非常簡單的開箱即用。

Keycloak常用核心概念介紹

首先通過官方的一張圖來了解下整體的核心概念

這裏先只介紹4個最常用的核心概念:

  1. Users: 用戶,使用並需要登錄系統的對象

  2. Roles: 角色,用來對用戶的權限進行管理

  3. Clients: 客戶端,需要接入Keycloak並被Keycloak保護的應用和服務

  4. Realms: 領域,領域管理着一批用戶、證書、角色、組等,一個用戶只能屬於並且能登陸到一個域,域之間是互相獨立隔離的, 一個域只能管理它下面所屬的用戶

Keycloak服務安裝及配置

安裝Keycloak

Keycloak安裝有多種方式,這裏使用Docker進行快速安裝

docker run -d --name keycloak \
    -p 8080:8080 \
    -e KEYCLOAK_USER=admin \
    -e KEYCLOAK_PASSWORD=admin \
    jboss/keycloak:10.0.0

訪問http://localhost:8080並點擊Administration Console進行登錄

創建Realm

創建一個新的realm: demo,後續所有的客戶端、用戶、角色等都在此realm中創建

創建客戶端

創建前端應用客戶端

創建一個新的客戶端:vue-demo,Access Type選擇public

創建後端應用客戶端

創建一個新的客戶端:spring-boot-demo,Access Type選擇bearer-only

保存之後,會出現Credentials的Tab,記錄下這裏的secret,後面要用到

關於客戶端的訪問類型(Access Type)

上面創建的2個客戶端的訪問類型分別是public、bearer-only,那麼為什麼分別選擇這種類型,實際不同的訪問類型有什麼區別呢?

※想知道購買電動車哪裡補助最多?台中電動車補助資訊懶人包彙整

節能減碳愛地球是景泰電動車的理念,是創立景泰電動車行的初衷,滿意態度更是服務客戶的最高品質,我們的成長來自於你的推薦。

事實上,Keycloak目前的訪問類型共有3種:

confidential:適用於服務端應用,且需要瀏覽器登錄以及需要通過密鑰獲取access token的場景。典型的使用場景就是服務端渲染的web系統。

public:適用於客戶端應用,且需要瀏覽器登錄的場景。典型的使用場景就是前端web系統,包括採用vue、react實現的前端項目等。

bearer-only:適用於服務端應用,不需要瀏覽器登錄,只允許使用bearer token請求的場景。典型的使用場景就是restful api。

創建用戶和角色

創建角色

創建2個角色:ROLE_ADMIN、ROLE_CUSTOMER

創建用戶

創建2個用戶:admin、customer

綁定用戶和角色

給admin用戶分配角色ROLE_ADMIN

給customer用戶分配角色ROLE_CUSTOMER

Vue應用集成Keycloak簡明指南

創建vue項目

vue create vue-demo

添加官方Keycloak js適配器

npm i keycloak-js --save
npm i axios --save

main.js

import Vue from 'vue'
import App from './App.vue'
import Keycloak from 'keycloak-js'

Vue.config.productionTip = false

// keycloak init options
const initOptions = {
  url: 'http://127.0.0.1:8080/auth',
  realm: 'demo',
  clientId: 'vue-demo',
  onLoad:'login-required'
}

const keycloak = Keycloak(initOptions)

keycloak.init({ onLoad: initOptions.onLoad, promiseType: 'native' }).then((authenticated) =>{
  if(!authenticated) {
    window.location.reload();
  } else {
    Vue.prototype.$keycloak = keycloak
    console.log('Authenticated')
  }

  new Vue({
    render: h => h(App),
  }).$mount('#app')

  setInterval(() =>{
    keycloak.updateToken(70).then((refreshed)=>{
      if (refreshed) {
        console.log('Token refreshed');
      } else {
        console.log('Token not refreshed, valid for '
            + Math.round(keycloak.tokenParsed.exp + keycloak.timeSkew - new Date().getTime() / 1000) + ' seconds');
      }
    }).catch(error => {
      console.log('Failed to refresh token', error)
    })
  }, 60000)

}).catch(error => {
  console.log('Authenticated Failed', error)
})

HelloWorld.vue

<template>
  <div class="hello">
    <h1>{{ msg }}</h1>
    <div>
      <p>
        current user: {{user}}
      </p>
      <p>
        roles: {{roles}}
      </p>
      <p>
        {{adminMsg}}
      </p>
      <p>
        {{customerMsg}}
      </p>
    </div>
  </div>
</template>

<script>
import axios from 'axios'

export default {
  name: 'HelloWorld',
  props: {
    msg: String
  },
  data() {
    return {
      user: '',
      roles: [],
      adminMsg: '',
      customerMsg: ''
    }
  },
  created() {
    this.user = this.$keycloak.idTokenParsed.preferred_username
    this.roles = this.$keycloak.realmAccess.roles

    this.getAdmin()
            .then(response=>{
              this.adminMsg = response.data
            })
            .catch(error => {
              console.log(error)
            })

    this.getCustomer()
            .then(response => {
              this.customerMsg = response.data
            })
            .catch(error => {
              console.log(error)
            })
  },
  methods: {
    getAdmin() {
      return axios({
        method: 'get',
        url: 'http://127.0.0.1:8082/admin',
        headers: {'Authorization': 'Bearer ' + this.$keycloak.token}
      })
    },
    getCustomer() {
      return axios({
        method: 'get',
        url: 'http://127.0.0.1:8082/customer',
        headers: {'Authorization': 'Bearer ' + this.$keycloak.token}
      })
    }
  }
}
</script>

getAdmin()及getCustomer()這2個方法內部分別請求restful api

Spring Boot應用集成Keycloak簡明指南

添加Keycloak Maven依賴

<dependency>
    <groupId>org.keycloak</groupId>
    <artifactId>keycloak-spring-boot-starter</artifactId>
    <version>10.0.0</version>
</dependency>

Spring Boot配置文件

官方文檔及網上大部分示例使用的都是properties格式的配置文件,而yaml格式的配置文件相對更簡潔清晰些,此示例使用yaml格式的配置文件,內容如下

server:
  port: 8082
keycloak:
  realm: demo
  auth-server-url: http://127.0.0.1:8080/auth
  resource: spring-boot-demo
  ssl-required: external
  credentials:
    secret: 2d2ab498-7af9-48c0-89a3-5eec929e462b
  bearer-only: true
  use-resource-role-mappings: false
  cors: true
  security-constraints:
    - authRoles:
        - ROLE_CUSTOMER
      securityCollections:
        - name: customer
          patterns:
            - /customer
    - authRoles:
        - ROLE_ADMIN
      securityCollections:
        - name: admin
          patterns:
            - /admin

除了幾個必填的配置項外,另外需要注意的幾個配置項如下

credentials.secret:上文添加客戶端后Credentials Tab內對應的內容

bearer-only:設置為true,表示此應用的Keycloak訪問類型是bearer-only

cors:設置為true表示允許跨域訪問

security-constraints:主要是針對不同的路徑定義角色以達到權限管理的目的

  • /customer:只允許擁有ROLE_CUSTOMER角色的用戶才能訪問
  • /admin:只允許擁有ROLE_ADMIN角色的用戶才能訪問
  • 未配置的路徑表示公開訪問

Controller內容

@RestController
public class HomeController {
    @RequestMapping("/")
    public String index() {
        return "index";
    }

    @RequestMapping("/customer")
    public String customer() {
        return "only customer can see";
    }

    @RequestMapping("/admin")
    public String admin() {
        return "only admin cas see";
    }
}

項目效果演示

分別啟動前後端項目后,本地8081端口對應vue前端項目,本地8082端口對應Spring Boot實現的restful api項目

首次訪問vue前端項目

第一次訪問vue項目會跳轉Keycloak登錄頁

登錄admin用戶

登錄customer用戶

總結

Keycloak部署及接入簡單,輕量的同時功能又不失強大,非常適合企業內部的SSO方案。

本文示例項目地址:keycloak-demo

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※南投搬家公司費用,距離,噸數怎麼算?達人教你簡易估價知識!

搬家費用:依消費者運送距離、搬運樓層、有無電梯、步行距離、特殊地形、超重物品等計價因素後,評估每車次單

算法講堂一:博弈論入門_租車

※廣告預算用在刀口上,台北網頁設計公司幫您達到更多曝光效益

有別於一般網頁架設公司,除了模組化的架站軟體,我們的營業主軸還包含:資料庫程式開發、網站建置、網頁設計、電子商務專案開發、系統整合、APP設計建置、專業網路行銷。

博弈論的題目有如下特點:

  • 1:博弈模型為兩人輪流決策的博弈。並且兩人都使用最優策略來取得勝利。

    • 兩個玩家,都會採取最優的決策,那麼如果存在一個局面為必勝局面,某玩家位於此局面。只要自己無失誤,則必勝。那麼同樣又一個局面為必敗局面,某玩家位於此局面。只要對手無失誤,則必敗。
    • 那也就是說,針對這樣的遊戲,我們關注點應該在局面上。
  • 2:博弈是有限的。即無論兩人如何決策,都會在有限步決出勝負。

  • 3:博弈是公平的。即兩人進行決策的規則相同。

  • 相關概念:
    • 先手必勝狀態:先手可以從這個狀態走到某一個必敗狀態。
    • 先手必敗狀態:先手走不到任何一個必敗狀態。
    • 也就是說先手必勝狀態,那麼先手一定能採取某些操作,讓後手面對必敗態。如果是先手必敗態,無論先手怎麼操作,都無法讓後手面對必敗態。

簡單博弈的基本題型

1:bash博弈;2:nim博弈;3:威佐夫博弈;5:Fibonacci博弈;6:sg函數;

bash博弈 (巴什博奕)

  • 假設一堆石子有n個,每次最多取m個,甲乙兩個玩家輪流取石子,最後把石子取完的人獲勝,保證甲乙每一步的決策都是最優的,請問給定n和m,問甲勝還是乙勝。

    • 不妨假設剛剛開始

      n = m + 1
      

      ,那麼後手必勝,有如下結論:

      • 令 n = ( m + 1 ) * r + s 其中(r > 1,0 <= s < m + 1)。如果s=0的話,先手每次取k個,後手只要取(m+1-k)個即可,後手必贏。如果s!=0的話,先手者第一次取s個,後手第一次取k個,接下來先手只要取(m + 1 - k)個即可,先手必贏。
      • 所以只需考慮 是否為0就可以判定結果。余為0,先手必敗,反之必勝。
  • 例題:

    • hdu_2188
    #include<bits/stdc++.h>
    using namespace std;
    int c, m, n;//總捐款數,每次最多m
    int main() {
        //freopen("in.txt","r",stdin);
    	cin >> c;
    	while (c--) {
    		cin >> n >> m;
    		if (n % (m + 1) == 0)
    			cout << "Rabbit\n";
    		else
    			cout << "Grass\n";
    	}
    	return 0;
    }
    
  • hdu_1846

  • hdu_1847

Nim遊戲

  • 假設有n堆石子,每堆石子分別有\(a_1,a_2,…,a_n個\),每次可以選擇任意一堆且至少取1枚石子, 甲乙兩個玩家輪流取石子, 最後把石子取完的人獲勝, 保證甲乙每一步的決策都是最優的, 甲為先手操作, 問甲勝還是乙勝。

  • 結論:

    • 設若\(a_1^{ ∧ }a_2^{∧}…^{∧}a_n = 0\)則先手必敗, 反之必勝。
  • 證明

  • 當\(a\)不全為\(0\)時, 任意一個\(res!=0\)的局面, 先手可以通過一定的操作讓後手面對\(res=0\)的局面。

  • 對於任意一個\(res=0\)的局面, 先手無法通過任何操作讓後手面對\(res=0\)的局面。

  • 得出結論, 當\(res=0\)時先手必敗, 反之必勝。

Nim博弈拓展-台階Nim

  • 問題描述: 有一個\(n\)級台階的樓梯, 每級台階上有若干個石子, 其中第i級台階上有\(ai\)個石子\((i≥1)\)。兩位玩家路輪流操作, 每次操作可以從任意一級台階上拿若干個石子放到下一級台階上(不能不拿)。

  • 已經拿到地面的石子不能再拿, 最後無法進行操作的人視為失敗。

  • 問如果兩人都採取最優策略, 先手是否必勝.

  • 結論
    • \(res=a_1∧a_3∧a_5∧,…,∧a_n=0\)(當然這裏的n是奇數)先手必敗, 反之先手必勝。
  • 證明
  • 1): 考慮極端情況, 當\(a1,a3,…,an\)全為0時, \(res=0\), 此時先手只能將偶數級台階往下搬, 後手只需要將先手從偶數級台階上搬下來的石子全部搬到下一級偶數級台階, 先手必敗。

  • 2): 當\(res=x≠0\)時, 通過經典\(Nim\)遊戲的證明, 我們知道一定有一種方法搬一定的石子到下一級讓後手面對res為0的局面。

  • 3):當\(res=x=0\)且\(a\)不全為\(0\)時, 我們無法通過任何操作讓下一個狀態的\(res\)也為\(0\)。

    ※Google地圖已可更新顯示潭子電動車充電站設置地點!!

    日本、大陸,發現這些先進的國家已經早就讓電動車優先上路,而且先進國家空氣品質相當好,電動車節能減碳可以減少空污

  • 即對於\(res\)不為\(0\)的情況, 先手總能通過一定的操作讓後手面對\(res\)為\(0\)的情況,。

  • 然而\(res\)為\(0\)時, 先手無論做什麼操作都無法讓後手面對\(res\)為\(0\)的情況。

  • 那麼此刻我們就將題目轉化為在奇數台階上的經典Nim遊戲。

  • 思考題:

  • 為什麼不用\(res=a_2∧a_4∧a_6∧,…,∧a_n=0\)(n為偶數)來判定勝負?

    • 因為當先手搬去一定的石子讓後手面對res=0res=0的情況, 後手可以搬去一號台階的石子到地面讓先手重新面對res=0res=0的情況
例題:
  • hdu_1850(經典Nim)
#include<bits/stdc++.h>
using namespace std;
const int maxn = 100 + 10;
int n, a[maxn], res;
int main() {
    //freopen("in.txt","r",stdin);
	while (cin >> n,n)
	{
		res = 0;
		for (int i = 1; i <= n; i++){
			cin >> a[i];
			res ^= a[i];
		}
		if (res == 0) puts("0");
		else{
			int ans = 0;
			for (int i = 1; i <= n; i++)
				if ((res ^ a[i]) < a[i]) ans++;
			cout << ans << endl;
		}
	}
	return 0;
}
  • hdu_1730(經典Nim)
#include<bits/stdc++.h>
using namespace std;
int main() {
	//freopen("in.txt","r",stdin);
	int n, m;
	while (cin >> n >> m) {
		int res = 0;
		for (int i = 1; i <= n; ++i) {
			int a, b; cin >> a >> b;
			res = res ^ (abs(a - b) - 1);
		}
		if (res == 0) puts("BAD LUCK!");
		else puts("I WIN!");
	}
	return 0;
}
  • poj_1704(台階Nim)
#include<iostream>
#include<cstdio>
#include<algorithm>
using namespace std;
const int N = 1000 + 10;
int a[N];
int main() {
	//freopen("in.txt", "r", stdin);
	int t, n;
	cin >> t;
	while (t--) {
		int ans = 0;
		cin >> n;
		for (int i = 1; i <= n; ++i) cin >> a[i];
		sort(a + 1, a + n + 1);
		if (n % 2)
		{
			ans ^= (a[1] - 1);
			for (int i = 3; i <= n; i += 2)
				ans ^= (a[i] - a[i - 1] - 1);
		}
		else for (int i = 2; i <= n; i += 2)
			ans ^= (a[i] - a[i - 1] - 1);
		if (ans) printf("Georgia will win\n");
		else printf("Bob will win\n");
	}
	return 0;
}
  • hdu_4315(台階Nim)
#include<bits/stdc++.h> 
using namespace std;
const int maxn = 1e3 + 10;
int a[maxn];
int n, k;
int main() {
    //freopen("in.txt","r",stdin);
    while(cin >> n >> k)
    {
        memset(a, 0, sizeof a);
        for(int i = 1; i <= n; i++) scanf("%d", &a[i]);
        if(k == 1) puts("Alice");
        else
        {
            int res = 0;
            if(n & 1)
            {
                if(k == 2) res ^= a[1] - 1;
                else res ^= a[1];
                for(int i = 3; i <= n; i += 2)
                    res ^= a[i] - a[i - 1] - 1;
            }
            else
            {
                for(int i = 2; i <= n; i += 2)
                    res ^= a[i] - a[i - 1] - 1;
            }
            if(res) puts("Alice");
            else puts("Bob");
        }
    }
    return 0;
}

Wythoff 遊戲 (威佐夫博弈)

  • 兩堆石子各有若干個, 兩人輪流從一堆取至少一個石子或從兩堆取同樣多的物品, 最後一名取完石子者勝利。

  • 結論:

    • 當兩堆石子各有\(n\)和\(m\)個且不妨設\(n<m\)。
    • 當(m−n)(√5+1)/2=n時, 先手必敗。
  • 證明
  • •首先考慮最(zhao)極(gui)端(lv)的情況, (0, 0), (1, 2), (3, 5)局面為先手必敗局面。而且這樣的数字對被稱為奇異局勢。

  • 奇異局勢的定義如下:

    • 設数字對為\(a[(i),b(i)]\)
    • 1:\(a(0)=b(0)=0\);
    • 2: \(a(k)\)是前面数字對中未出現的最小的自然數, 且\(a(k)+k=b(k)\)。
  • 接下來我們看奇異局勢的幾個性質:

    • 性質1: 任何自然數都包含在一個且僅有一個奇異局勢中。

    • 性質2: 任意操作都能將奇異局勢轉變為非奇異局勢.

    • 性質3: 採取適當的方法, 可將非奇異局勢轉變為奇異局勢。

      證明略

  • 結論:奇異局勢必敗
例題
  • hdu_2177
#include<bits/stdc++.h> 
using namespace std;
int n, m;
    
bool check(int n, int m) {
    int x = min(n, m), y = max(n, m);
    double c = (sqrt(5.00000) + 1) / 2;
    double d = (double)(y - x);
    if(x == int(c*d)) return 1; // 必敗     return 0;
}
    
void work() {
    if(n > m) swap(n, m); // (n, m)     //第一個模塊 我們能一起減去讓他成為必敗態     {
        int tem = m - n;
        double c = (sqrt(5.00000) + 1) / 2;
        int a = double(tem) * c;
        int b = a + tem;
        if(n - a == m - b) cout << a << " " << b << endl;
    }
    //第二個模塊 我們求出當前n的奇異局勢, 如果m比他大 拿走就行     //如果m比他小我們求出(x, n) 然後拿走m     {
        double c = (sqrt(5.00000) + 1) / 2;
        int x = n;
        double d = x / c;
        int y = n + d;
        if(m > y) cout << x << " " << y << endl;
        else
        {
            double x = double(n) * 2 / (sqrt(5.000000) + 1);
            cout << int(x) << " " << n << endl;
        }
    }
}
    
int main() {
    while(cin >> n >> m)
    {
        if(!(n + m)) break;
        if(check(n, m)) puts("0");
        else
        {
            puts("1");
            work();
        }
    }
    return 0;
}
    

斐波那契博弈(Fibonacci Nim Game)

  • 一堆石子有nn個,兩人輪流取.先取者第1次可以取任意多個,但不能全部取完。以後每次取的石子數不能超過上次取子數的22倍。取完者勝。給定nn,問先手必勝還是必敗。

  • 結論:
    • 當\(n\)為\(fibonacci\)數的時候,先手必敗
  • 證明:

例題:

  • hdu_2516
#include<bits/stdc++.h> using namespace std;
typedef long long ll;
unordered_map<int, int> mp;
ll f[50];
void fib() {
    f[0] = f[1] = 1;
    for(int i = 2; i <= 50; i++)
    {
        f[i] = f[i - 1] + f[i - 2];
        mp[f[i]]++;
    }
}
    
int main() {
    int n;fib();
    while(cin >> n)
    {
        if(n == 0)break;
        if(!mp[n]) puts("First win");
        else puts("Second win"); //如果是fibonacci數, 則先手必敗
    return 0;
}

SG函數

  • \(mex\)運算:
    • 定義\(mex(S)\)為不屬於集合S的最小非負整數運算。
    • •舉個栗子: \(S=1,2,3,mex(s)=0\);
  • SG函數:
    • •\(SG\)函數: 設對於每個節點x, 設從x出發有k條有向邊分別到達節點\(y1,y2,…,yk\), 定義SG(x)函數為後繼節點\(y1,y2,…,yk\)的SG函數值構成的集合再執行mex運算的結果。
    • 特別的, 整個有向圖GG的SGSG函數被定義為有向圖起點s的SG函數值, 即\(SG(G)=SG(s)\)
    • 有向圖終點的SG函數為0。
  • 結論:
    • •先手必敗, 則該局面對應\(SG函數=0\)。反之必勝。
例題
  • hdu_1524
#include<bits/stdc++.h> using namespace std;
const int maxn = 1e3 + 10;
int n, num;
int sg[maxn];
    
int head[maxn], ver[maxn], nex[maxn], tot;
void add(int x, int y) {
    ver[++tot] = y; nex[tot] = head[x]; head[x] = tot;
}
    
int GetSg(int x) {
    if(sg[x] != -1) return sg[x];
    bool vis[maxn];
    memset(vis, 0, sizeof(vis));
    for(int i = head[x]; i; i = nex[i]) // 掃描所有出邊     {
        int y = ver[i];
        sg[y] = GetSg(y);
        vis[sg[y]] = 1; //所有出邊的sg函數值     }
    for(int i = 0; i < n; i++)
        if(!vis[i]) return sg[x] = i; // mex運算     return 0;
}
    
void init() {
    memset(head, 0, sizeof(head));
    memset(nex, 0, sizeof nex);
    memset(ver, 0, sizeof ver);
    memset(sg, -1, sizeof sg);
    tot = 0;
}
    
int main() {
    while(cin >> n)
    {
        init();
        for(int i = 0; i < n; i++)
        {
            cin >> num;
            while(num--)
            {
                int x; scanf("%d", &x);
                add(i, x);
            }
        }
        while(cin >> num)
        {
            if(!num) break;
            int res = 0;
            while(num--)
            {
                int x; scanf("%d", &x);
                res ^= GetSg(x);
            }
            if(res) puts("WIN");
            else puts("LOSE");
        }
    }
    return 0;
}
  • hdu_1536
#include<bits/stdc++.h>
using namespace std;
const int maxn = 1e4 + 10;
int s[maxn], sg[maxn];
int k;
    
void init() {
    memset(sg, -1, sizeof(sg));
}
    
int GetSg(int x) {
    if(sg[x] != -1) return sg[x];
    bool vis[maxn]; memset(vis, 0, sizeof(vis));
    for(int i = 1; i <= k; i++)
        if(x >= s[i])
        {
            sg[x - s[i]] = GetSg(x - s[i]);
            vis[sg[x - s[i]]] = 1;
        }
    for(int i = 0; ; i++)
        if(!vis[i]) return sg[x] = i;
    return 0;
    
}
    
int main() {
    ios::sync_with_stdio(false);
    while(cin >> k)
    {
        init();
        if(k == 0) break;
        for(int i = 1; i <= k; i++) cin >> s[i];
        int num; cin >> num;
        while(num--)
        {
            int x, res = 0; cin >> x;
            for(int i = 1; i <= x; i++)
            {
                int y; cin >> y;
                res ^= GetSg(y);
            }
            if(res) cout << "W";
            else cout << "L";
        }
        cout << endl;
    }
    return 0;
}

參考

【博弈論】關於三姬分金(五海盜分贓)的博弈論問題分析

李永樂老師對三姬分金視頻講解

ACM集訓隊講解

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理

※超省錢租車方案

商務出差、學生出遊、旅遊渡假、臨時用車!GO 神州租賃有限公司!合法經營、合法連鎖、合法租賃小客車!