【控制系統数字仿真與CAD】實驗三:離散相似法数字仿真

一、實驗目的
  1. 了解離散相似法的基本原理
  2. 掌握離散相似法仿真的基本過程
  3. 應用離散相似法仿真非線性系統
  4. MATLAB實現離散相似法的非線性系統仿真
  5. 掌握SIMULINK仿真方法,應用於非線性系統的仿真,並對實驗結果進行分析比較

二、實驗原理

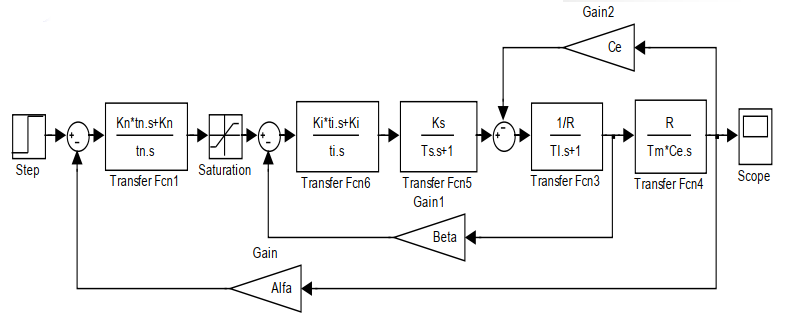
  在ASR的輸出增加限幅裝置(飽和非線性,飽和界為c=8 )。 Ce=0.031,其它參數不變。輸入為單位階躍,用離散相似法求系統各環節的輸出。

  要求:採用零階保持器和一階保持器離散化系統,分別完成本實驗。

  1、各環節的參數:

  由5個典型環節組成:

  A=[0 0 1 1 0];

  B=[tn ti Ts Tl Tm*Ce];
  C=[Kn Ki Ks 1/R R];
  D=[Kn*tn Ki*ti 0 0 0];

  還有一飽和非線性環節:c=8;

  2、各環節的離散化係數矩陣

 3、各環節的輸入作用


    (1)、u(n)可通過聯接矩陣直接求得: 


      u(n)=[u1(n), u2(n),…,un(n)]為各環節的輸入量, n為環節數。 Y(n)=[Y1(n), Y2(n),…,Yn(n)]為各環節的輸出量, r為外中參考輸入量。

    (2)、U(n)由近似表達式求得:
      

    (3)、u(n+1)用折線法近似求得:


  4、狀態和輸出計算

    (1)、一階保持器
      X=FI’.*X+FIM’.*Uk+FIJ’.*Udot;
      Y=FIC’.*X+FID’.*Uf;
    (2)、零階保持器
      X=FI’.*X+FIM’.*Uk;
      Y=FIC’.*X+FID’.*Uf;

  5、飽和非線性環節

  看作環節1(ASR)的一部分。建立satur.m文件:

function [uo]=satur(ui,c)
    if (abs(ui)<=c)
        uo=ui;
    elseif ( ui > c )
        uo = c;
    else
        uo=-c;
    end
end

 三、實驗過程

  1、新建腳本文件,命名為satur.m

function [uo]=satur(ui,c)
    if (abs(ui)<=c)
        uo=ui;
    elseif ( ui > c )
        uo = c;
    else
        uo=-c;
    end
end

  2、新建腳本文件,命名為test3.m

  完整代碼:

clc;
clear;
% ******  各環節參數  ****** %
Kn=26.7;
tn=0.03;
Ki=0.269;
ti=0.067;
Ks=76;
Ts=0.00167;
R=6.58;
T1=0.018;
Tm=0.25;
Ce=0.031;
Alpha=0.00337;
Beta=0.4;
A=[0 0 1 1 0];
B=[tn ti Ts T1 Tm*Ce];
C=[Kn Ki Ks 1/R R];
D=[Kn*tn Ki*ti 0 0 0];
c=8;
r=1;
W=[0 0 0 0 -Alpha;
    1 0 0 -Beta 0;
    0 1 0 0 0;
    0 0 1 0 -Ce;
    0 0 0 1 0];
W0=[1 0 0 0 0]';
h=0.001;
t_end=0.5;
t=0:h:t_end;
n=length(t);
% ******  各環節離散化係數  ****** %
block_num=5;
for k=1:block_num
    if(A(k)==0)
        FI(k)=1;
        FIM(k)=h*C(k)/B(k);
        FIJ(k)=h*h*C(k)/B(k)/2;
        FIC(k)=1;
        FID(k)=0;
        if(D(k)~=0)
            FID(k)=D(k)/B(k);
        end
    else
        FI(k)=exp(-h*A(k)/B(k));
        FIM(k)=(1-FI(k))*C(k)/A(k);
        FIJ(k)=h*C(k)/A(k)-FIM(k)*B(k)/A(k);
        FIC(k)=1;
        FID(k)=0;
        if(D(k)~=0)
            FIC(k)=C(k)/D(k)-A(k)/B(k);
            FID(k)=D(k)/B(k);
        end
    end
end

Y0=[0 0 0 0 0]';
Y=Y0;
X=zeros(block_num,1);
result1=Y;
Uk=zeros(block_num,1);
Ub=Uk;

for m=1:(n-1)
    Ub=Uk;
    Uk=W*Y+W0*r;
    Uf=2*Uk-Ub;
    Udot=(Uk-Ub)/h;
    
    %******  零階保持器  ******%
    X=FI'.*X+FIM'.*Uk;
    Y=FIC'.*X+FID'.*Uf;
    
    Y(1)=satur(Y(1),c);
    result1=[result1,Y];
end

Y0=[0 0 0 0 0]';
Y=Y0;
X=zeros(block_num,1);
result2=Y;
Uk=zeros(block_num,1);
Ub=Uk;
for m=1:(n-1)
    Ub=Uk;
    Uk=W*Y+W0*r;
    Uf=2*Uk-Ub;
    Udot=(Uk-Ub)/h;
    
    %******  一階保持器  ******%
    X=FI'.*X+FIM'.*Uk + FIJ'.*Udot;
    Y=FIC'.*X + FID'.*Uf;
    
    Y(1)=satur(Y(1),c);
    result2=[result2,Y];
end

plot(t,result1(5,:),’-.’,t,result2(5,:),’–‘,t,ScopeData.signals.values,’k’);
legend(‘零階保持器’,’一階保持器’,’Simulink’);

  3、在Simulink中繪製仿真圖


 注意:Simulink中的變量名和工作區變量關聯方法請點擊:https://www.cnblogs.com/KaifengGuan/p/11942615.html

四、實驗結果


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品在網路上成為最夯、最多人討論的話題?

※高價收購3C產品,價格不怕你比較

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選
微服務中的Kafka與Micronaut

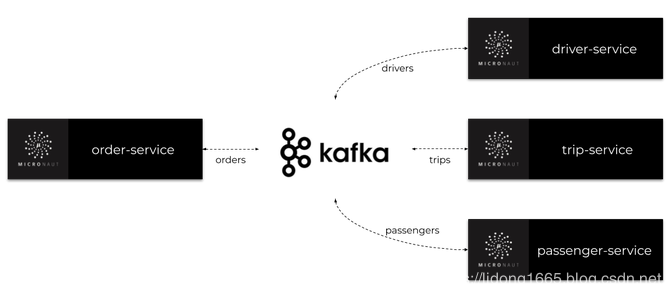
今天,我們將通過Apache Kafka主題構建一些彼此異步通信的微服務。我們使用Micronaut框架,它為與Kafka集成提供專門的庫。讓我們簡要介紹一下示例係統的體繫結構。我們有四個微型服務:訂單服務,行程服務,司機服務和乘客服務。這些應用程序的實現非常簡單。它們都有內存存儲,並連接到同一個Kafka實例。

我們系統的主要目標是為客戶安排行程。訂單服務應用程序還充當網關。它接收來自客戶的請求,保存歷史記錄並將事件發送到orders主題。所有其他微服務都在監聽orders這個主題,並處理order-service發送的訂單。每個微服務都有自己的專用主題,其中發送包含更改信息的事件。此類事件由其他一些微服務接收。架構如下圖所示。

在閱讀本文之前,有必要熟悉一下Micronaut框架。您可以閱讀之前的一篇文章,該文章描述了通過REST API構建微服務通信的過程:。

1 運行Kafka

要在本地機器上運行Apache Kafka,我們可以使用它的Docker映像。最新的鏡像是由共享的。在啟動Kafka容器之前,我們必須啟動kafka所用使用的ZooKeeper服務器。如果在Windows上運行Docker,其虛擬機的默認地址是192.168.99.100。它還必須設置為Kafka容器的環境。

Zookeeper和Kafka容器都將在同一個網絡中啟動。在docker中運行Zookeeper以zookeeper的名稱提供服務,並在暴露2181端口。Kafka容器需要在環境變量使用KAFKA_ZOOKEEPER_CONNECT的地址。

$ docker network create kafka
$ docker run -d --name zookeeper --network kafka -p 2181:2181 wurstmeister/zookeeper
$ docker run -d --name kafka -p 9092:9092 --network kafka --env KAFKA_ADVERTISED_HOST_NAME=192.168.99.100 --env KAFKA_ZOOKEEPER_CONNECT=zookeeper:2181 wurstmeister/kafka

2 添加micronaut-kafka依賴

使用Kafka構建的microaut應用程序可以在HTTP服務器存在的情況下啟動,也可以在不存在HTTP服務器的情況下啟動。要啟用Micronaut Kafka,需要添加micronaut-kafka庫到依賴項。如果您想暴露HTTP API,您還應該添加micronaut-http-server-netty:

<dependency>
    <groupId>io.micronaut.configuration</groupId>
    <artifactId>micronaut-kafka</artifactId>
</dependency>
<dependency>
    <groupId>io.micronaut</groupId>
    <artifactId>micronaut-http-server-netty</artifactId>
</dependency>

3 構建訂單微服務

訂單微服務是唯一一個啟動嵌入式HTTP服務器並暴露REST API的應用程序。這就是為什麼我們可以為Kafka提供內置Micronaut健康檢查。要做到這一點,我們首先應該添加micronaut-management依賴:

<dependency>
    <groupId>io.micronaut</groupId>
    <artifactId>micronaut-management</artifactId>
</dependency>

為了方便起見,我們將通過在application.yml中定義以下配置來啟用所有管理端點並禁用它們的HTTP身份驗證。

endpoints:
  all:
    enabled: true
    sensitive: false

現在,可以在地址欄下使用health check。我們的示例應用程序還將暴露添加新訂單和列出所有以前創建的訂單的簡單REST API。下面是暴露這些端點的Micronaut控制器實現:

@Controller("orders")
public class OrderController {

    @Inject
    OrderInMemoryRepository repository;
    @Inject
    OrderClient client;

    @Post
    public Order add(@Body Order order) {
        order = repository.add(order);
        client.send(order);
        return order;
    }

    @Get
    public Set<Order> findAll() {
        return repository.findAll();
    }

}

每個微服務都使用內存存儲庫實現。以下是訂單微服務(Order-Service)中的存儲庫實現:

@Singleton
public class OrderInMemoryRepository {

    private Set<Order> orders = new HashSet<>();

    public Order add(Order order) {
        order.setId((long) (orders.size() + 1));
        orders.add(order);
        return order;
    }

    public void update(Order order) {
        orders.remove(order);
        orders.add(order);
    }

    public Optional<Order> findByTripIdAndType(Long tripId, OrderType type) {
        return orders.stream().filter(order -> order.getTripId().equals(tripId) && order.getType() == type).findAny();
    }

    public Optional<Order> findNewestByUserIdAndType(Long userId, OrderType type) {
        return orders.stream().filter(order -> order.getUserId().equals(userId) && order.getType() == type)
                .max(Comparator.comparing(Order::getId));
    }

    public Set<Order> findAll() {
        return orders;
    }

}

內存存儲庫存儲Order對象實例。Order對象還被發送到名為orders的Kafka主題。下面是Order類的實現:

public class Order {

    private Long id;
    private LocalDateTime createdAt;
    private OrderType type;
    private Long userId;
    private Long tripId;
    private float currentLocationX;
    private float currentLocationY;
    private OrderStatus status;
    
    // ... GETTERS AND SETTERS
}

4 使用Kafka異步通信

現在,讓我們想一個可以通過示例係統實現的用例—— 添加新的行程。

我們創建了OrderType.NEW_TRIP類型的新訂單。在此之後,(1) 訂單服務創建一個訂單並將其發送到orders主題。訂單由三個微服務接收: 司機服務、乘客服務和行程服務。
(2)所有這些應用程序都處理這個新訂單。乘客服務應用程序檢查乘客帳戶上是否有足夠的資金。如果沒有,它就取消了行程,否則它什麼也做不了。司機服務正在尋找最近可用的司機,(3) 行程服務創建和存儲新的行程。司機服務和行程服務都將事件發送到它們的主題( drivers, trips),其中包含相關更改的信息。

每一個事件可以被其他microservices訪問,例如,(4) 行程服務偵聽來自司機服務的事件,以便為行程分配一個新的司機

下圖說明了在添加新的行程時,我們的微服務之間的通信過程。

現在,讓我們繼續討論實現細節。

4.1 發送訂單

首先,我們需要創建Kafka客戶端,負責向主題發送消息。我們創建的一個接口,命名為OrderClient,為它添加@KafkaClient並聲明用於發送消息的一個或多個方法。每個方法都應該通過@Topic註解設置目標主題名稱。對於方法參數,我們可以使用三個註解@KafkaKey、@Body或@Header。@KafkaKey用於分區,這是我們的示例應用程序所需要的。在下面可用的客戶端實現中,我們只使用@Body註解。

@KafkaClient
public interface OrderClient {

    @Topic("orders")
    void send(@Body Order order);

}

4.2 接收訂單

一旦客戶端發送了一個訂單,它就會被監聽orders主題的所有其他微服務接收。下面是司機服務中的監聽器實現。監聽器類OrderListener應該添加@KafkaListener註解。我們可以聲明groupId作為一個註解參數,以防止單個應用程序的多個實例接收相同的消息。然後,我們聲明用於處理傳入消息的方法。與客戶端方法相同,應該通過@Topic註解設置目標主題名稱,因為我們正在監聽Order對象,所以應該使用@Body註解——與對應的客戶端方法相同。

@KafkaListener(groupId = "driver")
public class OrderListener {

    private static final Logger LOGGER = LoggerFactory.getLogger(OrderListener.class);

    private DriverService service;

    public OrderListener(DriverService service) {
        this.service = service;
    }

    @Topic("orders")
    public void receive(@Body Order order) {
        LOGGER.info("Received: {}", order);
        switch (order.getType()) {
            case NEW_TRIP -> service.processNewTripOrder(order);
        }
    }

}

4.3 發送到其他主題

現在,讓我們看一下司機服務中的processNewTripOrder方法。DriverService注入兩個不同的Kafka Client
bean: OrderClient和DriverClient。當處理新訂單時,它將試圖尋找與發送訂單的乘客最近的司機。找到他之後,將該司機的狀態更改為UNAVAILABLE,並將帶有Driver對象的事件發送到drivers主題。

@Singleton
public class DriverService {

    private static final Logger LOGGER = LoggerFactory.getLogger(DriverService.class);

    private DriverClient client;
    private OrderClient orderClient;
    private DriverInMemoryRepository repository;

    public DriverService(DriverClient client, OrderClient orderClient, DriverInMemoryRepository repository) {
        this.client = client;
        this.orderClient = orderClient;
        this.repository = repository;
    }

    public void processNewTripOrder(Order order) {
        LOGGER.info("Processing: {}", order);
        Optional<Driver> driver = repository.findNearestDriver(order.getCurrentLocationX(), order.getCurrentLocationY());
        driver.ifPresent(driverLocal -> {
            driverLocal.setStatus(DriverStatus.UNAVAILABLE);
            repository.updateDriver(driverLocal);
            client.send(driverLocal, String.valueOf(order.getId()));
            LOGGER.info("Message sent: {}", driverLocal);
        });
    }
    
    // ...
}

這是Kafka Client在司機服務中的實現,用於向driver主題發送消息。因為我們需要將Driver與Order關聯起來,所以我們使用@Header註解的orderId參數。沒有必要把它包括到Driver類中,將其分配給監聽器端的正確行程。

@KafkaClient
public interface DriverClient {

    @Topic("drivers")
    void send(@Body Driver driver, @Header("Order-Id") String orderId);

}

4.4 服務間通信

由DriverListener收到@KafkaListener在行程服務中聲明。它監聽傳入到trip主題。接收方法的參數和客戶端發送方法的類似,如下所示:

@KafkaListener(groupId = "trip")
public class DriverListener {

    private static final Logger LOGGER = LoggerFactory.getLogger(OrderListener.class);

    private TripService service;

    public DriverListener(TripService service) {
        this.service = service;
    }

    @Topic("drivers")
    public void receive(@Body Driver driver, @Header("Order-Id") String orderId) {
        LOGGER.info("Received: driver->{}, header->{}", driver, orderId);
        service.processNewDriver(driver);
    }

}

最後一步,將orderId查詢到的行程Trip與driverId關聯,這樣整個流程就結束。

@Singleton
public class TripService {

    private static final Logger LOGGER = LoggerFactory.getLogger(TripService.class);

    private TripInMemoryRepository repository;
    private TripClient client;

    public TripService(TripInMemoryRepository repository, TripClient client) {
        this.repository = repository;
        this.client = client;
    }


    public void processNewDriver(Driver driver, String orderId) {
        LOGGER.info("Processing: {}", driver);
        Optional<Trip> trip = repository.findByOrderId(Long.valueOf(orderId));
        trip.ifPresent(tripLocal -> {
            tripLocal.setDriverId(driver.getId());
            repository.update(tripLocal);
        });
    }
    
    // ... OTHER METHODS

}

5 跟蹤

我們可以使用Micronaut Kafka輕鬆地啟用分佈式跟蹤。首先,我們需要啟用和配置Micronaut跟蹤。要做到這一點,首先應該添加一些依賴項:

<dependency>
    <groupId>io.micronaut</groupId>
    <artifactId>micronaut-tracing</artifactId>
</dependency>
<dependency>
    <groupId>io.zipkin.brave</groupId>
    <artifactId>brave-instrumentation-http</artifactId>
    <scope>runtime</scope>
</dependency>
<dependency>
    <groupId>io.zipkin.reporter2</groupId>
    <artifactId>zipkin-reporter</artifactId>
    <scope>runtime</scope>
</dependency>
<dependency>
    <groupId>io.opentracing.brave</groupId>
    <artifactId>brave-opentracing</artifactId>
</dependency>
<dependency>
    <groupId>io.opentracing.contrib</groupId>
    <artifactId>opentracing-kafka-client</artifactId>
    <version>0.0.16</version>
    <scope>runtime</scope>
</dependency>

我們還需要在application.yml配置文件中,配置Zipkin的追蹤的地址等

tracing:
  zipkin:
    enabled: true
    http:
      url: http://192.168.99.100:9411
    sampler:
      probability: 1

在啟動應用程序之前,我們必須運行Zipkin容器:

$ docker run -d --name zipkin -p 9411:9411 openzipkin/zipkin

6 總結

在本文中,您將了解通過Apache Kafka使用異步通信構建微服務架構的過程。我已經向大家展示了Microaut Kafka庫最重要的特性,它允許您輕鬆地聲明Kafka主題的生產者和消費者,為您的微服務啟用健康檢查和分佈式跟蹤。我已經為我們的系統描述了一個簡單的場景的實現,包括根據客戶的請求添加一個新的行程。本示例係統的整體實現,請查看GitHub上的

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理
【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

Docker-Compose基礎與實戰,看這一篇就夠了

what & why

Compose 項目是 Docker 官方的開源項目,負責實現對 Docker 容器集群的快速編排。使用前面介紹的Dockerfile我們很容易定義一個單獨的應用容器。然而在日常開發工作中,經常會碰到需要多個容器相互配合來完成某項任務的情況。例如要實現一個 Web 項目,除了 Web 服務容器本身,往往還需要再加上後端的數據庫服務容器;再比如在分佈式應用一般包含若干個服務,每個服務一般都會部署多個實例。如果每個服務都要手動啟停,那麼效率之低、維護量之大可想而知。這時候就需要一個工具能夠管理一組相關聯的的應用容器,這就是Docker Compose。
Compose有2個重要的概念

  • 項目(Project):由一組關聯的應用容器組成的一個完整業務單元,在 docker-compose.yml 文件中定義。
  • 服務(Service):一個應用的容器,實際上可以包括若干運行相同鏡像的容器實例。

docker compose 安裝與卸載

安裝

二進制包在線安裝

curl -L https://github.com/docker/compose/releases/download/1.25.0/docker-compose-`uname -s`-`uname -m` -o /usr/local/bin/docker-compose 

sudo chmod +x /usr/local/bin/docker-compose

這個方法現在基本行不通,下載太慢了,不推薦使用。

二進制包離線安裝

從https://github.com/docker/compose/releases/download/1.25.0/docker-compose-Linux-x86_64下載對應的安裝包,比如我下載了Linux-x86_64的。

將下載好的安裝包剪切到/usr/local/bin/docker-compose目錄下
mv /app/download/docker-compose-Linux-x86_64 /usr/local/bin/docker-compose

添加執行權限
sudo chmod +x /usr/local/bin/docker-compose

pip安裝

  • 先安裝好pip工具
#安裝依賴 
yum -y install epel-release 
#安裝PIP 
yum -y install python-pip 
#升級PIP 
pip install --upgrade pip
  • 驗證pip 版本
[root@tymonitor bin]# pip --version
pip 8.1.2 from /usr/lib/python2.7/site-packages (python 2.7)
  • 安裝docker compose
    pip install -U docker-compose==1.25.0

  • 驗證docker compose版本
[root@tymonitor bin]# docker-compose --version
docker-compose version 1.25.0, build b42d419

安裝補全插件

curl -L https://raw.githubusercontent.com/docker/compose/1.25.0/contrib/completion/bash/docker-compose > /etc/bash_completion.d/docker-compose

卸載

二進制卸載

rm /usr/local/bin/docker-compose

pip卸載

pip uninstall docker-compose

docker compose 重要命令

命令選項

  • -f, –file FILE 指定使用的 Compose 模板文件,默認為 docker-compose.yml,可以多次指定。
  • -p, –project-name NAME 指定項目名稱,默認將使用所在目錄名稱作為項目名。
  • –x-networking 使用 Docker 的可拔插網絡後端特性
  • –x-network-driver DRIVER 指定網絡後端的驅動,默認為 bridge
  • –verbose 輸出更多調試信息。
  • -v, –version 打印版本並退出。

常用&重要命令

  • config
    驗證 Compose 文件格式是否正確,若正確則显示配置,若格式錯誤显示錯誤原因。
    如:docker-compose -f skywalking.yml config
    此命令不會執行真正的操作,而是显示 docker-compose 程序解析到的配置文件內容:

  • images
    列出 Compose 文件中包含的鏡像。如docker-compose -f skywalking.yml images

  • ps
    列出項目中目前的所有容器。如docker-compose -f skywalking.yml ps

  • build
    構建(重新構建)項目中的服務容器。如:docker-compose -f skywalking.yml build,一般搭配自定義鏡像,比如編寫的Dockfile,功能類似於docker build .

  • up
    該命令十分強大(重點掌握),它將嘗試自動完成包括構建鏡像,(重新)創建服務,啟動服務,並關聯服務相關容器的一系列操作。如docker-compose -f skywalking.yml up。默認情況,docker-compose up 啟動的容器都在前台,控制台將會同時打印所有容器的輸出信息,可以很方便進行調試。

    如果使用docker-compose up -d將會在後台啟動並運行所有的容器。一般推薦生產環境下使用該選項。
    默認情況,如果服務容器已經存在,docker-compose up 將會嘗試停止容器,然後重新創建(保持使用 volumes-from 掛載的卷),以保證新啟動的服務匹配 docker-compose.yml 文件的最新內容。如果用戶不希望容器被停止並重新創建,可以使用 docker-compose up --no-recreate。這樣將只會啟動處於停止狀態的容器,而忽略已經運行的服務。如果用戶只想重新部署某個服務,可以使用 docker-compose up --no-deps -d <SERVICE_NAME> 來重新創建服務並後台停止舊服務,啟動新服務,並不會影響到其所依賴的服務。此命令有如下選項:
    ①:-d 在後台運行服務容器。
    ②:--no-color 不使用顏色來區分不同的服務的控制台輸出。
    ③:--no-deps 不啟動服務所鏈接的容器。
    ④:--force-recreate 強制重新創建容器,不能與 –no-recreate 同時使用。
    ⑤:--no-recreate 如果容器已經存在了,則不重新創建,不能與 –force-recreate 同時使用。
    ⑥:--no-build 不自動構建缺失的服務鏡像。
    ⑦:-t, --timeout TIMEOUT 停止容器時候的超時(默認為 10 秒)。

  • down
    此命令停止用up命令所啟動的容器並移除網絡,如docker-compose -f skywalking.yml down

  • stop
    格式為 docker-compose stop [options] [SERVICE...]
    停止已經處於運行狀態的容器,但不刪除它。通過 docker-compose start 可以再次啟動這些容器,如果不指定service則默認停止所有的容器。如docker-compose -f skywalking.yml stop elasticsearch
    選項:
    -t, --timeout TIMEOUT 停止容器時候的超時(默認為 10 秒)。

  • start
    啟動已經存在的服務容器。用法跟上面的stop剛好相反,如docker-compose -f skywalking.yml start elasticsearch

  • restart
    重啟項目中的服務。用法跟上面的stop,start一樣

  • logs
    格式為docker-compose logs [options] [SERVICE...]
    查看服務容器的輸出。默認情況下,docker-compose 將對不同的服務輸出使用不同的顏色來區分。可以通過 –no-color 來關閉顏色。該命令在調試問題的時候十分有用。如docker-compose -f skywalking.yml logs 查看整體的日誌,docker-compose -f skywalking.yml logs elasticsearch 查看單獨容器的日誌

docker compose 模板文件

模板文件是使用 Compose 的核心,涉及到的指令關鍵字也比較多。本文主要列出幾個常見&重要的指令,其他指令大家可以自行百度。
默認的模板文件名稱為 docker-compose.yml,格式為 YAML 格式。

version: '3'
services:
  elasticsearch:
    image: elasticsearch:6.8.5
    container_name: elasticsearch
    restart: always
    volumes:
      - /app/skywalking/elasticsearch/data:/usr/share/elasticsearch/data:rw
      - /app/skywalking/elasticsearch/conf/elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml
      - /app/skywalking/elasticsearch/conf/jvm.options:/usr/share/elasticsearch/config/jvm.options
      - /app/skywalking/elasticsearch/logs:/usr/share/elasticsearch/logs:rw
    environment:
      - TZ=Asia/Shanghai
      - xpack.monitoring.enabled=false
      - xpack.watcher.enabled=false
    ports:
      - "9200:9200"
      - "9300:9300"

注意每個服務都必須通過 image 指令指定鏡像或 build 指令(需要 Dockerfile)等來自動構建生成鏡像。如果使用 build 指令,在 Dockerfile 中設置的選項(例如:CMD, EXPOSE, VOLUME, ENV 等) 將會自動被獲取,無需在 docker-compose.yml 中重複設置。

常用&重要命令

  • images
    指定為鏡像名稱或鏡像 ID。如果鏡像在本地不存在,Compose 將會嘗試拉取這個鏡像。
image: apache/skywalking-oap-server:6.5.0
image: apache/skywalking-ui:6.5.0
  • ports
    暴露端口信息。
    使用宿主端口:容器端口 (HOST:CONTAINER) 格式,或者僅僅指定容器的端口(宿主將會隨機選擇端口)都可以,端口字符串都使用引號包括起來的字符串格式。
ports: 
    - "3000" 
    - "8080:8080" 
    - "127.0.0.1:8001:8001"
  • volumes
    數據卷所掛載路徑設置。可以設置為宿主機路徑(HOST:CONTAINER)或者數據卷名稱(VOLUME:CONTAINER),並且可以設置訪問模式 (HOST:CONTAINER:ro)。
volumes:
      - /app/skywalking/elasticsearch/data:/usr/share/elasticsearch/data:rw
      - conf/elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml
version: "3"
services:
  my_src:
    image: mysql:8.0
    volumes:
      - mysql_data:/var/lib/mysql
volumes:
  mysql_data:
  • ulimits
    指定容器的 ulimits 限制值。
    例如,指定最大進程數為 65535,指定文件句柄數為 20000(軟限制,應用可以隨時修改,不能超過硬限制) 和 40000(系統硬限制,只能 root 用戶提高)。
ulimits:
   nproc: 65535
   nofile:
     soft: 20000
     hard: 40000
  • depends_on
    解決容器的依賴、啟動先後的問題。以下例子中會先啟動 redis mysql 再啟動 web
version: '3'
services:
  web:
    build: .
    depends_on:
      - db
      - redis     
  redis:
    image: redis    
  db:
    image: mysql
  • environment
    設置環境變量。你可以使用數組或字典兩種格式。
environment:
      SW_STORAGE: elasticsearch
      SW_STORAGE_ES_CLUSTER_NODES: elasticsearch:9200
      
environment:
      - SW_STORAGE= elasticsearch
      - SW_STORAGE_ES_CLUSTER_NODES=elasticsearch:9200
  • restart
    指定容器退出后的重啟策略為始終重啟。該命令對保持服務始終運行十分有效,在生產環境中推薦配置為 always 或者 unless-stopped。
    restart: always

docker-compose 實戰

首先我需要推薦兩件事:

  • 配置docker加速鏡像
    創建或修改/etc/docker/daemon.json
sudo mkdir -p /etc/docker
sudo tee /etc/docker/daemon.json <<-'EOF'
{
    "registry-mirrors": [
        "https://hub-mirror.c.163.com",
        "https://mirror.ccs.tencentyun.com",
        "https://reg-mirror.qiniu.co"
    ]
}
EOF
sudo systemctl daemon-reload
sudo systemctl restart docker
  • 給你的ide工具裝上docker插件

本次實戰我們以docker-compose部署skywalking為例。編寫skywalking.yml,內容如下。

version: '3.3'
services:
  elasticsearch:
    image: docker.elastic.co/elasticsearch/elasticsearch:6.8.5
    container_name: elasticsearch
    restart: always
    ports:
      - 9200:9200
      - 9300:9300
    environment:
      discovery.type: single-node
    ulimits:
      memlock:
        soft: -1
        hard: -1
  oap:
    image: skywalking/oap
    container_name: oap
    depends_on:
      - elasticsearch
    links:
      - elasticsearch
    restart: always
    ports:
      - 11800:11800
      - 12800:12800
    environment:
      SW_STORAGE: elasticsearch
      SW_STORAGE_ES_CLUSTER_NODES: elasticsearch:9200
  ui:
    image: skywalking/ui
    container_name: ui
    depends_on:
      - oap
    links:
      - oap
    restart: always
    ports:
      - 8080:8080
    environment:
      SW_OAP_ADDRESS: oap:12800

部署完成后將其上傳至服務器,執行docker-compose -f /app/skywalking.yml up -d即可。

個人公眾號:JAVA日知錄 ,

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

RNN-LSTM講解-基於tensorflow實現

cnn卷積神經網絡在前面已經有所了解了,目前博主也使用它進行了一個圖像分類問題,基於kaggle裏面的food-101進行的圖像識別,識別率有點感人,基於數據集的關係,大致來說還可行。
下面我就繼續學習rnn神經網絡。

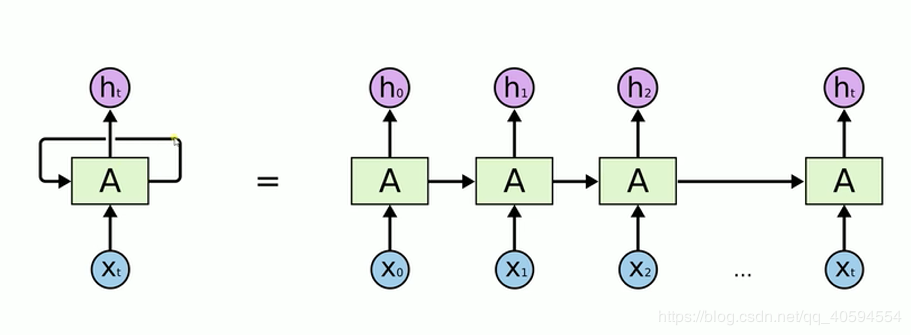
rnn神經網絡(遞歸/循環神經網絡)模式如下:

我們在處理文字等問題的時候,我們的輸入會把上一個時間輸出的數據作為下一個時間的輸入數據進行處理。
例如:我們有一段話,我們將其分詞,得到t個數據,我們分別將每一個詞傳入到x0,x1….xt裏面,當x0傳入后,會得到一個結果h0,同時我們會將處理后的數據傳入到下個時間,到下個時間的時候,我們會再傳入一個數據x1,同時還有上一個時間處理后的數據,將這兩個數據進行整合計算,然後再向下傳輸,一直到結束。
rnn本質來說還是一個bp迴路,不過他只是比bp網絡多一個環節,即它可以反饋上一時間點處理后的數據。

上圖細化如下:

rnn實際上還是存在梯度消失的問題,因此如上圖所示,當我們在第一個時間輸入的數據,可能在很久之後他就已經梯度消失了(影響很小),因此我們使用lstm(long short trem memory)

上圖有三個門:輸入門    忘記門   輸出門
1.輸入門:通過input * g 來判斷是否輸入,如果不輸入就為0,輸入就是0,以此判斷信號是否輸入
2.忘記門:這個信號是否需要衰減多少,可能為50%,衰減是根據信號來判斷。
3.輸入門:通過判斷是否輸出,或者輸出多少,例如輸出50%。
因此上述圖可化為:

可以看出,這三個門,所有得影響都是關於輸入和上一個數據得輸出來進行計算的。

可以看下圖:

我們使用lstm得話,通過三個門決定信號是否向下傳輸,傳輸多少都可以控制,是否傳入信號,輸出信息都進行控制。

下面我們還是用tensorflow實現,數據集還是手寫数字,雖然rnn主要是用在文字和語言上,但是它依舊可以用在圖片上。
下面給出代碼:

```python
import tensorflow as tf
from tensorflow.contrib import rnn
from tensorflow.examples.tutorials.mnist import  input_data
mnist=input_data.read_data_sets("MNNIST_data",one_hot=True)

#輸入圖片為 28*28
n_inputs=28#輸入一行,一行有28個像素
max_time=28#一共28行,所以為28*28
lstm_size=100#100個隱藏單元
batch_size=50
n_classes=10
n_batch=mnist.train.num_examples//batch_size#計算一共多少批次

#這裏none表示第一個維度可以是任意長度
x=tf.placeholder(tf.float32,[None,784])

y=tf.placeholder(tf.float32,[None,10])

#初始化權值
weights=tf.Variable(tf.truncated_normal([lstm_size,n_classes],stddev=0.1))
#初始化偏置值
biases=tf.Variable(tf.constant(0.1,shape=[n_classes]))

##定義Rnn 網絡
def RNN(X,weights,biases):
    inputs=tf.reshape(X,[-1,max_time,n_inputs])
    #定義lstm基本cell
    lstm_cell = rnn.BasicLSTMCell(lstm_size)
    #lstm_cell=tf.contrib.rnn.core_rnn_cell.BasicLSTMCell(lstm_size)
    outputs,final_state=tf.nn.dynamic_rnn(lstm_cell,inputs,dtype=tf.float32)
    results=tf.nn.softmax(tf.matmul(final_state[1],weights)+biases)
    return results
prediction=RNN(x,weights,biases)
#損失函數
cross_entropy=tf.reduce_mean(tf.nn.softmax_cross_entropy_with_logits(logits=prediction,labels=y))
#優化器
train_step=tf.train.AdamOptimizer(1e-4).minimize(cross_entropy)
#保存結果
correct_prediction=tf.equal(tf.argmax(y,1),tf.argmax(prediction,1))

accuracy=tf.reduce_mean(tf.cast(correct_prediction,tf.float32))

init=tf.global_variables_initializer()

with tf.Session() as sess:
    sess.run(init)
    for epoch in range(6):
        for batch in range(n_batch):
            batch_xs,batch_ys=mnist.train.next_batch(batch_size)
            sess.run(train_step,feed_dict={x:batch_xs,y:batch_ys})

        acc=sess.run(accuracy,feed_dict={x:mnist.test.images,y:mnist.test.labels})
        print("iter:"+str(epoch)+"testing accuracy"+str(acc))


“`
運行結果如下:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

設計模式之美學習(九):業務開發常用的基於貧血模型的MVC架構違背OOP嗎?

我們都知道,很多業務系統都是基於 MVC 三層架構來開發的。實際上,更確切點講,這是一種基於貧血模型的 MVC 三層架構開發模式。

雖然這種開發模式已經成為標準的 Web 項目的開發模式,但它卻違反了面向對象編程風格,是一種徹徹底底的面向過程的編程風格,因此而被有些人稱為反模式(anti-pattern)。特別是領域驅動設計(Domain Driven Design,簡稱 DDD)盛行之後,這種基於貧血模型的傳統的開發模式就更加被人詬病。而基於充血模型的 DDD 開發模式越來越被人提倡。

基於上面的描述,我們先搞清楚下面幾個問題:

  • 什麼是貧血模型?什麼是充血模型?
  • 為什麼說基於貧血模型的傳統開發模式違反 OOP?
  • 基於貧血模型的傳統開發模式既然違反 OOP,那又為什麼如此流行?
  • 什麼情況下我們應該考慮使用基於充血模型的 DDD 開發模式?

什麼是基於貧血模型的傳統開發模式?

對於大部分的後端開發工程師來說,MVC 三層架構都不會陌生。

MVC 三層架構中的 M 表示 Model,V 表示 View,C 表示 Controller。它將整個項目分為三層:展示層、邏輯層、數據層。MVC 三層開發架構是一個比較籠統的分層方式,落實到具體的開發層面,很多項目也並不會 100% 遵從 MVC 固定的分層方式,而是會根據具體的項目需求,做適當的調整。

比如,現在很多 Web 或者 App 項目都是前後端分離的,後端負責暴露接口給前端調用。這種情況下,我們一般就將後端項目分為 Repository 層、Service 層、Controller 層。其中,Repository 層負責數據訪問,Service 層負責業務邏輯,Controller 層負責暴露接口。當然,這隻是其中一種分層和命名方式。不同的項目、不同的團隊,可能會對此有所調整。不過,萬變不離其宗,只要是依賴數據庫開發的 Web 項目,基本的分層思路都大差不差。

再來看一下,什麼是貧血模型?

目前幾乎所有的業務後端系統,都是基於貧血模型的。舉一個簡單的例子來解釋一下。

////////// Controller+VO(View Object) //////////
public class UserController {
  private UserService userService; //通過構造函數或者IOC框架注入
  
  public UserVo getUserById(Long userId) {
    UserBo userBo = userService.getUser(userId);
    UserVo userVo = [...convert userBo to userVo...];
    return userVo;
  }
}

public class UserVo {//省略其他屬性、get/set/construct方法
  private Long id;
  private String name;
  private String cellphone;
}

////////// Service+BO(Business Object) //////////
public class UserService {
  private UserRepository userRepository; //通過構造函數或者IOC框架注入
  
  public UserBo getUserById(Long userId) {
    UserEntity userEntity = userRepository.getUserById(userId);
    UserBo userBo = [...convert userEntity to userBo...];
    return userBo;
  }
}

public class UserBo {//省略其他屬性、get/set/construct方法
  private Long id;
  private String name;
  private String cellphone;
}

////////// Repository+Entity //////////
public class UserRepository {
  public UserEntity getUserById(Long userId) { //... }
}

public class UserEntity {//省略其他屬性、get/set/construct方法
  private Long id;
  private String name;
  private String cellphone;
}

平時開發 Web 後端項目的時候,基本上都是這麼組織代碼的。其中,UserEntity 和 UserRepository 組成了數據訪問層,UserBo 和 UserService 組成了業務邏輯層,UserVo 和 UserController 在這裏屬於接口層。

從代碼中可以發現,UserBo 是一個純粹的數據結構,只包含數據,不包含任何業務邏輯。業務邏輯集中在 UserService 中。我們通過 UserService 來操作 UserBo。換句話說,Service 層的數據和業務邏輯,被分割為 BO 和 Service 兩個類中。像 UserBo 這樣,只包含數據,不包含業務邏輯的類,就叫作貧血模型(Anemic Domain Model)。同理,UserEntity、UserVo 都是基於貧血模型設計的。這種貧血模型將數據與操作分離,破壞了面向對象的封裝特性,是一種典型的面向過程的編程風格。

什麼是基於充血模型的 DDD 開發模式?

首先,我們先來看一下,什麼是充血模型?

在貧血模型中,數據和業務邏輯被分割到不同的類中。充血模型(Rich Domain Model)正好相反,數據和對應的業務邏輯被封裝到同一個類中。因此,這種充血模型滿足面向對象的封裝特性,是典型的面向對象編程風格。

接下來,再來看一下,什麼是領域驅動設計?

領域驅動設計,即 DDD,主要是用來指導如何解耦業務系統,劃分業務模塊,定義業務領域模型及其交互。領域驅動設計這個概念並不新穎,早在 2004 年就被提出了,到現在已經有十幾年的歷史了。不過,它被大眾熟知,還是基於另一個概念的興起,那就是微服務。

除了監控、調用鏈追蹤、API 網關等服務治理系統的開發之外,微服務還有另外一個更加重要的工作,那就是針對公司的業務,合理地做微服務拆分。而領域驅動設計恰好就是用來指導劃分服務的。所以,微服務加速了領域驅動設計的盛行。

領域驅動設計有點兒類似敏捷開發、SOA、PAAS 等概念,聽起來很高大上,但實際上只值“五分錢”。即便你沒有聽說過領域驅動設計,對這個概念一無所知,只要你是在開發業務系統,也或多或少都在使用它。做好領域驅動設計的關鍵是,看你對自己所做業務的熟悉程度,而並不是對領域驅動設計這個概念本身的掌握程度。即便你對領域驅動搞得再清楚,但是對業務不熟悉,也並不一定能做出合理的領域設計。所以,不要把領域驅動設計當銀彈,不要花太多的時間去過度地研究它。

實際上,基於充血模型的 DDD 開發模式實現的代碼,也是按照 MVC 三層架構分層的。Controller 層還是負責暴露接口,Repository 層還是負責數據存取,Service 層負責核心業務邏輯。它跟基於貧血模型的傳統開發模式的區別主要在 Service 層。

在基於貧血模型的傳統開發模式中,Service 層包含 Service 類和 BO 類兩部分,BO 是貧血模型,只包含數據,不包含具體的業務邏輯。業務邏輯集中在 Service 類中。在基於充血模型的 DDD 開發模式中,Service 層包含 Service 類和 Domain 類兩部分。Domain 就相當於貧血模型中的 BO。不過,Domain 與 BO 的區別在於它是基於充血模型開發的,既包含數據,也包含業務邏輯。而 Service 類變得非常單薄。總結一下的話就是,基於貧血模型的傳統的開發模式,重 Service 輕 BO;基於充血模型的 DDD 開發模式,輕 Service 重 Domain。

為什麼基於貧血模型的傳統開發模式如此受歡迎?

基於貧血模型的傳統開發模式,將數據與業務邏輯分離,違反了 OOP 的封裝特性,實際上是一種面向過程的編程風格。但是,現在幾乎所有的 Web 項目,都是基於這種貧血模型的開發模式,甚至連 Java Spring 框架的官方 demo,都是按照這種開發模式來編寫的。

面向過程編程風格有種種弊端,比如,數據和操作分離之後,數據本身的操作就不受限制了。任何代碼都可以隨意修改數據。既然基於貧血模型的這種傳統開發模式是面向過程編程風格的,那它又為什麼會被廣大程序員所接受呢?

第一點原因是,大部分情況下,我們開發的系統業務可能都比較簡單,簡單到就是基於 SQL 的 CRUD 操作,所以,我們根本不需要動腦子精心設計充血模型,貧血模型就足以應付這種簡單業務的開發工作。除此之外,因為業務比較簡單,即便我們使用充血模型,那模型本身包含的業務邏輯也並不會很多,設計出來的領域模型也會比較單薄,跟貧血模型差不多,沒有太大意義。

第二點原因是,充血模型的設計要比貧血模型更加有難度。因為充血模型是一種面向對象的編程風格。我們從一開始就要設計好針對數據要暴露哪些操作,定義哪些業務邏輯。而不是像貧血模型那樣,我們只需要定義數據,之後有什麼功能開發需求,我們就在 Service 層定義什麼操作,不需要事先做太多設計。

第三點原因是,思維已固化,轉型有成本。基於貧血模型的傳統開發模式經歷了這麼多年,已經深得人心、習以為常。你隨便問一個旁邊的大齡同事,基本上他過往參与的所有 Web 項目應該都是基於這個開發模式的,而且也沒有出過啥大問題。如果轉向用充血模型、領域驅動設計,那勢必有一定的學習成本、轉型成本。很多人在沒有遇到開發痛點的情況下,是不願意做這件事情的。

什麼項目應該考慮使用基於充血模型的 DDD 開發模式?

基於貧血模型的傳統的開發模式,比較適合業務比較簡單的系統開發。相對應的,基於充血模型的 DDD 開發模式,更適合業務複雜的系統開發。比如,包含各種利息計算模型、還款模型等複雜業務的金融系統。

這兩種開發模式,落實到代碼層面,區別不就是一個將業務邏輯放到 Service 類中,一個將業務邏輯放到 Domain 領域模型中嗎?為什麼基於貧血模型的傳統開發模式,就不能應對複雜業務系統的開發?而基於充血模型的 DDD 開發模式就可以呢?

實際上,除了我們能看到的代碼層面的區別之外(一個業務邏輯放到 Service 層,一個放到領域模型中),還有一個非常重要的區別,那就是兩種不同的開發模式會導致不同的開發流程。基於充血模型的 DDD 開發模式的開發流程,在應對複雜業務系統的開發的時候更加有優勢。為什麼這麼說呢?先來回憶一下,我們平時基於貧血模型的傳統的開發模式,都是怎麼實現一個功能需求的。

不誇張地講,我們平時的開發,大部分都是 SQL 驅動(SQL-Driven)的開發模式。我們接到一個後端接口的開發需求的時候,就去看接口需要的數據對應到數據庫中,需要哪張表或者哪幾張表,然後思考如何編寫 SQL 語句來獲取數據。之後就是定義 Entity、BO、VO,然後模板式地往對應的 Repository、Service、Controller 類中添加代碼。

業務邏輯包裹在一個大的 SQL 語句中,而 Service 層可以做的事情很少。SQL 都是針對特定的業務功能編寫的,復用性差。當我要開發另一個業務功能的時候,只能重新寫個滿足新需求的 SQL 語句,這就可能導致各種長得差不多、區別很小的 SQL 語句滿天飛。

所以,在這個過程中,很少有人會應用領域模型、OOP 的概念,也很少有代碼復用意識。對於簡單業務系統來說,這種開發方式問題不大。但對於複雜業務系統的開發來說,這樣的開發方式會讓代碼越來越混亂,最終導致無法維護。

如果我們在項目中,應用基於充血模型的 DDD 的開發模式,那對應的開發流程就完全不一樣了。在這種開發模式下,我們需要事先理清楚所有的業務,定義領域模型所包含的屬性和方法。領域模型相當於可復用的業務中間層。新功能需求的開發,都基於之前定義好的這些領域模型來完成。

越複雜的系統,對代碼的復用性、易維護性要求就越高,我們就越應該花更多的時間和精力在前期設計上。而基於充血模型的 DDD 開發模式,正好需要我們前期做大量的業務調研、領域模型設計,所以它更加適合這種複雜系統的開發。

重點回顧

平時做 Web 項目的業務開發,大部分都是基於貧血模型的 MVC 三層架構,這裏把它稱為傳統的開發模式。之所以稱之為“傳統”,是相對於新興的基於充血模型的 DDD 開發模式來說的。基於貧血模型的傳統開發模式,是典型的面向過程的編程風格。相反,基於充血模型的 DDD 開發模式,是典型的面向對象的編程風格。

不過,DDD 也並非銀彈。對於業務不複雜的系統開發來說,基於貧血模型的傳統開發模式簡單夠用,基於充血模型的 DDD 開發模式有點大材小用,無法發揮作用。相反,對於業務複雜的系統開發來說,基於充血模型的 DDD 開發模式,因為前期需要在設計上投入更多時間和精力,來提高代碼的復用性和可維護性,所以相比基於貧血模型的開發模式,更加有優勢。

思考

  • 對於舉的例子中,UserEntity、UserBo、UserVo 包含的字段都差不多,是否可以合併為一個類呢?

參考:

本文由博客一文多發平台 發布!
更多內容請點擊我的博客

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選
WPF 修改屏幕DPI,會觸發控件重新加載Unload/Load

修改屏幕DPI,會觸發控件的Unloaded/Loaded

現象/重現案例

這裏簡單介紹下,修改屏幕DPI,觸發Unloaded/Loaded的神奇案例

1. 我們新建一個窗口,添加一個UserControl1,然後在UserControl1中添加UserControl2

 1 <Window x:Class="WPFUnloadedTriggerTest.MainWindow"
 2         xmlns="http://schemas.microsoft.com/winfx/2006/xaml/presentation"
 3         xmlns:x="http://schemas.microsoft.com/winfx/2006/xaml"
 4         xmlns:d="http://schemas.microsoft.com/expression/blend/2008"
 5         xmlns:mc="http://schemas.openxmlformats.org/markup-compatibility/2006"
 6         xmlns:local="clr-namespace:WPFUnloadedTriggerTest"
 7         mc:Ignorable="d"
 8         Title="MainWindow" Height="450" Width="800">
 9     <local:UserControl1></local:UserControl1>
10 </Window>
11 ------------------------------我是分隔線-----------------------------------
12 <UserControl x:Class="WPFUnloadedTriggerTest.UserControl1"
13              xmlns="http://schemas.microsoft.com/winfx/2006/xaml/presentation"
14              xmlns:x="http://schemas.microsoft.com/winfx/2006/xaml"
15              xmlns:mc="http://schemas.openxmlformats.org/markup-compatibility/2006" 
16              xmlns:d="http://schemas.microsoft.com/expression/blend/2008" 
17              xmlns:local="clr-namespace:WPFUnloadedTriggerTest"
18              mc:Ignorable="d" 
19              d:DesignHeight="450" d:DesignWidth="800">
20     <local:UserControl2></local:UserControl2>
21 </UserControl>

View Code

2. 显示窗口后,修改DPI比例

3. 設置完后,會觸發Unloaded/Loaded重新加載

Unloaded的觸發順序是UserControl1–>UserControl2,Window並不會觸發Unloaded事件!

是不是詭異?我們繼續。。。

 4. Window我們添加一個ControlTemplate模塊

1     <Window.Template>
2         <ControlTemplate TargetType="Window">
3             <Border>
4                 <AdornerDecorator>
5                     <ContentPresenter />
6                 </AdornerDecorator>
7             </Border>
8         </ControlTemplate>
9     </Window.Template>

 再重複2、3步驟,Unloaded的觸發順序變了:

觸發UserControl2的Unloaded,Window、UserControl1並不會觸發Unloaded事件!

問題分析

第2步驟中修改DPI后,Unloaded事件不一定觸發。如何必現呢?

將窗口靠近到任務欄上方,再修改文本比例。

 我們查看調用堆棧,貌似是系統給窗口發送消息然後調用BroadcastUnloadedEvent事件,觸發Unload

 所以應該是修改DPI,窗口寬高超出了當前屏幕尺寸範圍,系統對UserControl的視覺樹進行重新加載布局。

至於窗口沒有觸發Unloaded、以及在窗口添加以上模塊後下一級子控件也沒有觸發Unloaded事件的原因,暫不了解

而對WPF-Unloaded/Loaded的已知情況如下:

  • FrameworkElement, 第一次加載显示時,會觸發Loaded。元素被釋放時,會觸發Unloaded。窗口Show/Close時,視覺樹變化都會觸發加載事件
  • MenuItem, 在FrameworkElement基礎上,每次和隱藏MenuItem時,會額外觸發Load/Unloaded
  • TabControl,當你選中一個tabItem時會觸發Loaded,當你取消選中一個tabItem時會觸發Unloaded,所以切換Tab時必定有一個Loaded一個Unloaded。
  • Expander,每次被Expanded擴展時會引發Loaded,但當隱藏時不會引發Unloaded。

 以上問題的解決方案?暫時沒有解決方案,只有規避措施,不要過於依賴於Unload/Loaded,而且使用了Unload/Loaded時也要添加註銷機制,防止重入

我在github提了個issue:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

Java學習筆記 線程池使用及詳解

有點笨,參考了好幾篇大佬們寫的文章才整理出來的筆記….

字面意思上解釋,線程池就是裝有線程的池,我們可以把要執行的多線程交給線程池來處理,和連接池的概念一樣,通過維護一定數量的線程池來達到多個線程的復用。

好處

多線程產生的問題

一般我們使用到多線程的編程的時候,需要通過new Thread(xxRunnable).start()創建並開啟線程,我們可以使用多線程來達到最優效率(如多線程下載)。

但是,線程不是越多就越好,線程過多,創建和銷毀就會消耗系統的資源,也不方便管理。

除此之外,多線程還會造成併發問題,線程併發數量過多,搶佔系統資源從而導致阻塞。

線程池優點

我們將線程放入線程池,由線程池對線程進行管理,可以對線程池中緩衝的線程進行復用,這樣,就不會經常去創建和銷毀線程了,從而省下了系統的資源。

線程池能夠有效的控制線程併發的數量,能夠解決多線程造成的併發問題。

除此之外,線程池還能夠對線程進行一定的管理,如延時執行、定時循環執行的策略等

線程池實現

線程池的實現,主要是通過這個類ThreadPoolExecutor,其的構造參數非常長,我們先大概了解,之後再進行詳細的介紹。

public ThreadPoolExecutor(int corePoolSize,
    int maximumPoolSize,long keepAliveTime,
    TimeUnit unit,BlockingQueue workQueue,
    RejectedExecutionHandler handler)
  • corePoolSize:線程池核心線程數量
  • maximumPoolSize:線程池最大線程數量
  • keepAliverTime:當活躍線程數大於核心線程數時,空閑的多餘線程最大存活時間
  • unit:存活時間的單位
  • workQueue:存放線程的工作隊列
  • handler:超出線程範圍和隊列容量的任務的處理程序(拒絕策略)

這裏大概簡單說明一下線程池的運行流程:

當線程被添加到線程池中,如果線程池中的當前的線程數量等於線程池定義的最大核心線程數量(corePoolSize)了,此線程就會別放入線程的工作隊列(workQueue)中,等待線程池的調用。

Java提供了一個工具類Excutors,方便我們快速創建線程池,其底層也是調用了ThreadPoolExecutor

不過阿里巴巴Java規範中強制要求我們應該通過ThreadPoolExecutor來創建自己的線程池,使用Excutors容易造成OOM問題。

所以,我們先從Excutors開始學習,之後在對ThreadPoolExecutor進行詳細的講解

Excutors

由於Excutors是工具類,所以下面的介紹的都是其的靜態方法,如果是比較線程數目比較少的小項目,可以使用此工具類來創建線程池

PS:把線程提交給線程池中,有兩種方法,一種是submit,另外一種則是execute

兩者的區別:

  1. execute沒有返回值,如果不需要知道線程的結果就使用execute方法,性能會好很多。
  2. submit返回一個Future對象,如果想知道線程結果就使用submit提交,而且它能在主線程中通過Future的get方法捕獲線程中的異常

線程池可以接收兩種的參數,一個為Runnable對象,另外則是Callable對象

Callable是JDK1.5時加入的接口,作為Runnable的一種補充,允許有返回值,允許拋出異常。

主要的幾個靜態方法:

方法 說明
newFixedThreadPool(int nThreads) 創建固定大小的線程池
newSingleThreadExecutor() 創建只有一個線程的線程池
newCachedThreadPool() 創建一個不限線程數上限的線程池,任何提交的任務都將立即執行
newScheduledThreadPool(int nThreads) 創建一個支持定時、周期性或延時任務的限定線程數目的線程池
newSingleThreadScheduledExecutor() 創建一個支持定時、周期性或延時任務的單個線程的線程池

1.newSingleThreadExecutor

創建一個單線程化的線程池,它只會用唯一的工作線程來執行任務,保證所有任務按照指定順序(FIFO, LIFO, 優先級)執行,我們可以使用它來達到控制線程順序執行。

控制進程順序執行:

Thread thread1 = new Thread(new Runnable() {
            @Override
            public void run() {
                try {
                    System.out.println("這是線程1");
                    Thread.sleep(1000);
                } catch (InterruptedException e) {
                    e.printStackTrace();
                }
            }
        });
Thread thread2 = new Thread(new Runnable() {
    @Override
    public void run() {
        try {
            System.out.println("這是線程2");
            Thread.sleep(1000);
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
    }
});
Thread thread3 = new Thread(new Runnable() {
    @Override
    public void run() {
        try {
            System.out.println("這是線程3");
            Thread.sleep(1000);
        } catch (InterruptedException e) {
            e.printStackTrace();
        }
    }
});
//創建線程池對象
ExecutorService executorService = Executors.newSingleThreadExecutor();
//把線程添加到線程池中
executorService.submit(thread1);
executorService.submit(thread2);
executorService.submit(thread3);

之後出現的結果就是按照順序輸出

2.newFixedThreadPool

創建一個定長線程池,可控制線程最大併發數,超出的線程會在隊列中等待。定長線程池的大小最好根據系統資源進行設置。如Runtime.getRuntime().availableProcessors()

3.newCachedThreadPool

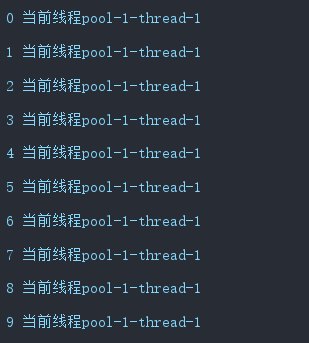
創建一個可緩存線程池,如果線程池長度超過處理需要,可靈活回收空閑線程,若無可回收,則新建線程,線程池為無限大,當執行第二個任務時第一個任務已經完成,會復用執行第一個任務的線程,而不用每次新建線程。

代碼:

//創建了一個自定義的線程
public class MyThread extends Thread {
    private int index;

    public MyThread(int index) {
        this.index = index;
    }

    @Override
    public void run() {
        System.out.println(index+" 當前線程"+Thread.currentThread().getName());
    }
}

//創建緩存線程池
ExecutorService executorService = Executors.newCachedThreadPool();
for (int i = 0; i < 10; i++) {
    executorService.execute(new MyThread(i));
    try {
        //這裏模擬等待時間,等待線程池復用回收線程
        Thread.sleep(1000);
    } catch (InterruptedException e) {
        e.printStackTrace();
    }
}

可以看到結果都是使用的同一個線程

4.newScheduledThreadPool

創建一個定長線程池,支持定時、周期性或延時任務執行

延遲1s后啟動線程:

ScheduledExecutorService scheduledExecutorService = Executors.newScheduledThreadPool(2);
scheduledExecutorService.schedule(new MyThread(1),1, TimeUnit.SECONDS);

ThreadPoolExecutor

構造方法

上面提到的那個構造方法其實只是ThreadPoolExecutor類中的一個,ThreadPoolExecutor類中存在有四種不同的構造方法,主要區別就是參數不同。

//五個參數的構造函數
public ThreadPoolExecutor(int corePoolSize,
                          int maximumPoolSize,
                          long keepAliveTime,
                          TimeUnit unit,
                          BlockingQueue<Runnable> workQueue)

//六個參數的構造函數-1
public ThreadPoolExecutor(int corePoolSize,
                          int maximumPoolSize,
                          long keepAliveTime,
                          TimeUnit unit,
                          BlockingQueue<Runnable> workQueue,
                          ThreadFactory threadFactory)

//六個參數的構造函數-2
public ThreadPoolExecutor(int corePoolSize,
                          int maximumPoolSize,
                          long keepAliveTime,
                          TimeUnit unit,
                          BlockingQueue<Runnable> workQueue,
                          RejectedExecutionHandler handler)

//七個參數的構造函數
public ThreadPoolExecutor(int corePoolSize,
                          int maximumPoolSize,
                          long keepAliveTime,
                          TimeUnit unit,
                          BlockingQueue<Runnable> workQueue,
                          ThreadFactory threadFactory,
                          RejectedExecutionHandler handler)

首先,有個概念需要明白,線程池的最大線程數(線程總數,maximumPoolSize)= 核心線程數(corePoolSize)+非核心線程數

  • corePoolSize:線程池核心線程數量
  • maximumPoolSize:線程池最大線程數量
  • keepAliverTime:當活躍線程數大於核心線程數時,空閑的多餘線程最大存活時間
  • unit:存活時間的單位
  • workQueue:存放線程的工作隊列
  • handler:超出線程範圍和隊列容量的任務的處理程序(拒絕策略)

核心線程和非核心線程有什麼區別呢?

核心線程是永遠不會被線程池丟棄回收(即使核心線程沒有工作),非核心線程則是超過一定時間(keepAliverTime)則就會被丟棄

workQueue

當所有的核心線程都在工作時,新添加的任務會被添加到這個隊列中等待處理,如果隊列滿了,則新建非核心線程執行任務

1.SynchronousQueue:這個隊列接收到任務的時候,會直接提交給線程處理,而不保留它,如果所有線程都在工作怎麼辦?那就新建一個線程來處理這個任務!所以為了保證不出現線程數達到了maximumPoolSize而不能新建線程的錯誤,使用這個類型隊列的時候,maximumPoolSize一般指定成Integer.MAX_VALUE,即無限大

2.LinkedBlockingQueue:這個隊列接收到任務的時候,如果當前線程數小於核心線程數,則新建線程(核心線程)處理任務;如果當前線程數等於核心線程數,則進入隊列等待。由於這個隊列沒有最大值限制,即所有超過核心線程數的任務都將被添加到隊列中,這也就導致了maximumPoolSize的設定失效,因為總線程數永遠不會超過corePoolSize

3.ArrayBlockingQueue:可以限定隊列的長度,接收到任務的時候,如果沒有達到corePoolSize的值,則新建線程(核心線程)執行任務,如果達到了,則入隊等候,如果隊列已滿,則新建線程(非核心線程)執行任務,又如果總線程數到了maximumPoolSize,並且隊列也滿了,則發生錯誤

4.DelayQueue:隊列內元素必須實現Delayed接口,這就意味着你傳進去的任務必須先實現Delayed接口。這個隊列接收到任務時,首先先入隊,只有達到了指定的延時時間,才會執行任務

拒絕策略:

拒絕策略 拒絕行為
AbortPolicy 拋出RejectedExecutionException異常(默認)
DiscardPolicy 不處理,丟棄掉
DiscardOldestPolicy 丟棄執行隊列中等待最久的一個任務,嘗試為新來的任務騰出位置
CallerRunsPolicy 直接由提交任務者執行這個任務

兩種方法設置拒絕策略:

//ThreadPoolExecutor對象的setRejectedExecutionHandler方法設置
ThreadPoolExecutor threadPool = new ThreadPoolExecutor(2, 5, 60, TimeUnit.SECONDS, queue);
threadPool.setRejectedExecutionHandler(new ThreadPoolExecutor.AbortPolicy());
//構造方法進行設置,省略

線程池默認的拒絕行為是AbortPolicy,也就是拋出RejectedExecutionHandler異常,該異常是非受檢異常,很容易忘記捕獲。

如果不關心任務被拒絕的事件,可以將拒絕策略設置成DiscardPolicy,這樣多餘的任務會悄悄的被忽略。

ThreadFactory

一個接口類,用來對線程進行設置,需要實現newThread(Runnable r)方法

官方的文檔說明:

newThread此方法一般來初始化線程的優先級(priority),名字(name),守護進程(daemon)或線程組(ThreadGroup)

簡單的例子(讓某個類實現ThreadFactory接口):

@Override
public Thread newThread(Runnable r) {
    Thread thread = new Thread(r);
    thread.setDaemon(true);
    return thread;
}

線程池獲取執行結果

PS:把線程提交給線程池中,有兩種方法,一種是submit,另外一種則是execute

兩者的區別:

  1. execute沒有返回值,如果不需要知道線程的結果就使用execute方法,性能會好很多。
  2. submit返回一個Future對象,如果想知道線程結果就使用submit提交,而且它能在主線程中通過Future的get方法捕獲線程中的異常

線程池可以接收兩種的參數,一個為Runnable對象,另外則是Callable對象

Callable是JDK1.5時加入的接口,作為Runnable的一種補充,允許有返回值,允許拋出異常。

線程池的處理結果、以及處理過程中的異常都被包裝到Future中,並在調用Future.get()方法時獲取,執行過程中的異常會被包裝成ExecutionException,submit()方法本身不會傳遞結果和任務執行過程中的異常。

獲取執行結果的代碼可以這樣寫:

ExecutorService executorService = Executors.newFixedThreadPool(4);
Future<Object> future = executorService.submit(new Callable<Object>() {
        @Override
        public Object call() throws Exception {
            //該異常會在調用Future.get()時傳遞給調用者
            throw new RuntimeException("exception in call~");
        }
    });
    
try {
    //獲得返回結果
    Object result = future.get();
    
    
} catch (InterruptedException e) {
  // interrupt
} catch (ExecutionException e) {
  // exception in Callable.call()
  e.printStackTrace();
}

線程池運行流程

一個形象的比喻說明線程池的流程:

規定:

  1. 線程池比作成一家公司
  2. 公司的最大員工數為maximumPoolSize
  3. 最大正式員工數為coolPoolSize(核心線程的總數)
  4. 最大員工數(maximumPoolSize) = 最大正式員工(coolPoolSize)和臨時工(非核心線程)
  5. 單子(任務)可看做為線程
  6. 隊列使用的是ArrayBlockingQueue
  7. 一個員工只能幹一個任務

最開始的時候,公司是沒有一名員工。之後,公司接到了單子(任務),這個時候,公司才去找員工(創建核心線程並讓線程開始執行),這個時候找到的員工就是正式員工了。

公司的聲譽越來越好,於是來了更多的單子,公司繼續招人,直到正式員工數量達到最大的正式員工的數量(核心線程數量已達到最大)

於是,多出來的單子就暫時地存放在了隊列中,都在排隊,等待正式員工們把手頭的工作做完之後,就從隊列中依次取出單子繼續工作。

某天,來了一個新單子,但是這個時候隊列已經滿了,公司為了自己的信譽和聲譽着想,不得已只能去找臨時工(創建非核心線程)來幫忙開始進行工作(負責新單子)

在此之後,又來了新單子,公司繼續去招臨時工為新來的單子工作,直到正式工和臨時工的數量已經達到了公司最大員工數。

這個時候,公司沒有辦法了,只能拒絕新來的單子了(拒絕策略)

此時,正式工和臨時工都是在加班加點去從隊列中取出任務來工作,終於某一天,隊列的已經沒有單子了,市場發展不好,單子越來越少,臨時工很久都不工作了(非核心線程超過了最大存活時間keepAliveTime),公司就把這些臨時工解僱了,直到剩下只有正式員工。

PS:如果也想要解僱正式員工(銷毀核心線程),可以設置ThreadPoolExecutor對象的的allowCoreThreadTimeOut這個屬性為true

個人理解,可能不是很正確,僅供參考!

線程池關閉

方法 說明
shutdown() 不再接受新的任務,之前提交的任務等執行結束再關閉線程池
shutdownNow() 不再接受新的任務,試圖停止池中的任務再關閉線程池,返回所有未處理的線程list列表。

總結

如果是小的Java程序,可以使用Excutors,如果是服務器程序,則使用ThreadPoolExecutor進行自定義線程池的創建

參考鏈接:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

如何使用C#調用C++類虛函數(即動態內存調用)

  本文講解如何使用C#調用只有.h頭文件的c++類的虛函數(非實例函數,因為非虛函數不存在於虛函數表,無法通過類對象偏移計算地址,除非用export導出,而gcc默認是全部導出實例函數,這也是為什麼msvc需要.lib,如果你不清楚但希望了解,可以選擇找我擺龍門陣),並以COM組件的c#直接調用(不需要引用生成introp.dll)舉例。

  我們都知道,C#支持調用非託管函數,使用P/Inovke即可方便實現,例如下面的代碼

[DllImport("msvcrt", EntryPoint = "memcpy", CallingConvention = CallingConvention.Cdecl)]
public static extern void memcpy(IntPtr dest, IntPtr src, int count);

不過使用DllImport只能調用某個DLL中標記為導出的函數,我們可以使用一些工具查看函數導出,如下圖

一般會導出的函數,都是c語言格式的。

  C++類因為有多態,所以內存中維護了一個虛函數表,如果我們知道了某個C++類的內存地址,也有它的頭文件,那麼我們就能自己算出想要調用的某個函數的內存地址從而直接call,下面是一個簡單示例

#include <iostream>

class A_A_A {
public:
    virtual void hello() {
        std::cout << "hello from A\n";
    };
};

//typedef void (*HelloMethod)(void*);

int main()
{
    A_A_A* a = new A_A_A();
    a->hello();

    //HelloMethod helloMthd = *(HelloMethod *)*(void**)a;
    
    //helloMthd(a);
    (*(void(**)(void*))*(void**)a)(a);

    int c;
    std::cin >> c;
}

(上文中將第23行註釋掉,然後將其他註釋行打開也是一樣的效果,可能更便於閱讀)
從代碼中大家很容易看出,c++的類的內存結構是一個虛函數表二級指針(數組,多重繼承時可能有多個),每個虛函數表又是一個函數二級指針(數組,多少個虛函數就有多少個指針)。上文中我們假使只知道a是一個類對象,它的第一個虛函數是void (*) (void)類型的,那麼我們可以直接call它的函數。

  接下來開始騷操作,我們嘗試用c#來調用一個c++的虛函數,首先寫一個c++的dll,並且我們提供一個c格式的導出函數用於提供一個new出的對象(畢竟c++的new操作符很複雜,而且實際中我們經常是可以拿到這個new出來的對象,後面的com組件調用部分我會詳細說明),像下面這樣

dll.h

class DummyClass {
private:
    virtual void sayHello();
};

dll.cpp

#include "dll.h"
#include <stdio.h>

void DummyClass::sayHello() {
    printf("Hello World\n");
}

extern "C" __declspec(dllexport) DummyClass* __stdcall newObj() {
    return new DummyClass();
}

我們編譯出的dll長這樣

讓我們編寫使用C#來調用sayHello

using System;
using System.Runtime.InteropServices;

namespace ConsoleApp2
{
    class Program
    {
        [DllImport("Dll1", EntryPoint = "newObj")]
        static extern IntPtr CreateObject();

        [UnmanagedFunctionPointer(CallingConvention.ThisCall)]
        delegate void voidMethod1(IntPtr thisPtr);

        static void Main(string[] args)
        {
            IntPtr dummyClass = CreateObject();
            IntPtr vfptr = Marshal.ReadIntPtr(dummyClass);
            IntPtr funcPtr = Marshal.ReadIntPtr(vfptr);
            voidMethod1 voidMethod = (voidMethod1)Marshal.GetDelegateForFunctionPointer(funcPtr, typeof(voidMethod1));
            voidMethod(dummyClass);

            Console.ReadKey();
        }
    }
}

(因為調用的是c++的函數,所以this指針是第一個參數,當然,不同調用約定時它入棧方式和順序不一樣)
下面有一種另外的寫法

using System;
using System.Reflection;
using System.Reflection.Emit;
using System.Runtime.InteropServices;

namespace ConsoleApp2
{
    class Program
    {
        [DllImport("Dll1", EntryPoint = "newObj")]
        static extern IntPtr CreateObject();

        //[UnmanagedFunctionPointer(CallingConvention.ThisCall)]
        //delegate void voidMethod1(IntPtr thisPtr);

        static void Main(string[] args)
        {
            IntPtr dummyClass = CreateObject();
            IntPtr vfptr = Marshal.ReadIntPtr(dummyClass);
            IntPtr funcPtr = Marshal.ReadIntPtr(vfptr);
            /*voidMethod1 voidMethod = (voidMethod1)Marshal.GetDelegateForFunctionPointer(funcPtr, typeof(voidMethod1));
            voidMethod(dummyClass);*/

            AssemblyName MyAssemblyName = new AssemblyName();
            MyAssemblyName.Name = "DummyAssembly";
            AssemblyBuilder MyAssemblyBuilder = AppDomain.CurrentDomain.DefineDynamicAssembly(MyAssemblyName, AssemblyBuilderAccess.Run);
            ModuleBuilder MyModuleBuilder = MyAssemblyBuilder.DefineDynamicModule("DummyModule");
            MethodBuilder MyMethodBuilder = MyModuleBuilder.DefineGlobalMethod("DummyFunc", MethodAttributes.Public | MethodAttributes.Static, typeof(void), new Type[] { typeof(int) });
            ILGenerator IL = MyMethodBuilder.GetILGenerator();

            IL.Emit(OpCodes.Ldarg, 0);
            IL.Emit(OpCodes.Ldc_I4, funcPtr.ToInt32());

            IL.EmitCalli(OpCodes.Calli, CallingConvention.ThisCall, typeof(void), new Type[] { typeof(int) });
            IL.Emit(OpCodes.Ret);

            MyModuleBuilder.CreateGlobalFunctions();

            MethodInfo MyMethodInfo = MyModuleBuilder.GetMethod("DummyFunc");

            MyMethodInfo.Invoke(null, new object[] { dummyClass.ToInt32() });

            Console.ReadKey();
        }
    }
}

上文中的方法雖然複雜了一點,但……就是沒什麼用。不用懷疑!

文章寫到這裏,可能有童鞋就要發問了。你說這麼多,tmd到底有啥用?那接下來,我舉一個栗子,activex組件的直接調用!
以前,我們調用activex組件需要做很多複雜的事情,首先需要使用命令行調用regsvr32將dll註冊到系統,然後回到vs去引用com組件是吧

  仔細想想,需要嗎?並不需要,因為兩個原因:

  • COM組件規定DLL需要給出一個DllGetClassObject函數,它就可以為我們在DLL內部new一個所需對象
  • COM組件返回的對象其實就是一個只有虛函數的C++類對象(COM組件規定屬性和事件用getter/setter方式實現)
  • COM組件其實不需要用戶手動註冊,執行regsvr32會操作註冊表,而且32位/64位會混淆,其實regsvr32隻是調用了DLL導出函數DllRegisterServer,而這個函數的實現一般只是把自己註冊到註冊表中,這一步可有可無(特別是對於我們已經知道某個activex的dll存在路徑且它能提供的服務時,如果你非要註冊,使用p/invoke調用該dll的DllRegisterServer函數是一樣的效果)

因此,假如我們有一個activex控件(例如vlc),我們希望把它嵌入我們程序中,我們先看看常規的做法(本文沒有討論帶窗體的vlc,因為窗體這塊兒又複雜一些),直接貼圖:

看起來很簡單,但當我們需要打包給客戶使用時就很麻煩,涉及到嵌入vlc的安裝程序。而當我們會動態內存調用之後,就可以不註冊而使用vlc的功能,我先貼出代碼:

using System;
using System.Runtime.InteropServices;

namespace ConsoleApp3
{
    class Program
    {
        [DllImport("kernel32")]
        static extern IntPtr LoadLibraryEx(string path, IntPtr hFile, int dwFlags);
        [DllImport("kernel32")]
        static extern IntPtr GetProcAddress(IntPtr dll, string func);

        delegate int DllGetClassObject(Guid clsid, Guid iid, ref IntPtr ppv);

        delegate int CreateInstance(IntPtr _thisPtr, IntPtr unkown, Guid iid, ref IntPtr ppv);

        delegate int getVersionInfo(IntPtr _thisPtr, [MarshalAs(UnmanagedType.BStr)] out string bstr);

        static void Main(string[] args)
        {
            IntPtr dll = LoadLibraryEx(@"D:\Program Files\VideoLAN\VLC\axvlc.dll", default, 8);
            IntPtr func = GetProcAddress(dll, "DllGetClassObject");
            DllGetClassObject dllGetClassObject = (DllGetClassObject)Marshal.GetDelegateForFunctionPointer(func, typeof(DllGetClassObject));

            Guid vlc = new Guid("2d719729-5333-406c-bf12-8de787fd65e3");
            Guid clsid = new Guid("9be31822-fdad-461b-ad51-be1d1c159921");
            Guid iidClassFactory = new Guid("00000001-0000-0000-c000-000000000046");
            IntPtr objClassFactory = default;
            dllGetClassObject(clsid, iidClassFactory, ref objClassFactory);
            CreateInstance createInstance = (CreateInstance)Marshal.GetDelegateForFunctionPointer(Marshal.ReadIntPtr(Marshal.ReadIntPtr(objClassFactory) + IntPtr.Size * 3), typeof(CreateInstance));
            IntPtr obj = default;
            createInstance(objClassFactory, default, vlc, ref obj);
            getVersionInfo getVersion = (getVersionInfo)Marshal.GetDelegateForFunctionPointer(Marshal.ReadIntPtr(Marshal.ReadIntPtr(obj) + IntPtr.Size * 18), typeof(getVersionInfo));
            string versionInfo;
            getVersion(obj, out versionInfo);

            Console.ReadKey();
        }
    }
}

  上文中的代碼有幾處可能大家不容易懂,特別是指針偏移量的運算,這裏面有比較複雜的地方,文章篇幅有限,下來咱們細細研究。

  從11年下半年開始學習編程到現在已經很久了,有時候會覺得沒什麼奔頭。其實人生,無外乎兩件事,愛情和青春,我希望大家能有抓住的,就不要放手。兩年前,我為了要和一個女孩子多說幾句話,給人家講COM組件,其實我連c++有虛函數表都不知道,時至今日,我已經失去了她。今後怕是一直會任由靈魂遊盪,半夢半醒,即是人生。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

在React舊項目中安裝並使用TypeScript的實踐

前言

本篇文章默認您大概了解什麼是TypeScript,主要講解如何在React舊項目中安裝並使用TypeScript。

寫這個的目的主要是網上關於TypeScript這塊的講解雖然很多,但都是一些語法概念或者簡單例子,真正改造一個React舊項目使用TypeScript的文章很少。

所以在這裏記錄下改造一個React項目的實踐。

博客內容部分參照 ,這個網站有官方文檔的中文版。

安裝TypeScript及相關庫

對於集成了TypeScript的腳手架可以略過這一步,這裏主要講一下如何將TypeScript集成到一個React腳手架中。

首先執行

npm install --save @types/react @types/react-dom

這一步主要是為了獲取react和react-dom的聲明文件,因為並不是所有的庫都有TypeScript的聲明文件,所以通過運行

npm install --save @types/庫名字

的方式來獲取TypeScript的聲明文件。

只有獲取了聲明文件,才能實現對這個庫的類型檢查。

如果你使用了一些其它的沒有聲明文件的庫,那麼可能也需要這麼做。

然後運行命令:

npm install --save-dev typescript awesome-typescript-loader source-map-loader

這一步,我們安裝了typescript、awesome-typescript-loader和source-map-loader。

awesome-typescript-loader可以讓Webpack使用TypeScript的標準配置文件tsconfig.json編譯TypeScript代碼。

source-map-loader使用TypeScript輸出的sourcemap文件來告訴webpack何時生成自己的sourcemaps,源碼映射,方便調試。

添加TypeScript配置文件

在項目根目錄下創建一個tsconfig.json文件,以下為內容示例:

{
  "compilerOptions": {
    "allowSyntheticDefaultImports": true, // 允許從沒有設置默認導出的模塊中默認導入。這並不影響代碼的輸出,僅為了類型檢查。
    "outDir": "./dist/", // 重定向輸出目錄
    "sourceMap": true, // 生成相應的 .map文件
    "noImplicitAny": true, // 在表達式和聲明上有隱含的 any類型時報錯。
    "module": "esnext", // 模塊引入方式
    "target": "esnext", // 指定ECMAScript目標版本
    "moduleResolution": "node", // 決定如何處理模塊
    "lib": [
      "esnext",
      "dom"
    ], // 編譯過程中需要引入的庫文件的列表。
    "skipLibCheck": true, //忽略所有庫中的聲明文件( *.d.ts)的類型檢查。
    "jsx": "react" // 在 .tsx文件里支持JSX
  },
  "include": [
    "./src/**/*", // 這個表示處理根目錄的src目錄下所有的.ts和.tsx文件,並不是所有文件
  ]
}

skipLibCheck非常重要,並不是每個庫都能通過typescript的檢測。

moduleResolution設為node也很重要。如果不這麼設置的話,找聲明文件的時候typescript不會在node_modules這個文件夾中去找。

更多配置文件信息可以參考:。

配置webpack

這裏列出一些TypeScript需要在webpack中使用的配置。

解析tsx文件的rule配置

示例如下:

module: {
    rules: [
      {
        test: /\.jsx?$/,
        exclude: /(node_modules)/,
        use: {
          loader: 'babel-loader',
          options: {
            presets: ['react', 'env', 'stage-0', 'stage-3'],
            plugins: [
              'transform-decorators-legacy',
              ['import', { libraryName: 'antd', style: 'css' }], // `style: true` 會加載 less 文件
            ],
          },
        },
      },
      { test: /\.tsx?$/, loader: "awesome-typescript-loader" }
      //...
    ]
    //...
}

其實就只是多加了一行:

{ test: /\.tsx?$/, loader: "awesome-typescript-loader" }

注意這一行需要加在解析jsx的rule下面,因為rule的執行順序是從下往上的,先解析tsx和ts再解析js和jsx。

當然用

enforce: 'pre'

調整過rule順序的可以不用在意這一點。

解決使用css-moudule的問題

如果代碼中使用了以下這種代碼:

import styles from './index.css'

那麼很可能報下面的錯:

Cannot find module './index.css'

解決方法就是在根目錄下新建文件一個叫declaration.d.ts的文件,內容為:

declare module '*.css' {
  const content: any;
  export default content;
}

這行代碼就是為所有的css文件進行聲明。

同時需要更改一下我們之前的tsconfig.json文件,將這個文件路徑放在include中:

"include": [
  "./src/**/*", 
  "./declaration.d.ts"
]

這個問題有通過安裝一些庫來解決的辦法,但是會給每個css生成一個聲明文件,感覺有點奇怪,我這裏自己考慮了一下採用了上面這種方法。

用於省略後綴名的配置

如果你慣於在使用

import Chart from './Chart/index.jsx'

時省略後綴,即:

import Chart from './Chart/index'

那麼在webpack的resolve中同樣需要加入ts和tsx:

resolve: {
  extensions: [".ts", ".tsx", ".js", ".jsx"]
},

引入Ant Design

實際上這個東西Ant Design的官網上就有怎麼在TypeScript中使用:。

那麼為什麼還是要列出來呢?

因為這裏要指出,對於已經安裝了Ant Design的舊項目而言(一般都是配了按需加載的吧),在安裝配置TypeScript時上面這個文檔基本沒有任何用處。

在網上可以搜到的貌似都是文檔中的方案,而實際上我們需要做的只是安裝ts-import-plugin。

npm i ts-import-plugin --save-dev

然後結合之前的 awesome-typescript-loader ,在webpack中進行如下配置

const tsImportPluginFactory = require('ts-import-plugin')

module.exports = {
  // ...
  module: {
    rules: [
      {
        test: /\.tsx?$/,
        loader: "awesome-typescript-loader",
        options: {
          getCustomTransformers: () => ({
            before: [tsImportPluginFactory([
              {
                libraryName: 'antd',
                libraryDirectory: 'lib',
                style: 'css'
              }
            ])]
          }),
        },
        exclude: /node_modules/
      }
    ]
  },
  // ...
}

配置完成,修改前的準備

注意,直到這一步,實際上您的項目在編譯過程中仍然沒有用到TypeScript。

因為我們這裏只會用TypeScript處理.ts和.tsx後綴的文件,除非在配置中將allowJs設為true。

在使用之前,默認您已經對TypeScript語法有了了解,不了解可以參考:。

也就是說,經過了上面的這些步驟,您的原有代碼在不改動後綴的情況下應該是可以繼續用的。

如果要使用TypeScript,那麼新建tsx和ts文件,或者修改原有的文件後綴名即可。

接下來會列出一些典型的修改示例。

函數式組件的修改示例(含children)

import React from 'react'
import styles from './index.css'

interface ComputeItemProps {
  label: string;
  children: React.ReactNode;
}

function ComputeItem({ label, children }: ComputeItemProps) {
  return <div className={styles['item']}>
    <div className={styles['label']}>{label}:</div>
    <div className={styles['content']}>{children}</div>
  </div>
}
export default ComputeItem

這個例子中語法都可以在TypeScript的官網查到,唯一需要注意的是children的類型是React.ReactNode。

class組件修改示例(含函數聲明,事件參數的定義)

import React from 'react'
import styles from './index.css'

interface DataSourceItem {
  dayOfGrowth: string;
  netValueDate: string;
}

interface ComputeProps {
  fundCode: string;
  dataSource: DataSourceItem[];
  onChange(value: Object): void;
}

export default class Compute extends React.Component<ComputeProps, Object> {
  // 改變基金代碼
  handleChangeFundCode = (e: React.ChangeEvent<HTMLInputElement>) => {
    const fundCode = e.target.value
    this.props.onChange({
      fundCode
    })

  }  
  render() {
      //...
    );
  }
}

這個例子展示如何聲明class組件:

React.Component<ComputeProps, Object>

語法雖然看起來很怪,但是這就是TypeScript中的泛型,以前有過C#或者Java經驗的應該很好理解。

其中,第一個參數定義Props的類型,第二個參數定義State的類型。

而react的事件參數類型應該如下定義:

React.ChangeEvent<HTMLInputElement>

這裏同樣使用了泛型,上面表示Input的Change事件類型。

而組件的Prop上有函數類型的定義,這裏就不單獨列出來了。

這幾個例子算是比較典型的TypeScript與React結合的例子。

處理window上的變量

使用寫在window上的全局變量會提示window上不存在這個屬性。

為了處理這點,可以在declaration.d.ts這個文件中定義變量:

// 定義window變量
interface Window{
  r:string[]
}

其中r是變量名。

總結

本來還想再多寫幾個示例的,但是Dota2版本更新了,導致我不想繼續寫下去了,以後如果有時間再更新常用的示例吧。

本篇文章只專註於在React舊項目中安裝並集成TypeScript,盡可能做到不涉及TypeScript的具體語法與介紹,因為介紹這些東西就不是一篇博客能搞定的了。

文章如有疏漏還請指正,希望能幫助到在TypeScript面前遲疑的你。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選
.NET Core 3.0 使用Nswag生成Api文檔和客戶端代碼

摘要

在前後端分離、Restful API盛行的年代,完美的接口文檔,成了交流的紐帶。在項目中引入Swagger (也稱為OpenAPI),是種不錯的選擇,它可以讓接口數據可視化。下文將會演示

  • 利用Nswag如何生成Api文檔

  • 利用NSwagStudio如何生成客戶端代碼,並且進行測試

什麼是 Swagger/OpenAPI?

Swagger 是一個與語言無關的規範,用於描述 REST API。Swagger 項目已捐贈給 OpenAPI 計劃,現在它被稱為開放 API。這兩個名稱可互換使用,但 OpenAPI 是首選。它允許計算機和人員了解服務的功能,而無需直接訪問實現(源代碼、網絡訪問、文檔)。其中一個目標是盡量減少連接取消關聯的服務所需的工作量。另一個目標是減少準確記錄服務所需的時間。

Nswag VS Swashbuckle?

.NET Swagger 實現類庫有兩個比較流行:

  • Swashbuckle.AspNetCore 是一個開源項目,用於生成 ASP.NET Core Web API 的 Swagger 文檔。

  • NSwag 是另一個用於生成 Swagger 文檔並將 Swagger UI 或 ReDoc 集成到 ASP.NET Core Web API 中的開源項目。此外,NSwag 還提供了為 API 生成 C# 和 TypeScript 客戶端代碼的方法。


為什麼我在.NET core3.0中選擇NSwag呢,NSwag比較活躍,一直在更新,功能也很強大,可以完美的代替Swashbuckle.AspNetCore具體可以參考:https://github.com/aspnet/AspNetCore.Docs/issues/4258

一、利用Nswag生成Api文檔

步驟
  1. 創建Asp.NET Core Api項目,並且集成NSwag

  2. 配置項目

  3. 運行項目

創建Asp.NET Core Api項目,並且集成NSwag

我們將簡單的創建一個ASP.NET core API項目。將其命名為“WebAPIwithSwg”。基於.NETcore3.0

安裝nuget包NSwag.AspNetCore

接下來,在Startup.cs文件中配置Nswag服務和中間件。

在ConfigureServices方法中添加服務

  public void ConfigureServices(IServiceCollection services)
        {
            services.AddControllers();
            services.AddSwaggerDocument(); //註冊Swagger 服務
        }
在Configure方法中添加Nswag中間件
 public void Configure(IApplicationBuilder app, IWebHostEnvironment env)
        {
            if (env.IsDevelopment())
            {
                app.UseDeveloperExceptionPage();
            }
            app.UseRouting();
            app.UseAuthorization();
            app.UseEndpoints(endpoints =>
            {
                endpoints.MapControllers();
            });
            app.UseOpenApi(); //添加swagger生成api文檔(默認路由文檔 /swagger/v1/swagger.json)
            app.UseSwaggerUi3();//添加Swagger UI到請求管道中(默認路由: /swagger).
        }
配置項目

運行項目

右鍵項目在瀏覽器中查看,查看swagger UI需要在url後面添加“/swagger”。本示例http://localhost:54117/swagger

二、利用NSwagStudio如何生成客戶端代碼,並且進行測試
提供GUI界面是NSwag的一大特點,只需要下載安裝NSwagStudio,即可生成客戶端代碼。
步驟
  1. 現在安裝NSwagStudio

  2. NSwagStudio配置,生成客戶端代碼

  3. 創建測試客戶端項目

下載安裝NSwagStudio

下載NSwag Studio http://rsuter.com/Projects/NSwagStudio/installer.php 安裝之後打開 NSwag Studio 如圖

NSwagStudio配置,生成客戶端代碼

選擇runtime,我選擇的是NETCore30,切換OpenAPI/Swagger Specification ,在Specification URL 輸入你的Swagger.json路徑,本示例:http://localhost:54117/swagger/v1/swagger.json輸入路徑之後,點擊 create local copy 按鈕獲取json。

接下配置來生成客戶端代碼。我們首先選擇“csharp client”複選框,然後勾選掉 “Inject Http Client via Constructor (life cycle is managed by caller)” ,最後設置下輸出路徑 點擊生成文件(Generate Files)。步驟如下

到此客戶端代碼已經自動生成。

查看生成的部分代碼


public async System.Threading.Tasks.Task<System.Collections.Generic.ICollection<WeatherForecast>> GetAsync(System.Threading.CancellationToken cancellationToken)
        {
            var urlBuilder_ = new System.Text.StringBuilder();
            urlBuilder_.Append(BaseUrl != null ? BaseUrl.TrimEnd('/') : "").Append("/WeatherForecast");
    
            var client_ = new System.Net.Http.HttpClient();
            try
            {
                using (var request_ = new System.Net.Http.HttpRequestMessage())
                {
                    request_.Method = new System.Net.Http.HttpMethod("GET");
                    request_.Headers.Accept.Add(System.Net.Http.Headers.MediaTypeWithQualityHeaderValue.Parse("application/json"));
    
                    PrepareRequest(client_, request_, urlBuilder_);
                    var url_ = urlBuilder_.ToString();
                    request_.RequestUri = new System.Uri(url_, System.UriKind.RelativeOrAbsolute);
                    PrepareRequest(client_, request_, url_);
    
                    var response_ = await client_.SendAsync(request_, System.Net.Http.HttpCompletionOption.ResponseHeadersRead, cancellationToken).ConfigureAwait(false);
                    try
                    {
                        var headers_ = System.Linq.Enumerable.ToDictionary(response_.Headers, h_ => h_.Key, h_ => h_.Value);
                        if (response_.Content != null && response_.Content.Headers != null)
                        {
                            foreach (var item_ in response_.Content.Headers)
                                headers_[item_.Key] = item_.Value;
                        }
    
                        ProcessResponse(client_, response_);
    
                        var status_ = ((int)response_.StatusCode).ToString();
                        if (status_ == "200") 
                        {
                            var objectResponse_ = await ReadObjectResponseAsync<System.Collections.Generic.ICollection<WeatherForecast>>(response_, headers_).ConfigureAwait(false);
                            return objectResponse_.Object;
                        }
                        else
                        if (status_ != "200" && status_ != "204")
                        {
                            var responseData_ = response_.Content == null ? null : await response_.Content.ReadAsStringAsync().ConfigureAwait(false); 
                            throw new ApiException("The HTTP status code of the response was not expected (" + (int)response_.StatusCode + ").", (int)response_.StatusCode, responseData_, headers_, null);
                        }
            
                        return default(System.Collections.Generic.ICollection<WeatherForecast>);
                    }
                    finally
                    {
                        if (response_ != null)
                            response_.Dispose();
                    }
                }
            }
            finally
            {
                if (client_ != null)
                    client_.Dispose();
            }
        }
創建測試客戶端項目

創建一個控製程序項目,命名“WebApiClient”。

把自動生成的類“WeatherForecastClient”添加到客戶端項目中,然後安裝Newtonsoft

最後在Main函數中添加測試代碼,開始使用Api。

 static async System.Threading.Tasks.Task Main(string[] args)
        {

            var weatherForecastClient = new WeatherForecastClient();
            //gets all values from the API
            var allValues = await weatherForecastClient.GetAsync();
            Console.WriteLine("Hello World!");
        }

運行客戶端應用程序,進行調用api

當然如果需要調試api項目內部代碼,可以設置斷點,進入一步一步的調試

小結:NSwag 功能遠不止這些,本篇文章演示了如何生成api文檔和自動生成的api客戶端代碼方便我們調試,也可以作為對應的sdk。

參考:微軟官方文檔—https://docs.microsoft.com/zh-cn/aspnet/core/tutorials/getting-started-with-nswag?view=aspnetcore-2.2&tabs=visual-studio

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享