ASP.NET Aries 高級開發教程:如何寫WebAPI接口

前提:

最近,有不少同學又問到,Aries里如何提供WebAPI接口?

針對這個問題,今天給順路寫個教程,其實呢,很簡單的。

方式一:直接用WebService提供接口。

用這種方式,直接添加接口就可以了,Aries只是默認處理了.html後綴的請求。對於WS的asmx後綴是沒有影響的,所以傳統怎麼添加就怎麼添加。


方式二:單獨用Taurus.MVC寫一個接口項目。

用這種方式,就是把接口獨立成一個項目,然後通過IIS部署成子應用程序就可以了。

只是部署成子應用程序的時候,需要注意一下子目錄和根目錄的web.config,出現重複的只能留根目錄的那個。

(一般都會建議用戶用這種方式,好處是可以在IIS里學會一下怎麼部署子應用程序。)

方式三:在Aries引入Taurus.MVC即可。

這個方式,其實也很簡單,下面介紹一下簡單的部署:

1、引用Taurus.MVC用於寫WebAPI:

在Web.UI項目添加引用Taurus.Core.dll(可以在Nuget上引用,也可以引用源碼項目再引用項目)

2、配置Taurus.MVC的兩個必備項:

A、在HttpModule中添加URL攔截。

//這是原來有的: 
<add name="Aries.Core" type="Aries.Core.UrlRewrite,Aries.Core" />
//這是新添加的:
 <add name="Taurus.Core" type="Taurus.Core.UrlRewrite,Taurus.Core"/>

B、在AppSetting中設置路徑模式:

<!--配置模式【值為0,1或2】[默認為1]
      值為0:匹配{Action}/{Para}
      值為1:匹配{Controller}/{Action}/{Para}
      值為2:匹配{Module}/{Controller}/{Action}/{Para}-->
    <add key="Taurus.RouteMode" value="1"/>

C、在AppSetting中設置接口代碼所在的項目:

<!--指定控制器所在的項目(Dll)名稱(可改,項目編繹的dll叫什麼名就寫什麼)
    <add key="Taurus.Controllers" value="Taurus.Controllers"/>-->


如果是用Nuget上引用的,默認都會有上面的兩個,其它默認生的,可以註釋掉。

3、開始寫應用接口代碼:

接口代碼寫在哪裡呢?放在哪個項目都可以,只要上面C點的配置指向就可以了,如果接口代碼分散在多個項目中,配置的value可以用“逗號”分隔。

按Taurus.MVC的方式寫接口,繼承自Taurus.Core.Controller即可:

如:

  /// <summary>
    /// API 接口
    /// </summary>
    public  class APIController : Taurus.Core.Controller
    {
        public void Hello()
        {
            Write("hello Controllers.API");
        }
    }

接口訪問:http://…/api/hello

總結說明:

Aries中默認處理的是.html後綴。

Taurus默認處理的是無後綴。

所以兩者並無衝突,直接引用,加配置就可以了,沒你想的複雜。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

讀寫分離很難嗎?springboot結合aop簡單就實現了

目錄

前言

入職新公司到現在也有一個月了,完成了手頭的工作,前幾天終於有時間研究下公司舊項目的代碼。在研究代碼的過程中,發現項目里用到了Spring Aop來實現數據庫的讀寫分離,本着自己愛學習(我自己都不信…)的性格,決定寫個實例工程來實現spring aop讀寫分離的效果。

環境部署

數據庫:MySql

庫數量:2個,一主一從

關於mysql的主從環境部署之前已經寫過文章介紹過了,這裏就不再贅述,參考

開始項目

首先,毫無疑問,先開始搭建一個SpringBoot工程,然後在pom文件中引入如下依賴:

<dependencies>
        <dependency>
            <groupId>com.alibaba</groupId>
            <artifactId>druid-spring-boot-starter</artifactId>
            <version>1.1.10</version>
        </dependency>
        <dependency>
            <groupId>org.mybatis.spring.boot</groupId>
            <artifactId>mybatis-spring-boot-starter</artifactId>
            <version>1.3.2</version>
        </dependency>
        <dependency>
            <groupId>tk.mybatis</groupId>
            <artifactId>mapper-spring-boot-starter</artifactId>
            <version>2.1.5</version>
        </dependency>
        <dependency>
            <groupId>mysql</groupId>
            <artifactId>mysql-connector-java</artifactId>
            <version>8.0.16</version>
        </dependency>
        <!-- 動態數據源 所需依賴 ### start-->
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-jdbc</artifactId>
            <scope>provided</scope>
        </dependency>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-aop</artifactId>
            <scope>provided</scope>
        </dependency>
        <!-- 動態數據源 所需依賴 ### end-->
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>
        <dependency>
            <groupId>org.projectlombok</groupId>
            <artifactId>lombok</artifactId>
            <optional>true</optional>
        </dependency>
        <dependency>
            <groupId>com.alibaba</groupId>
            <artifactId>fastjson</artifactId>
            <version>1.2.4</version>
        </dependency>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-test</artifactId>
            <scope>test</scope>
        </dependency>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-data-jpa</artifactId>
        </dependency>
    </dependencies>

目錄結構

引入基本的依賴后,整理一下目錄結構,完成后的項目骨架大致如下:

建表

創建一張表user,在主庫執行sql語句同時在從庫生成對應的表數據

DROP TABLE IF EXISTS `user`;
CREATE TABLE `user` (
  `user_id` bigint(20) NOT NULL COMMENT '用戶id',
  `user_name` varchar(255) DEFAULT '' COMMENT '用戶名稱',
  `user_phone` varchar(50) DEFAULT '' COMMENT '用戶手機',
  `address` varchar(255) DEFAULT '' COMMENT '住址',
  `weight` int(3) NOT NULL DEFAULT '1' COMMENT '權重,大者優先',
  `created_at` datetime NOT NULL DEFAULT CURRENT_TIMESTAMP COMMENT '創建時間',
  `updated_at` datetime DEFAULT CURRENT_TIMESTAMP ON UPDATE CURRENT_TIMESTAMP COMMENT '更新時間',
  PRIMARY KEY (`user_id`)
) ENGINE=InnoDB DEFAULT CHARSET=utf8;

INSERT INTO `user` VALUES ('1196978513958141952', '測試1', '18826334748', '廣州市海珠區', '1', '2019-11-20 10:28:51', '2019-11-22 14:28:26');
INSERT INTO `user` VALUES ('1196978513958141953', '測試2', '18826274230', '廣州市天河區', '2', '2019-11-20 10:29:37', '2019-11-22 14:28:14');
INSERT INTO `user` VALUES ('1196978513958141954', '測試3', '18826273900', '廣州市天河區', '1', '2019-11-20 10:30:19', '2019-11-22 14:28:30');

主從數據源配置

application.yml,主要信息是主從庫的數據源配置

server:
  port: 8001
spring:
  jackson:
    date-format: yyyy-MM-dd HH:mm:ss
    time-zone: GMT+8
  datasource:
    type: com.alibaba.druid.pool.DruidDataSource
    driver-class-name: com.mysql.cj.jdbc.Driver
    master:
      url: jdbc:mysql://127.0.0.1:3307/user?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true&failOverReadOnly=false&useSSL=false&zeroDateTimeBehavior=convertToNull&allowMultiQueries=true
      username: root
      password:
    slave:
      url: jdbc:mysql://127.0.0.1:3308/user?serverTimezone=Asia/Shanghai&useUnicode=true&characterEncoding=UTF-8&autoReconnect=true&failOverReadOnly=false&useSSL=false&zeroDateTimeBehavior=convertToNull&allowMultiQueries=true
      username: root
      password:

因為有一主一從兩個數據源,我們用枚舉類來代替,方便我們使用時能對應

@Getter
public enum DynamicDataSourceEnum {
    MASTER("master"),
    SLAVE("slave");
    private String dataSourceName;
    DynamicDataSourceEnum(String dataSourceName) {
        this.dataSourceName = dataSourceName;
    }
}

數據源配置信息類 DataSourceConfig,這裏配置了兩個數據源,masterDb和slaveDb

@Configuration
@MapperScan(basePackages = "com.xjt.proxy.mapper", sqlSessionTemplateRef = "sqlTemplate")
public class DataSourceConfig {
    
     // 主庫
      @Bean
      @ConfigurationProperties(prefix = "spring.datasource.master")
      public DataSource masterDb() {
  return DruidDataSourceBuilder.create().build();
      }

    /**
     * 從庫
     */
    @Bean
    @ConditionalOnProperty(prefix = "spring.datasource", name = "slave", matchIfMissing = true)
    @ConfigurationProperties(prefix = "spring.datasource.slave")
    public DataSource slaveDb() {
        return DruidDataSourceBuilder.create().build();
    }

    /**
     * 主從動態配置
     */
    @Bean
    public DynamicDataSource dynamicDb(@Qualifier("masterDb") DataSource masterDataSource,
        @Autowired(required = false) @Qualifier("slaveDb") DataSource slaveDataSource) {
        DynamicDataSource dynamicDataSource = new DynamicDataSource();
        Map<Object, Object> targetDataSources = new HashMap<>();
        targetDataSources.put(DynamicDataSourceEnum.MASTER.getDataSourceName(), masterDataSource);
        if (slaveDataSource != null) {
            targetDataSources.put(DynamicDataSourceEnum.SLAVE.getDataSourceName(), slaveDataSource);
        }
        dynamicDataSource.setTargetDataSources(targetDataSources);
        dynamicDataSource.setDefaultTargetDataSource(masterDataSource);
        return dynamicDataSource;
    }
    @Bean
    public SqlSessionFactory sessionFactory(@Qualifier("dynamicDb") DataSource dynamicDataSource) throws Exception {
        SqlSessionFactoryBean bean = new SqlSessionFactoryBean();
        bean.setMapperLocations(
            new PathMatchingResourcePatternResolver().getResources("classpath*:mapper/*Mapper.xml"));
        bean.setDataSource(dynamicDataSource);
        return bean.getObject();
    }
    @Bean
    public SqlSessionTemplate sqlTemplate(@Qualifier("sessionFactory") SqlSessionFactory sqlSessionFactory) {
        return new SqlSessionTemplate(sqlSessionFactory);
    }
    @Bean(name = "dataSourceTx")
    public DataSourceTransactionManager dataSourceTx(@Qualifier("dynamicDb") DataSource dynamicDataSource) {
        DataSourceTransactionManager dataSourceTransactionManager = new DataSourceTransactionManager();
        dataSourceTransactionManager.setDataSource(dynamicDataSource);
        return dataSourceTransactionManager;
    }
}

設置路由

設置路由的目的為了方便查找對應的數據源,我們可以用ThreadLocal保存數據源的信息到每個線程中,方便我們需要時獲取

public class DataSourceContextHolder {
    private static final ThreadLocal<String> DYNAMIC_DATASOURCE_CONTEXT = new ThreadLocal<>();
    public static void set(String datasourceType) {
        DYNAMIC_DATASOURCE_CONTEXT.set(datasourceType);
    }
    public static String get() {
        return DYNAMIC_DATASOURCE_CONTEXT.get();
    }
    public static void clear() {
        DYNAMIC_DATASOURCE_CONTEXT.remove();
    }
}

獲取路由

public class DynamicDataSource extends AbstractRoutingDataSource {
    @Override
    protected Object determineCurrentLookupKey() {
        return DataSourceContextHolder.get();
    }
}

AbstractRoutingDataSource的作用是基於查找key路由到對應的數據源,它內部維護了一組目標數據源,並且做了路由key與目標數據源之間的映射,提供基於key查找數據源的方法。

數據源的註解

為了可以方便切換數據源,我們可以寫一個註解,註解中包含數據源對應的枚舉值,默認是主庫,

@Retention(RetentionPolicy.RUNTIME)
@Target(ElementType.METHOD)
@Documented
public @interface DataSourceSelector {

    DynamicDataSourceEnum value() default DynamicDataSourceEnum.MASTER;
    boolean clear() default true;
}

aop切換數據源

到這裏,aop終於可以現身出場了,這裏我們定義一個aop類,對有註解的方法做切換數據源的操作,具體代碼如下:

@Slf4j
@Aspect
@Order(value = 1)
@Component
public class DataSourceContextAop {

 @Around("@annotation(com.xjt.proxy.dynamicdatasource.DataSourceSelector)")
    public Object setDynamicDataSource(ProceedingJoinPoint pjp) throws Throwable {
        boolean clear = true;
        try {
            Method method = this.getMethod(pjp);
            DataSourceSelector dataSourceImport = method.getAnnotation(DataSourceSelector.class);
            clear = dataSourceImport.clear();
            DataSourceContextHolder.set(dataSourceImport.value().getDataSourceName());
            log.info("========數據源切換至:{}", dataSourceImport.value().getDataSourceName());
            return pjp.proceed();
        } finally {
            if (clear) {
                DataSourceContextHolder.clear();
            }

        }
    }
    private Method getMethod(JoinPoint pjp) {
        MethodSignature signature = (MethodSignature)pjp.getSignature();
        return signature.getMethod();
    }

}

到這一步,我們的準備配置工作就完成了,下面開始測試效果。

先寫好Service文件,包含讀取和更新兩個方法,

@Service
public class UserService {

    @Autowired
    private UserMapper userMapper;

    @DataSourceSelector(value = DynamicDataSourceEnum.SLAVE)
    public List<User> listUser() {
        List<User> users = userMapper.selectAll();
        return users;
    }

    @DataSourceSelector(value = DynamicDataSourceEnum.MASTER)
    public int update() {
        User user = new User();
        user.setUserId(Long.parseLong("1196978513958141952"));
        user.setUserName("修改后的名字2");
        return userMapper.updateByPrimaryKeySelective(user);
    }

    @DataSourceSelector(value = DynamicDataSourceEnum.SLAVE)
    public User find() {
        User user = new User();
        user.setUserId(Long.parseLong("1196978513958141952"));
        return userMapper.selectByPrimaryKey(user);
    }
}

根據方法上的註解可以看出,讀的方法走從庫,更新的方法走主庫,更新的對象是userId為1196978513958141953 的數據,

然後我們寫個測試類測試下是否能達到效果,

@RunWith(SpringRunner.class)
@SpringBootTest
class UserServiceTest {

    @Autowired
    UserService userService;

    @Test
    void listUser() {
        List<User> users = userService.listUser();
        for (User user : users) {
            System.out.println(user.getUserId());
            System.out.println(user.getUserName());
            System.out.println(user.getUserPhone());
        }
    }
    @Test
    void update() {
        userService.update();
        User user = userService.find();
        System.out.println(user.getUserName());
    }
}

測試結果:

1、讀取方法

2、更新方法

執行之後,比對數據庫就可以發現主從庫都修改了數據,說明我們的讀寫分離是成功的。當然,更新方法可以指向從庫,這樣一來就只會修改到從庫的數據,而不會涉及到主庫。

注意

上面測試的例子雖然比較簡單,但也符合常規的讀寫分離配置。值得說明的是,讀寫分離的作用是為了緩解寫庫,也就是主庫的壓力,但一定要基於數據一致性的原則,就是保證主從庫之間的數據一定要一致。如果一個方法涉及到寫的邏輯,那麼該方法里所有的數據庫操作都要走主庫。

假設寫的操作執行完后數據有可能還沒同步到從庫,然後讀的操作也開始執行了,如果這個讀取的程序走的依然是從庫的話,那麼就會出現數據不一致的現象了,這是我們不允許的。

最後發一下項目的github地址,有興趣的同學可以看下,記得給個star哦

地址:

參考:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選
4 個概念,1 個動作,讓應用管理變得更簡單

作者:
劉洋(炎尋) EDAS-OAM 架構與開發負責人
鄧洪超  OAM spec maintainer
孫健波(天元)  OAM spec maintainer

隨着以 K8s 為主的雲原生基礎架構遍地生根,越來越多的團隊開始基於 K8s 搭建持續部署、自助式發布體驗的應用管理平台。然而,在 K8s 交付和管理應用方面,目前還缺乏一個統一的標準,這最終促使我們與微軟聯合推出了首個雲原生應用標準定義與架構模型 – OAM。本文作者將從基本概念以及各個模塊的封裝設計與用法等角度出發來詳細解讀 OAM。

OAM 主要有三個特點:

  • 開發和運維關注點分離:開發者關注業務邏輯,運維人員關注運維能力,讓不同角色更專註於領域知識和能力;
  • 平台無關與高可擴展:應用定義與平台實現解耦,應用描述支持跨平台實現和可擴展性;
  • 模塊化應用部署和運維特徵:應用部署和運維能力可以描述成高層抽象模塊,開發和運維可以自由組合和支持模塊化實現。

OAM 綜合考慮了在公有雲、私有雲以及邊緣雲上應用交付的解決方案,提出了通用的模型,讓各平台可以在統一的高層抽象上透出應用部署和運維能力,解決跨平台的應用交付問題。同時,OAM 以標準化的方式溝通和連接應用開發者、運維人員、應用基礎設施,讓雲原生應用交付和管理流程更加連貫、一致。

角色分類

OAM 將應用相關的人員劃分為 3 個角色:

  • 應用開發:關注應用代碼開發和運行配置,是應用代碼的領域專家,應用開發完成后打包(比如鏡像)交給應用運維;

  • 應用運維:關注配置和運行應用實例的生命周期,比如灰度發布、監控、報警等操作,是應用運維專家;

  • 平台運維:關注應用運行平台的能力和穩定性,是底層(比如 Kubernetes 運維/優化,OS 等)的領域專家。

核心概念

OAM 包含以下核心概念:

服務組件(Component Schematics)

應用開發使用服務組件來聲明應用的屬性(配置項),運維人員定義這些屬性之後就能按照組件聲明得到運行的組件實例,組件聲明包含以下信息:

  • 工作負載類型(Workload type):表明該組件運行時的工作負載依賴;
  • 元數據(Metadata):面向組件用戶的一些描述性信息;
  • 資源需求(Resource requirements):組件運行的最小資源需求,比如最小內存,CPU 和文件掛載需求;
  • 參數(Parameters):可以被運維人員配置的參數;
  • 工作負載定義(Workload definition):工作負載運行的一些定義,比如可運行包定義(ICO images, Function等)。

應用邊界(Application Scopes)

運維人員使用應用邊界將組件組成松耦合的應用,可以賦予這組組件一些共用的屬性和依賴,應用邊界聲明包含以下信息:

  • 元數據(Metadata):面嚮應用邊界用戶的一些描述性信息。
  • 類型(Type):邊界類型,不同類型提供不同的能力;
  • 參數(Parameters):可以被運維人員配置的參數。

運維特徵(Traits)

運維人員使用運維特徵賦予組件實例特定的運維能力,比如自動擴縮容,一個 Trait 可能僅限特定的工作負載類型,它們代表了系統運維方面的特性,而不是開發的特性,比如開發者知道自己的組件是否可以擴縮容,但是運維可以決定是手動擴縮容還是自動擴縮容,特徵聲明包含以下信息:

  • 元數據(Metadata):面向特徵用戶的一些描述性信息;
  • 適用工作負載列表(Applies-to list):該特徵可以應用的工作負載列表;
  • 屬性(Properties):可以被運維人員配置的屬性。

工作負載類型和配置(Workload types and configurations)

描述特定工作負載的底層運行時,平台需要能夠提供對應工作負載的運行時,工作負載聲明包含以下信息:

  • 元數據(Metadata):面向工作負載用戶的一些描述性信息;
  • 工作負載設置(Workload Setting):可以被運維人員配置的設置。

應用配置(Application configuration)

運維人員使用應用配置將組件、特徵和應用邊界的組合在一起實例化部署,應用配置聲明包含以下信息:

  • 元數據(Metadata):面嚮應用配置用戶的一些描述性信息;
  • 參數覆蓋(Parameter overrides):可以理解為變量定義,可以被組件、特徵、應用邊界的參數引用;
  • 組件設置(Component):構成應用的全部組件都在這裏設置;
  • 綁定組件的運維特徵配置(Trait Configuration):綁定的特徵列表及其參數。

OAM 認為:

一個雲原生應用由一組相互關聯但又離散獨立的組件構成,這些組件實例化在合適的運行時上,由配置來控制行為並共同協作提供統一的功能。

更加具體的說:

一個 Application 由一組 Components 構成,每個 Component 的運行時由 Workload 描述,每個 Component 可以施加 Traits 來獲取額外的運維能力,同時我們可以使用 Application scopes 將 Components 劃分到 1 或者多個應用邊界中,便於統一做配置、限制、管理。

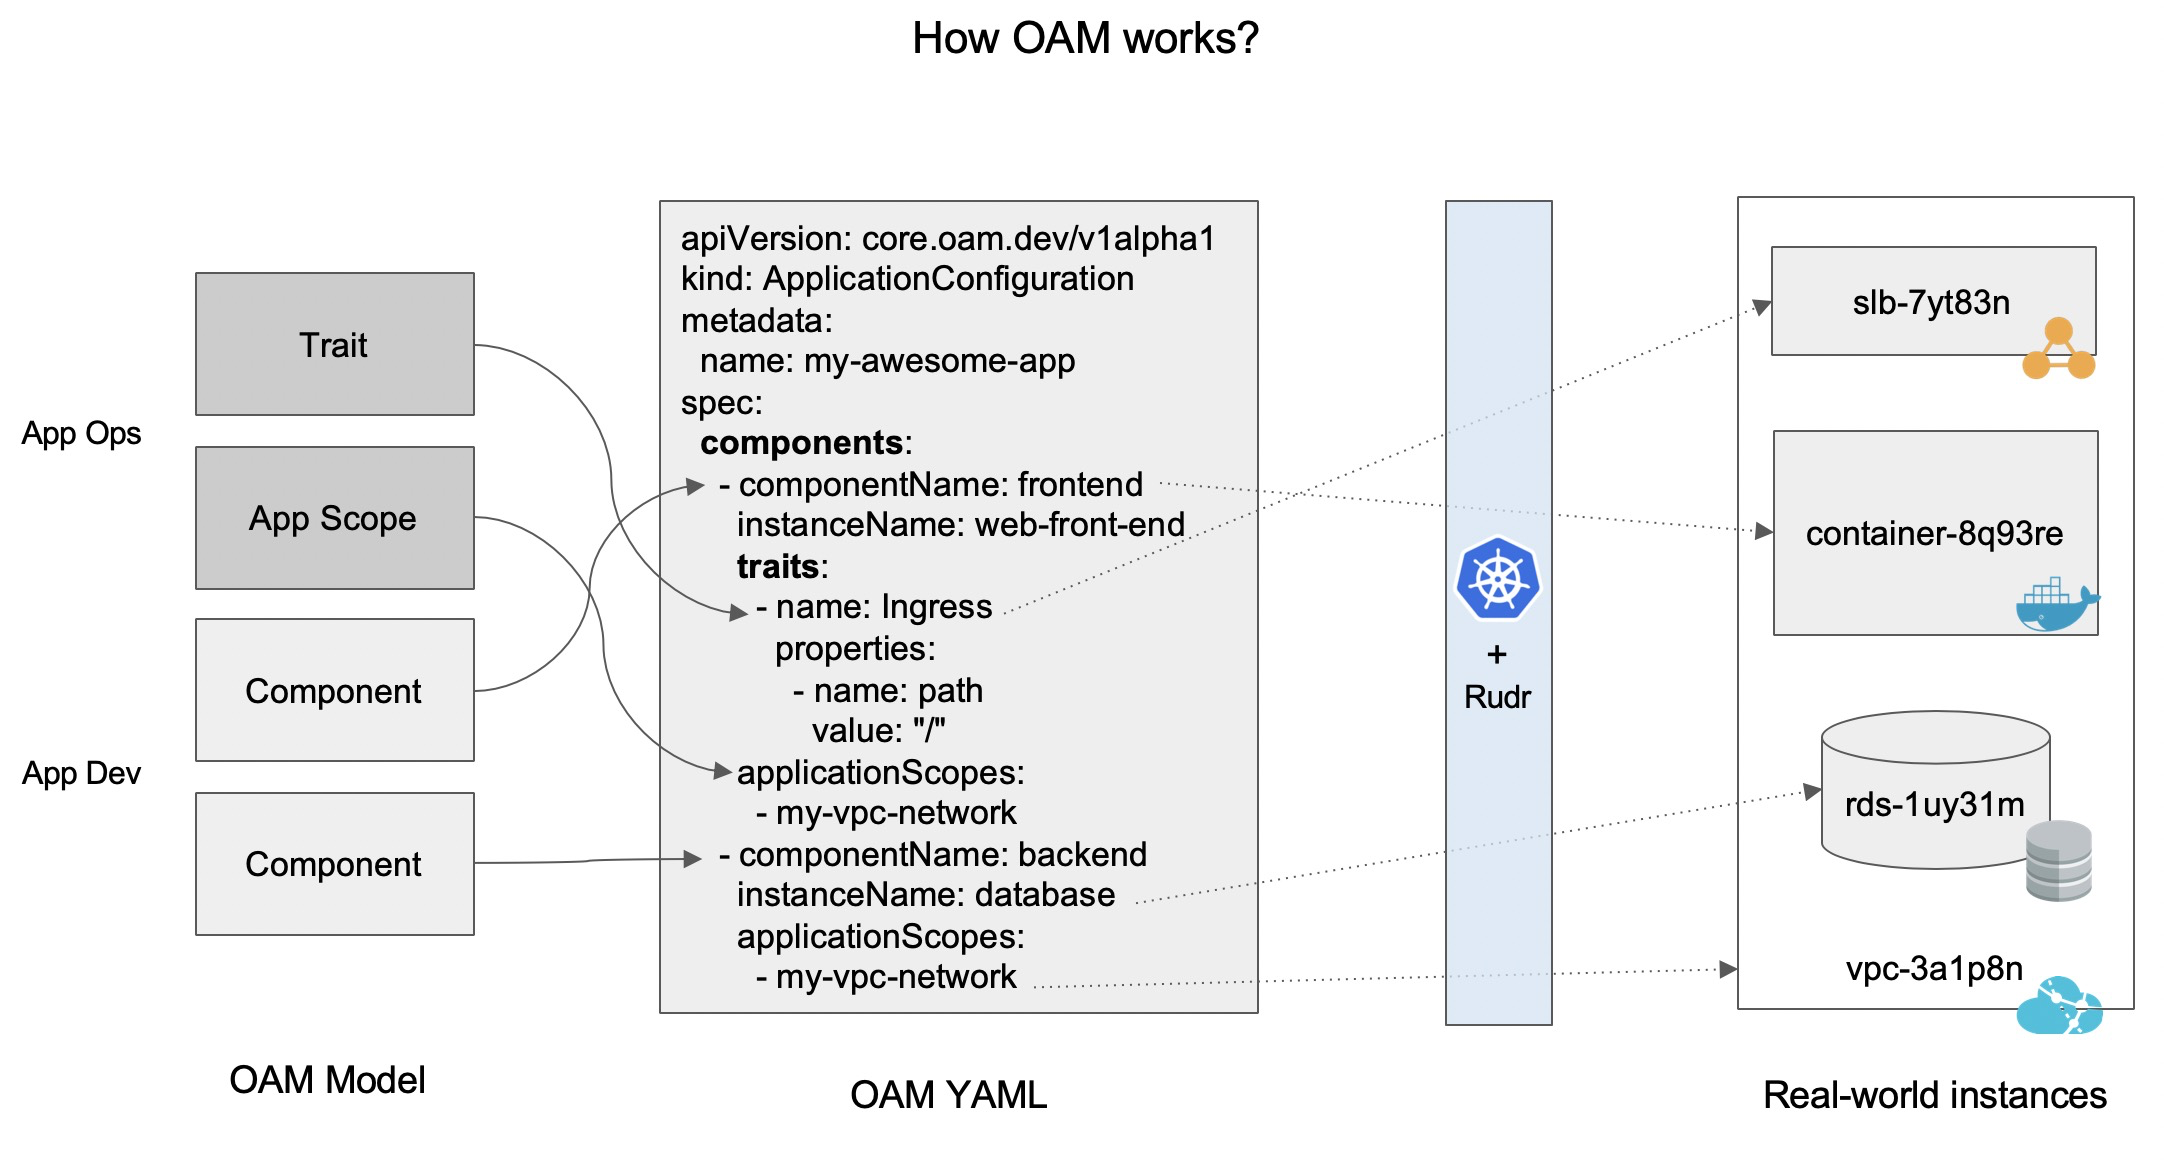
整體的運行模式如下所示:

組件、運維特徵、應用邊界通過應用配置(Application Configuration)實例化,然後再通過 OAM 的實現層翻譯為真實的資源。

怎麼用?

使用 OAM 來管理雲原生應用,其核心主要是圍繞着“四個概念,一個動作”。

四個概念

  • 應用組件(包含對工作負載的依賴聲明);【開發人員關心】
  • 工作負載;【平台關心】
  • 運維特徵;【平台關心】
  • 應用邊界;【平台關心】

一個動作

  • 下發應用配置;【運維人員關心】

下發應用配置之後 OAM 平台將會實例化四個概念得到運行的應用。
 
一個 OAM 平台在對外提供 OAM 應用管理界面時,一定是預先已經準備好了“運維特徵,應用邊界”供運維人員使用,準備好了“工作負載”供開發者使用,同時開發者準備“組件”供運維人員使用。因此角色劃分就很明了:

  • 開發者提供組件,使用平台的工作負載;
  • 運維人員關注一個動作實例化四個概念;
  • 平台方需要提供工作負載,運維特徵,應用邊界,並且託管用戶的應用組件;

例子

如何使用上面“四個概念,一個動作”來部署一個 OAM 應用呢?

我們假想一個場景,用戶的應用有兩個組件:frontend 和 backend,其中 frontend 組件需要域名訪問、自動擴縮容能力,並且 frontend 要訪問 backend,兩者應該在同一個 vpc 內,基於這個場景我們需要有:

  • 開發者創建 2 個組件

frontend 的 workload 類型是 Server 容器服務(OAM 平台提供該工作負載):

apiVersion: core.oam.dev/v1alpha1
kind: ComponentSchematic
metadata:
  name: frontend
  annotations:
    version: v1.0.0
    description: "A simple webserver"
spec:
  workloadType: core.oam.dev/v1.Server
  parameters:
    - name: message
      description: The message to display in the web app.
      type: string
      value: "Hello from my app, too"
  containers:
    - name: web
      env:
        - name: MESSAGE
          fromParam: message
      image:
        name: example/charybdis-single:latest

backend 的 workload 是 Cassandra(OAM 平台提供該工作負載):

apiVersion: core.oam.dev/v1alpha1
kind: ComponentSchematic
metadata:
  name: backend
  annotations:
    version: v1.0.0
    description: "Cassandra database"
spec:
  workloadType: data.oam.dev/v1.Cassandra
  parameters:
    - name: maxStalenessPrefix
      description: Max stale requests.
      type: int
      value: 100000
    - name: defaultConsistencyLevel
      description: The default consistency level
      type: string
      value: "Eventual"
  workloadSettings:
    - name: maxStalenessPrefix
      fromParam: maxStalenessPrefix
    - name: defaultConsistencyLevel
      fromParam: defaultConsistencyLevel


  • OAM 平台提供 Ingress Trait
apiVersion: core.oam.dev/v1alpha1
kind: Trait
metadata:
  name: Ingress
spec:
  type: core.oam.dev/v1beta1.Ingress
  appliesTo:
    - core.oam.dev/v1alpha1.Server
  parameters:
    properties: |
      {
        "$schema": "http://json-schema.org/draft-07/schema#",
        "type": "object",
        "properties": {
          "host": {
            "type": "string",
            "description": "ingress hosts",
          },
          "path": {
            "type": "string",
            "description": "ingress path",
          }
        }
      }


  • OAM 平台提供網絡應用邊界
apiVersion: core.oam.dev/v1alpha1
kind: ApplicationScope
metadata:
  name: network
  annotations:
    version: v1.0.0
    description: "network boundary that a group components reside in"
spec:
  type: core.oam.dev/v1.NetworkScope
  allowComponentOverlap: false
  parameters:
    - name: network-id
      description: The id of the network, e.g. vpc-id, VNet name.
      type: string
      required: Y
    - name: subnet-ids
      description: >
        A comma separated list of IDs of the subnets within the network. For example, "vsw-123" or ""vsw-123,vsw-456".
        There could be more than one subnet because there is a limit in the number of IPs in a subnet.
        If IPs are taken up, operators need to add another subnet into this network.
      type: string
      required: Y
    - name: internet-gateway-type
      description: The type of the gateway, options are 'public', 'nat'. Empty string means no gateway.
      type: string
      required: N


apiVersion: core.oam.dev/v1alpha1
kind: ApplicationConfiguration
metadata:
  name: my-vpc-network
spec:
  variables:
    - name: networkName
      value: "my-vpc"
  scopes:
    - name: network
      type: core.oam.dev/v1alpha1.Network
      properties:
        - name: network-id
          value: "[fromVariable(networkName)]"
        - name: subnet-ids
          value: "my-subnet1, my-subnet2"


  • 應用運維部署整個應用

使用應用配置將上面的組件、邊界、特徵組合起來即可部署一個應用,這個由應用的運維人員提供:

apiVersion: core.oam.dev/v1alpha1
kind: ApplicationConfiguration
metadata:
  name: custom-single-app
  annotations:
    version: v1.0.0
    description: "Customized version of single-app"
spec:
  variables:
    - name: message
      value: "Well hello there"
    - name: domainName
      value: "www.example.com"
  components:
    - componentName: frontend
      instanceName: web-front-end
      parameterValues:
        - name: message
          value: "[fromVariable(message)]"
      traits:
        - name: Ingress
          properties:
            - name: host
              value: "[fromVaraible(domainName)]"
            - name: path
              value: "/"
      applicationScopes:
        - my-vpc-network

    - componentName: backend
      instanceName: database
      applicationScopes:
        - my-vpc-network

通過以上完整的使用流程我們可以看到:應用配置是真正部署應用的起點,在使用該配置的時候,對應的組件、應用邊界、特徵都要提前部署好,運維人員只需做一個組合即可。

服務組件(Component Schematic)

服務組件的意義是讓開發者聲明離散執行單元的運行時特性,可以用 JSON/YAML 格式來表示,其聲明遵循 Kubernetes API 規範,區別在於:

  • 定義字段是 Kubernetes 的子集,因為 OAM 是更高的抽象;
  • OAM Spec 的底層運行時可以不是 Kubernetes

下面我們來看看具體的組件聲明如何定義。

定義

頂層屬性

屬性 類型 必填 默認值 描述
apiVersion string Y 特定oam spec版本,比如core.oam.dev/v1
kind string Y 類型,對於組件來說就是
ComponentSchematic
metadata Metadata Y 組件元數據
spec Spec Y 組件特定的定義屬性

Metadata

屬性 類型 必填 默認值 描述
name string Y
labels map[string]string N k/v對作為組件的lebels
annotations map[string]string N k/v對作為組件的描述信息

Spec

屬性 類型 必填 默認值 描述
parameters []Parameter N 組件的可配置項
workloadType string Y 簡明語義化的組件運行時描述,以K8s為例就是指定底層使用StatefulSet還是Deployment這樣
osType string N linux 組件容器運行時依賴的操作系統類型,可選值:
– linux
– windows
arch string N amd64 組件容器運行時依賴的CPU架構,可選值:
– i386
– amd64
– arm
– arm64
containers []Container N 實現組件的OCI容器們
workloadSettings []WorkloadSettings N 需要傳給工作負載運行時的非容器配置聲明

上面的 workloadType 後面會有詳細說明,這裏簡要來說就是開發者可以指定該 field 告訴運行時該組件如何被執行。工作負載命名的規範是 GROUP/VERSION.KIND,和 K8s 資源類型坐標一致,比如:

  • core.oam.dev/v1alpha1.Singleton

core.oam.dev 表示是 oam 內置的分組,oam 內置的表示任何 OAM 實現都支持該類型的工作負載,v1alpha1 表示依舊是 alpha 狀態,類型是 Singleton,這表示運行時應該只運行一個組件實例,無論誰提供。

  • alibabacloud.com/v1.Function

alibabacloud.com 表示該對象是一個運營商特定的實現,不一定所有平台都實現,版本 v1 表示實現已經穩定,類型是 Function 表示運行時是 Alibaba Functions 提供的。

  • streams.oam.io/v1beta2.Kafka

表示該對象是一個第三方組織實現,不一定所有平台都實現,版本 v1beta2 表示實現已經趨於穩定,類型是 Kafka 表示運行時是開源組件 Kafka 提供的。

工作負載主要分為兩類:

  • 核心工作負載類型

屬於 core.oam.dev 分組,所有對象都需要 oam 平台實現,都是容器運行時,該 Spec 目前定義了如下核心工作負載類型:

名字 類型 是否對外提供服務 是否可以多副本運行 是否常駐
Server core.oam.dev/v1alpha1.Server Y Y Y
Singleton Server core.oam.dev/v1alpha1.SingletonServer Y N Y
Worker core.oam.dev/v1alpha1.Worker N Y Y
Singleton
Worker
core.oam.dev/v1alpha1.SingletonWorker N N Y
Task core.oam.dev/v1alpha1.Task N Y N
Singleton Task core.oam.dev/v1alpha1.SingletonTask N N N
  • Server:定義了容器運行時可以運行 0 或多個容器實例,該工作負載提供了冗餘的可擴縮容的多副本常駐服務,在 K8s 平台可以使用 Deployment 或者 Statefulset 加上 Service 來實現;

  • Singleton Server:定義了容器運行時只能運行一個容器實例,該工作負載提供了無法冗餘的單副本常駐服務,在 K8s 平台可以使用副本為 1 的 Statefulset 加上 Service 來實現;

  • Worker:定義了容器運行時可以運行 0 或多個容器實例,該工作負載提供了冗餘的可擴縮容的多副本常駐實例但是不提供服務,在 K8s 平台可以使用 Deployment 或者 Statefulset 來實現;

  • Singleton Worker:定義了容器運行時只能運行一個容器實例,該工作負載提供了無法冗餘的單副本常駐實例但是不提供服務,在 K8s 平台可以使用副本為 1 的 Statefulset 來實現;

  • Task:定義了非常駐可冗餘的容器運行時,運行完就退出,可以賦予擴縮容特性,在 K8s 平台可以使用 Job 來實現;

  • Singleton Task:定義了非常駐非冗餘的容器運行時,運行完就退出,在 K8s 平台可以使用 completions=1 的 Job 來實現。

核心工作負載必須給定 container 部分,實現核心工作負載的 OAM 平台必須不依賴 workloadSettings。

  • 擴展工作負載類型

擴展工作負載類型是平台運行時特定的,由各個 OAM 平台自定提供,當前版本的 Spec 不支持用戶自定義工作負載類型,只能是平台方提供,擴展工作負載可以使用非容器運行時,workloadSettings 的目的就是為了擴展工作負載類型的配置。

工作負載的定義是包羅萬象的,他允許任何部署的服務作為工作負載,無論是容器化還是虛擬機,基於此,我們可以將緩存,數據庫,消息隊列都作為工作負載,如果組件指定的工作負載在平台沒有提供,應該快速失敗將信息返回給用戶。

除了 WorkloadType,可以看到組件 Spec 內嵌了 3 種結構體,下面來看看它們的定義:

1.Parameter

定義了該組件的所有可配置項,其定義如下:

屬性 類型 必填 默認值 描述
name string Y
description string N 組件的簡短描述
type string Y 參數類型,JSON定義的boolean, number, … 
required boolean N false 參數值是否必須提供
default 同上面的type N 參數的默認值

2.Container

屬性 類型 必填 默認值 描述
name string Y 容器名字,在組件內必須唯一
iamge string Y 鏡像地址
resources Resources Y 鏡像運行最小資源需求
env []Env N 環境變量
ports []Port N 暴露端口
livenessProde HealthProbe N 健康狀態檢查指令
readinessProbe HealthProbe N 流量可服務狀態檢查指令
cmd []string N 容器運行入口
args []string N 容器運行參數
config []ConfigFile N 容器內可以訪問的配置文件
imagePullSecrets string N 拉取容器的憑證

其中 Resources 的定義如下:

屬性 類型 必填 默認值 描述
cpu CPU Y 容器運行所需的cpu資源
memory Memory Y 容器運行所需的memory資源
gpu GPU N 容器運行所需的gpu資源
volumes []Volume N 容器運行所需的存儲資源
extended []ExtendedResource N 容器運行所需的外部資源

其中 CPU/Memory/GPU 都是數值型,不贅述,Volume 的定義如下:

屬性 類型 必填 默認值 描述
name string Y 數據卷的名字,引用的時候使用
mountPath string Y 實際在文件系統的掛載路徑
accessMode string N RW 訪問模式,RW或RO
sharingPolicy string N Exclusive 掛載共享策略,Exclusive或者Shared
disk Disk N 該數據卷使用底層磁盤資源的屬性

Disk 指定存儲是否需要持久化,最小的空間需求,定義如下:

屬性 類型 必填 默認值 描述
required string Y 最小磁盤大小需求
ephemeral boolean N 是否需要掛載外部磁盤

ExtendedResource 描述特定實現的資源需求,比如 OAM 運行時平台可能提供特殊的硬件,這個字段允許容器聲明需要這個特定的 offering:

屬性 類型 必填 默認值 描述
required string Y 需要的條件
name string Y 資源名字,比如GV.K

Env,Port,HealthProbe 和 K8s 類似,這裏不再贅述。

3.WorkloadSetting

工作負載的附加配置,用於非容器運行時(當然,也可以用於容器運行時工作負載的附加字段)。

屬性 類型 必填 默認值 描述
name string Y 參數名
type string N string 參數類型,用於實現的hint
value any N 參數值,如果沒有fromParam則用該值
fromParam string N 參數引用,覆蓋value

這組配置會傳給運行時,一個運行時可以返回錯誤,如果特定的限制沒有滿足,比如:

  • 丟失了期望的 k/v 對;
  • 不認識的 k/v 對;

例子

使用核心工作負載 Server 的組件聲明

apiVersion: core.oam.dev/v1alpha1
kind: ComponentSchematic
metadata:
  name: frontend
  annotations:
    version: v1.0.0
    description: >
      Sample component schematic that describes the administrative interface for our Twitter bot.
spec:
  workloadType: core.oam.dev/v1alpha1.Server
  osType: linux
  parameters:
  - name: username
    description: Basic auth username for accessing the administrative interface
    type: string
    required: true
  - name: password
    description: Basic auth password for accessing the administrative interface
    type: string
    required: true
  - name: backend-address
    description: Host name or IP of the backend
    type: string
    required: true
  containers:
  - name: my-twitter-bot-frontend
    image:
      name: example/my-twitter-bot-frontend:1.0.0
      digest: sha256:6c3c624b58dbbcd3c0dd82b4c53f04194d1247c6eebdaab7c610cf7d66709b3b
    resources:
      cpu:
        required: 1.0
      memory:
        required: 100MB
    ports:
    - name: http
      value: 8080
    env:
    - name: USERNAME
      fromParam: 'username'
    - name: PASSWORD
      fromParam: 'password'
    - name: BACKEND_ADDRESS
      fromParam: 'backend-address'
    livenessProbe:
      httpGet:
        port: 8080
        path: /healthz
    readinessProbe:
      httpGet:
        port: 8080
        path: /healthz

使用擴展工作負載的組件聲明

apiVersion: core.oam.dev/v1alpha1
kind: ComponentSchematic
metadata:
  name: alibabacloudFunctions
  annotations:
    version: v1.0.0
    description: "Extended workflow example"
spec:
  workloadType: alibabacloud.com/v1.Function
  parameters:
  - name: github-token
    description: GitHub API session key
    type: string
    required: true
  workloadSettings:
    - name: source
      value: git://git.example.com/function/myfunction.git
    - name: github_token
      fromParam: github-token

總結

組件聲明是由開發者或者 OAM 平台給出,透出應用運行的可配置項、依賴的平台和工作負載,可以看成是一個聲明了運行環境的函數定義,運維人員填寫函數參數之後,組件就會按照聲明的功能運行起來。

應用邊界(Application scopes)

應用邊界通過提供不同形式的應用邊界以及共有的分組行為來將組件組成邏輯的應用,應用邊界具備以下通用的特徵:

  • 應用邊界應該描述該組組件實例的共有行為和元數據;
  • 一個組件可以同時部署到多個不同類型的應用邊界中;
  • 應用邊界類型可以決定組件是否可以部署到多個相同的應用邊界類型實例;
  • 應用邊界可以用於不同組件分組以及不同 infra 能力之間的連接機制,比如 networking 或者外部能力(如驗證服務);

下圖說明了組件可以屬於多個重疊的應用分組,最終創建出不同的應用邊界。

上圖有兩種應用邊界類型:Network 與 Health,有四個組件分佈在不同的應用邊界實例中:

  • A、B、C 三個組件部署到了相同的 Health scope,該 scope 會收集所有屬於這個邊界的組件狀態和信息,可以給 Traits 或者其他組件使用;
  • 組件 A 和 B、C、D 的網絡邊界是隔離的,這允許 infra 運維提供不同的 SDN 設置,控制不同分組的流量流入/流出規則;

類型

主要是有兩種應用邊界類型:

  • 核心應用邊界類型
  • 擴展應用邊界類型

核心應用邊界類型

定義基本運行時行為的分組結構,它們擁有如下特徵:

  • 必須是 core.oam.dev 命名空間;
  • 必須被全部實現;
  • 核心工作負載類型實例必須部署到所有核心應用邊界類型實例中;
  • 運行時必須為每種應用邊界類型提供默認的應用邊界實例;
  • 運行時如果組件實例沒有指定特定的應用邊界,必須將該組件實例部署到默認應用邊界實例上;

當前 Spec 定義的應用邊界類型有:

Name Type Description
Network core.oam.dev/v1alpha1.Network 該邊界將組件組織到一個子網邊界並且定義統一的運行時網絡模型,以及infra網絡描述的定義和規則
Health core.oam.dev/v1alpha1.Health 該邊界將組件組織到一個聚合的健康組中,信息可以用於回滾和升級

擴展應用邊界類型

對於運行時來說是 optional 的,可以自定義。

定義

apiVersion,kind,metadata 和前面組件一致,不贅述,主要描述 Spec:

屬性 類型 必填 默認值 描述
type string Y 應用邊界類型
allowComponentOverlap bool Y 決定是否允許一個組件同時出現在多個該類型應用邊界實例中
parameters []Parameter N 邊界的可配置參數

例子

Network scope(core)

用於將組件劃分到一個網絡或者 SDN 中,網絡本身必須被 infra 定義和運維,也可以被流量管理 Traits 查詢,用於發現 service mesh 的可發現邊界或者 API 網關的 API 邊界:

apiVersion: core.oam.dev/v1alpha1
kind: ApplicationScope
metadata:
  name: network
  annotations:
    version: v1.0.0
    description: "network boundary that a group components reside in"
spec:
  type: core.oam.dev/v1.NetworkScope
  allowComponentOverlap: false
  parameters:
    - name: network-id
      description: The id of the network, e.g. vpc-id, VNet name.
      type: string
      required: Y
    - name: subnet-id
      description: The id of the subnet within the network.
      type: string
      required: Y
    - name: internet-gateway-type
      description: The type of the gateway, options are 'public', 'nat'. Empty string means no gateway.
      type: string
      required: N

Health scope(core)

用於聚合組件的健康狀態,可以設計的參數有健康閾值(超過該閾值的組件不健康則認為整個邊界不健康),健康邊界實例本身不會用健康狀態做任何操作,它只是分組健康聚合器,其信息可以被查詢並用於其他地方,比如:

  • 應用的變更 Traits 可以監控健康狀態來決定何時回滾;
  • 監控 Traits 可以監控健康狀態來觸發報警。
apiVersion: core.oam.dev/v1alpha1
kind: ApplicationScope
metadata:
  name: health
  annotations:
    version: v1.0.0
    description: "aggregated health state for a group of components."
spec:
  type: core.oam.dev/v1alpha1.HealthScope
  allowComponentOverlap: true
  parameters:
    - name: probe-method
      description: The method to probe the components, e.g. 'httpGet'.
      type: string
      required: true
    - name: probe-endpoint
      description: The endpoint to probe from the components, e.g. '/v1/health'.
      type: string
      required: true
    - name: probe-timeout
      description: The amount of time in seconds to wait when receiving a response before marked failure.
      type: integer
      required: false
    - name: probe-interval
      description: The amount of time in seconds between probing tries.
      type: integer
      required: false
    - name: failure-rate-threshold
      description: If the rate of failure of total probe results is above this threshold, declared 'failed'.
      type: double
      required: false
    - name: healthy-rate-threshold
      description: If the rate of healthy of total probe results is above this threshold, declared 'healthy'.
      type: double
      required: false
    - name: health-threshold-percentage
      description: The % of healthy components required to upgrade scope
      type: double
      required: false
    - name: required-healthy-components
      description: Comma-separated list of names of the components required to be healthy for the scope to be health.
      type: []string
      required: false

resource quota scope(extended)

限制分組內所有組件的資源使用總量上限。

apiVersion: core.oam.dev/v1alpha1
kind: ApplicationScope
metadata:
  name: myResourceQuotas
  annotations:
    version: v1.0.0
    description: "The production configuration for Corp CMS"
spec:
  type: resources.oam.dev/v1.ResourceQuotaScope
  allowComponentOverlap: false
  parameters:
    - name: CPU
      description: maximum CPU to be consumed by this scope
      type: double
      required: Y
    - name: Memory
      description: maximum memory to be consumed by this scope
      type: double
      required: Y

總結

應用邊界聲明由 OAM 平台提供,透出應用邊界實例運行的可配置項,可以看成是一個函數定義,運維人員或者平台填寫函數參數之後,應用邊界就會按照聲明的功能運行起來,對該邊界內的組件們起作用。

應用特徵(Traits)

OAM Spec 的實現平台應該提供 Traits 給組件工作負載增強運維操作,一個 Trait 是一種自由的運行時,增強工作負載提供額外的功能,比如流量路由規則、自動擴縮容規則、升級策略等,這讓應用運維具備根據需求配置組件,不需要開發者參与的能力。一個獨立的 Trait 可以綁定 1 或多個工作負載類型,它可以聲明哪些工作負載類型才能使用該Trait。

規則

  • 目前並沒有機制來显示約定組件的多個 Traits 組合,也就是一個組件應用了 Trait A 無法要求 Trait B 必須應用於該組件,如果在運行時發生存在 Trait A 但是 Trait B 不存在,應該標記 Trait A 失敗;
  • Traits 應該按照定義的順序施加到組件上;
  • 應用部署只有當所有組件和其 Traits 都正常運行起來才能標記為部署成功;
  • OAM 平台應該支持組件施加多個 Traits,這些 Traits 可能是相同的類型;
  • OAM 對 Trait 的實現沒有任何限制,Trait 一般作用於應用的安裝和升級時;

分類

目前 Traits 主要分為三類:

  • Core Traits: core Traits 屬於 core.oam.dev 分組,是一些必要的運維特徵,所有 OAM 平台必須實現;
  • Standard Traits: standard Traits 屬於 standard.oam.dev 分組裡面,是一些常用的運維特徵,推薦 OAM 平台實現;
  • Extensions Traits: extension Traits 是自定義 Traits,其分組也是自定義,是平台特定的運維特徵(通常是特定 OAM 平台差異性)的體現。

定義

apiVersion,kind,metadata 和前面組件一致,不贅述,主要描述 Spec:

屬性 類型 必填 默認值 描述
appliesTo []string N [“*”] 該Trait可以應用的工作負載類型
properties []Properties N Trait的可配置參數,使用JSON Schema來表達。

例子

Manual Scaler(core)

apiVersion: core.oam.dev/v1alpha1
kind: Trait
metadata:
  name: ManualScaler
  annotations:
    version: v1.0.0
    description: "Allow operators to manually scale a workloads that allow multiple replicas."
spec:
  appliesTo:
    - core.oam.dev/v1alpha1.Server
    - core.oam.dev/v1alpha1.Worker
    - core.oam.dev/v1alpha1.Task
  properties: |
    {
      "$schema": "http://json-schema.org/draft-07/schema#",
      "type": "object",
      "required": ["replicaCount],
      "properties": {
        "replicaCount": {
          "type": "integer",
          "description": "the target number of replicas to scale a component to.",
          "minimum": 0
        }
      }
    }

上面是一個手動擴縮容服務的 Trait,只有一個參數就是 replicaCount。

總結

應用特徵聲明由 OAM 平台提供,透出應用特徵的可配置項,標明了可作用於的工作負載,可以看成函數定義,運維人員或者平台填寫實參之後,應用特徵就會按照聲明的功能運行起來,對綁定的組件起作用。

應用配置(Application Configuration)

應用配置主要是描述應用如何被部署的,一個組件可以部署到任意的運行時,我們稱一個組件的一次部署為實例,每次組件部署的時候必須有應用配置。

應用配置由應用運維管理,提供當前組件實例的信息:

  • 特定組件的基本信息:名字、版本、描述;
  • 組件及其相關組件定義 parameters 的賦值;
  • 組件要施加的 Trait 以及 Trait 的配置。

概念

實例與升級(Instances and upgrades)

一個實例是組件的可追溯部署,當組件部署時創建,後續該組件的升級都是修改該實例,回滾/重新部署都屬於升級,實例都會有名字方便引用。當一個實例首次創建時,處於初始發行 (release) 狀態,每次升級操作之後,一個新的發行就會創建。 

發行(Releases)

任何對組件本身或者其配置的變更都會創建一個新的發行,一個發行就是應用配置以及它對組件、應用特徵、應用邊界的定義,當一個發行被部署,對應的組件、應用特徵和應用邊界也會被部署。

基於該定義,平台需要保證以下變更語義:

  • 如果新的發行包含了舊發行不存在的組件,平台需要創建該組件;
  • 如果新的發行不包含舊發行存在的組件,平台需要刪除該組件;
  • 應用特徵和應用邊界與組件的變更語義一致。

運行時與應用配置(Runtime and Application Configuration)

一個組件可以部署到多個不同的運行時,在每個運行時中應用配置的實例與應用配置之間是 1:1 的關係,應用配置由應用運維管理,包含 3 個主要部分:

  • 參數:運維人員在部署時可以定義的參數;
  • 應用邊界列表:一組應用邊界列表,每個應用邊界定義對應的參數;
  • 組件實例定義:定義一個組件實例如何部署,這個定義本身有 3 個部分:

    • 組件參數的定義;
    • Traits 列表:每個 Trait 定義對應的參數;
    • 應用邊界列表:該組件應該部署到的應用邊界列表。

定義

apiVersion,kind,metadata 和前面組件一致,不贅述,主要描述 Spec:

屬性 類型 必填 默認值 描述
variables []Variable N 可以在參數值和屬性中引用的變量
scopes []Scope N 應用邊界定義
components []Component N 組件實例定義

variables 就是一個 k/v 對,一個集中的地方定義運維的變量,在運維配置的其他地方都可以用 fromVariable(VARNAME) 引用:

屬性 類型 必填 默認值 描述
name string Y 變量名字
value string Y 標量值

scopes 定義該運維配置將要創建的應用邊界,其定義為:

屬性 類型 必填 默認值 描述
name string Y 應用邊界名字
type string Y 應用邊界的GROUP/VERSION.KIND
properties Properties N 覆蓋邊界的參數

components 是組件實例定義,而不是組件定義:

屬性 類型 必填 默認值 描述
componentName string Y 組件名
instanceName string Y 組件實例名
parameterValues []ParameterValue N 覆蓋組件的參數
Traits []Trait N 指定組件實例綁定的Traits
applicationScopes []string N 指定組件運行的應用邊界

Trait 在這裏的定義是:

屬性 類型 必填 默認值 描述
name string Y Trait實例名
properties Properties N 覆蓋Trait的參數

例子

apiVersion: core.oam.dev/v1alpha1
kind: ApplicationConfiguration
metadata:
  name: my-app-deployment
  annotations:
    version: v1.0.0
    description: "Description of this deployment"
spec:
  variables:
    - name: VAR_NAME
      value: SUPPLIED_VALUE
  scopes:
    - name: core.oam.dev/v1alpha1.Network
      parameterValues:
        - name: PARAM_NAME
          value: SUPPLIED_VALUE
  components:
    - componentName: my-web-app-component
      instanceName: my-app-frontent
      parameterValues:
        - name: PARAMETER_NAME
          value: SUPPLIED_VALUE
        - name: ANOTHER_PARAMETER
          value: "[fromVariable(VAR_NAME)]"
      traits:
        - name: Ingress
          properties:
            CUSTOM_OBJECT:
              DATA: "[fromVariable(VAR_NAME)]"

總結

應用配置定義由運維人員或者 OAM 平台提供,描述應用的部署,可以看成是一個函數調用,運維人員或者 OAM 平台填寫實參之後,調用之前定義的組件、應用特徵、應用邊界等函數,這些實例一起作用對外提供應用服務。

工作負載類型(Workload Types)

Workload 類型和 Trait 一樣由平台提供,所以用戶可以查看平台提供哪些工作負載,對於平台用戶來說工作負載類型無法擴展,只能由平台開發者擴展提供,因此平台一定不允許用戶創建自定義的工作負載類型。

定義

apiVersion,kind,metadata 和前面組件類似,不贅述,這裏主要描述 Spec,定義組件如何使用工作負載類型,除此之外暴露了底層工作負載運行時的可配置參數:

屬性 類型 必填 默認值 描述
group string Y 該工作負載類型所屬的group
names Names Y 該工作負載類型的關聯名字信息
settings []Setting N 該工作負載的設置選項

Names 就是描述了對應類型的不同形式名字引用:

屬性 類型 必填 默認值 描述
kind string Y 工作負載類型的正確引用名字,比如Singleton
singular string N 單數形式的可讀名字,比如singleton
plural string N 複數形式的可讀名字,比如singletons

Setting 描述工作負載可配置部分,類似前面組件的 Parameters,都是 schema:

屬性 類型 必填 默認值 描述
name string Y 配置名,每個workload類型必須唯一
description string N 配置說明
type string Y 配置類型
required bool N false 是否必須提供
default indicated by type N 默認值

價值

通過上面的介紹,我們了解了 OAM Spec 裏面的基本概念和定義,以及如何使用它們來描述應用交付和運維流程。然而,OAM 能給我們帶來什麼樣的價值呢?我們評判一個好的架構體系,不僅是因為它在技術上更先進,更主要的是它能夠解決一些實際問題,為用戶帶來價值。所以,接下來我們將總結一下這方面的內容。

OAM 的價值要從下往上三個層面來說起。

1. 從基礎設施層面

基礎設施,指的是像 K8s 這類的提供基礎服務能力與抽象的一層服務體系。拿 K8s 來說,它提供了許多種類的基礎服務和強大的擴展能力來靈活擴展其他基礎服務。

但是,使用基礎設施的運維人員很快就發現 K8s 存在一個問題:缺乏統一的機制來註冊和管理自定義擴展能力。這些擴展能力的表達方式不夠統一,有些是 CRD、有些是 annotation、有些是 Config…

這種亂象使得基礎設施用戶不知道平台上都提供了哪些能力,不知道怎麼使用這些能力,更不知道這些能力互相之間的兼容組合關係。

OAM 提供了抽象(如 Workload/Trait 等)來統一定義和管理這些能力。有了 OAM,各平台實現就有了統一的標準規範去透出公共的或差異化的能力:公共的基礎服務像容器部署、監控、日誌、灰度發布;差異化的、高級複雜的能力像 CronHPA(周期性定時變化的強化版 HPA)。

2. 從應用運維者層面

應用運維,指的是像給應用加上網絡接入、複雜均衡、彈性伸縮、甚至是建站等運維操作。但是,運維的一個痛點就是原來這些能力並不是跨平台的:這導致在不同平台、不同環境下去部署和運維應用的操作,是不互通和不兼容的。

上面這個問題,是客戶應用、尤其是傳統 ERP 應用上雲的一大阻礙。我們做 OAM 的一個初衷,就是通過一套標準定義,讓不同的平台實現也通過統一的方式透出。我們希望:哪怕一個應用不是生在雲上、長在雲上,也能夠趕上這趟通往雲原生未來的列車,擁抱雲帶來的變化和紅利!

OAM 提供的抽象和模型,是我們通往統一、標準的應用架構的強有力工具。這些標準能力以後都會通過 OAM 輸出,讓運維人員輕易去實現跨平台部署。

3. 從應用開發者層面

應用開發,指的就是業務邏輯開發,這是業務產生價值的核心位置。

也正因如此,我們希望,應用開發者能夠專註於業務開發,而不需要關心運維細節。但是,K8s 提供的 API,並沒有很好地分離開發和運維的關注點,開發和運維之間需要來回溝通以避免產生誤解和衝突。

OAM 分離了開發和運維的關注點,很好地解決了以上問題,讓整個發布流程更加連貫、高效。

下一步

目前,OAM 已經在阿里雲 EDAS 等多個項目中進行了數月的內部落地嘗試。我們希望通過一套統一、標準的應用定義體系,承載雲應用管理項目產品與外部資源關係的高效管理體驗,並將這種體驗統一帶給了基於 Function、ECS、Kubernetes 等不同運行時的應用管理流程;通過應用特徵系統,將多個阿里雲獨有的能力進行了模塊化,大大提高了阿里雲基礎設施能力的交付效率。

經過了前一段努力的鋪墊,我們也慢慢明確了接下來的工作方向:

  • 將接入更多的雲產品服務,為用戶將跨平台應用交付的能力最大化;
  • 提供 OAM framework 等工具和框架,幫助新的 OAM 平台開發者去快速、簡單地搭建 OAM 服務,接入 OAM 標準;
  • 推動開源生態建設,以標準化的方式幫助“應用”高效和高質量地交付到任何平台上去。

社區共建

為了能夠讓社區更加高效、健康的運轉下去,我們非常期待得到您的反饋,並與大家密切協作,針對 Kubernetes 和任意雲環境打造一個簡單、可移植、可復用的應用模型。參与方式:

  • 通過 Gitter 直接參与討論:;
  • 選擇釘釘掃碼進入 OAM 項目中文討論群。

(****釘釘掃碼加入交流群****)

歡迎你與我們一起共建這個全新的應用管理生態!

“ 阿里巴巴雲原生微信公眾號(ID:Alicloudnative)關注微服務、Serverless、容器、Service Mesh等技術領域、聚焦雲原生流行技術趨勢、雲原生大規模的落地實踐,做最懂雲原生開發者的技術公眾號。”

更多相關信息,請關注。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選
程序員需要了解的硬核知識之彙編語言(一)

之前的系列文章從 CPU 和內存方面簡單介紹了一下彙編語言,但是還沒有系統的了解一下彙編語言,彙編語言作為第二代計算機語言,會用一些容易理解和記憶的字母,單詞來代替一個特定的指令,作為高級編程語言的基礎,有必要系統的了解一下彙編語言,那麼本篇文章希望大家跟我一起來了解一下彙編語言。

彙編語言和本地代碼

我們在之前的文章中探討過,計算機 CPU 只能運行本地代碼(機器語言)程序,用 C 語言等高級語言編寫的代碼,需要經過編譯器編譯后,轉換為本地代碼才能夠被 CPU 解釋執行。

但是本地代碼的可讀性非常差,所以需要使用一種能夠直接讀懂的語言來替換本地代碼,那就是在各本地代碼中,附帶上表示其功能的英文縮寫,比如在加法運算的本地代碼加上add(addition) 的縮寫、在比較運算符的本地代碼中加上cmp(compare)的縮寫等,這些通過縮寫來表示具體本地代碼指令的標誌稱為 助記符,使用助記符的語言稱為彙編語言。這樣,通過閱讀彙編語言,也能夠了解本地代碼的含義了。

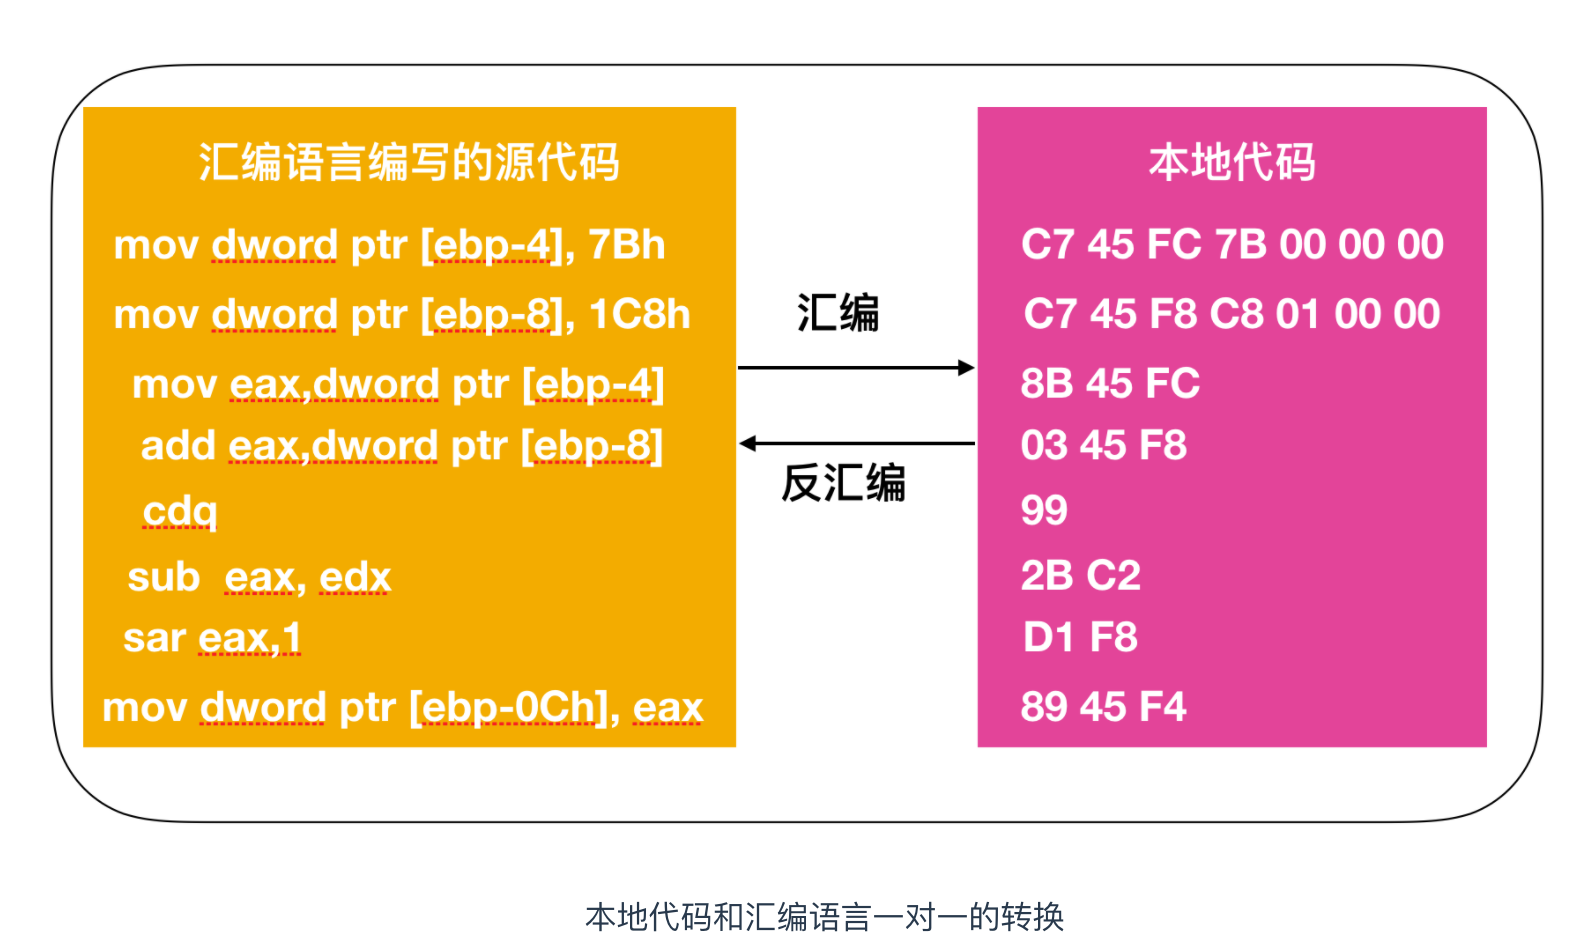
不過,即使是使用彙編語言編寫的源代碼,最終也必須要轉換為本地代碼才能夠運行,負責做這項工作的程序稱為編譯器,轉換的這個過程稱為彙編。在將源代碼轉換為本地代碼這個功能方面,彙編器和編譯器是同樣的。

用彙編語言編寫的源代碼和本地代碼是一一對應的。因而,本地代碼也可以反過來轉換成彙編語言編寫的代碼。把本地代碼轉換為彙編代碼的這一過程稱為反彙編,執行反彙編的程序稱為反彙編程序。

哪怕是 C 語言編寫的源代碼,編譯后也會轉換成特定 CPU 用的本地代碼。而將其反彙編的話,就可以得到彙編語言的源代碼,並對其內容進行調查。不過,本地代碼變成 C 語言源代碼的反編譯,要比本地代碼轉換成彙編代碼的反彙編要困難,這是因為,C 語言代碼和本地代碼不是一一對應的關係。

通過編譯器輸出彙編語言的源代碼

我們上面提到本地代碼可以經過反彙編轉換成為彙編代碼,但是只有這一種轉換方式嗎?顯然不是,C 語言編寫的源代碼也能夠通過編譯器編譯稱為彙編代碼,下面就來嘗試一下。

首先需要先做一些準備,需要先下載 Borland C++ 5.5 編譯器,為了方便,我這邊直接下載好了讀者直接從我的百度網盤提取即可 (鏈接:https://pan.baidu.com/s/19LqVICpn5GcV88thD2AnlA 密碼:hz1u)

下載完畢,需要進行配置,下面是配置說明 (https://wenku.baidu.com/view/22e2f418650e52ea551898ad.html),教程很完整跟着配置就可以,下面開始我們的編譯過程

首先用 Windows 記事本等文本編輯器編寫如下代碼

// 返回兩個參數值之和的函數
int AddNum(int a,int b){
  return a + b;
}

// 調用 AddNum 函數的函數
void MyFunc(){
  int c;
  c = AddNum(123,456);
}

編寫完成后將其文件名保存為 Sample4.c ,C 語言源文件的擴展名,通常用.c 來表示,上面程序是提供兩個輸入參數並返回它們之和。

在 Windows 操作系統下打開 命令提示符,切換到保存 Sample4.c 的文件夾下,然後在命令提示符中輸入

bcc32 -c -S Sample4.c

bcc32 是啟動 Borland C++ 的命令,-c 的選項是指僅進行編譯而不進行鏈接,-S 選項被用來指定生成彙編語言的源代碼

作為編譯的結果,當前目錄下會生成一個名為Sample4.asm 的彙編語言源代碼。彙編語言源文件的擴展名,通常用.asm 來表示,下面就讓我們用編輯器打開看一下 Sample4.asm 中的內容

    .386p
    ifdef ??version
    if    ??version GT 500H
    .mmx
    endif
    endif
    model flat
    ifndef  ??version
    ?debug  macro
    endm
    endif
    ?debug  S "Sample4.c"
    ?debug  T "Sample4.c"
_TEXT   segment dword public use32 'CODE'
_TEXT   ends
_DATA   segment dword public use32 'DATA'
_DATA   ends
_BSS    segment dword public use32 'BSS'
_BSS    ends
DGROUP  group   _BSS,_DATA
_TEXT   segment dword public use32 'CODE'
_AddNum proc    near
?live1@0:
   ;    
   ;    int AddNum(int a,int b){
   ;    
    push      ebp
    mov       ebp,esp
   ;    
   ;    
   ;        return a + b;
   ;    
@1:
    mov       eax,dword ptr [ebp+8]
    add       eax,dword ptr [ebp+12]
   ;    
   ;    }
   ;    
@3:
@2:
    pop       ebp
    ret 
_AddNum endp
_MyFunc proc    near
?live1@48:
   ;    
   ;    void MyFunc(){
   ;    
    push      ebp
    mov       ebp,esp
   ;    
   ;        int c;
   ;        c = AddNum(123,456);
   ;    
@4:
    push      456
    push      123
    call      _AddNum
    add       esp,8
   ;    
   ;    }
   ;    
@5:
    pop       ebp
    ret 
_MyFunc endp
_TEXT   ends
    public  _AddNum
    public  _MyFunc
    ?debug  D "Sample4.c" 20343 45835
    end

這樣,編譯器就成功的把 C 語言轉換成為了彙編代碼了。

不會轉換成本地代碼的偽指令

第一次看到彙編代碼的讀者可能感覺起來比較難,不過實際上其實比較簡單,而且可能比 C 語言還要簡單,為了便於閱讀彙編代碼的源代碼,需要注意幾個要點

彙編語言的源代碼,是由轉換成本地代碼的指令(後面講述的操作碼)和針對彙編器的偽指令構成的。偽指令負責把程序的構造以及彙編的方法指示給彙編器(轉換程序)。不過偽指令是無法彙編轉換成為本地代碼的。下面是上面程序截取的偽指令

_TEXT   segment dword public use32 'CODE'
_TEXT   ends
_DATA   segment dword public use32 'DATA'
_DATA   ends
_BSS    segment dword public use32 'BSS'
_BSS    ends
DGROUP  group   _BSS,_DATA

_AddNum proc    near
_AddNum endp

_MyFunc proc    near
_MyFunc endp

_TEXT   ends
    end

由偽指令 segment 和 ends 圍起來的部分,是給構成程序的命令和數據的集合體上加一個名字而得到的,稱為段定義。段定義的英文表達具有區域的意思,在這個程序中,段定義指的是命令和數據等程序的集合體的意思,一個程序由多個段定義構成。

上面代碼的開始位置,定義了3個名稱分別為 _TEXT、_DATA、_BSS 的段定義,_TEXT 是指定的段定義,_DATA 是被初始化(有初始值)的數據的段定義,_BSS 是尚未初始化的數據的段定義。這種定義的名稱是由 Borland C++ 定義的,是由 Borland C++ 編譯器自動分配的,所以程序段定義的順序就成為了 _TEXT、_DATA、_BSS ,這樣也確保了內存的連續性

_TEXT   segment dword public use32 'CODE'
_TEXT   ends
_DATA   segment dword public use32 'DATA'
_DATA   ends
_BSS    segment dword public use32 'BSS'
_BSS    ends

段定義( segment ) 是用來區分或者劃分範圍區域的意思。彙編語言的 segment 偽指令表示段定義的起始,ends 偽指令表示段定義的結束。段定義是一段連續的內存空間

而group 這個偽指令表示的是將 _BSS和_DATA 這兩個段定義匯總名為 DGROUP 的組

DGROUP  group   _BSS,_DATA

圍起 _AddNum 和 _MyFun 的 _TEXT segment 和 _TEXT ends ,表示_AddNum 和 _MyFun 是屬於 _TEXT 這一段定義的。

_TEXT   segment dword public use32 'CODE'
_TEXT   ends

因此,即使在源代碼中指令和數據是混雜編寫的,經過編譯和彙編后,也會轉換成為規整的本地代碼。

_AddNum proc 和 _AddNum endp 圍起來的部分,以及_MyFunc proc 和 _MyFunc endp 圍起來的部分,分別表示 AddNum 函數和 MyFunc 函數的範圍。

_AddNum proc    near
_AddNum endp

_MyFunc proc    near
_MyFunc endp

編譯后在函數名前附帶上下劃線_ ,是 Borland C++ 的規定。在 C 語言中編寫的 AddNum 函數,在內部是以 _AddNum 這個名稱處理的。偽指令 proc 和 endp 圍起來的部分,表示的是 過程(procedure) 的範圍。在彙編語言中,這種相當於 C 語言的函數的形式稱為過程。

末尾的 end 偽指令,表示的是源代碼的結束。

## 彙編語言的語法是 操作碼 + 操作數

在彙編語言中,一行表示一對 CPU 的一個指令。彙編語言指令的語法結構是 操作碼 + 操作數,也存在只有操作碼沒有操作數的指令。

操作碼錶示的是指令動作,操作數表示的是指令對象。操作碼和操作數一起使用就是一個英文指令。比如從英語語法來分析的話,操作碼是動詞,操作數是賓語。比如這個句子 Give me money這個英文指令的話,Give 就是操作碼,me 和 money 就是操作數。彙編語言中存在多個操作數的情況,要用逗號把它們分割,就像是 Give me,money 這樣。

能夠使用何種形式的操作碼,是由 CPU 的種類決定的,下面對操作碼的功能進行了整理。

本地代碼需要加載到內存后才能運行,內存中存儲着構成本地代碼的指令和數據。程序運行時,CPU會從內存中把數據和指令讀出來,然後放在 CPU 內部的寄存器中進行處理。

如果 CPU 和內存的關係你還不是很了解的話,請閱讀作者的另一篇文章 詳細了解。

寄存器是 CPU 中的存儲區域,寄存器除了具有臨時存儲和計算的功能之外,還具有運算功能,x86 系列的主要種類和角色如下圖所示

指令解析

下面就對 CPU 中的指令進行分析

最常用的 mov 指令

指令中最常使用的是對寄存器和內存進行數據存儲的 mov 指令,mov 指令的兩個操作數,分別用來指定數據的存儲地和讀出源。操作數中可以指定寄存器、常數、標籤(附加在地址前),以及用方括號([]) 圍起來的這些內容。如果指定了沒有用([]) 方括號圍起來的內容,就表示對該值進行處理;如果指定了用方括號圍起來的內容,方括號的值則會被解釋為內存地址,然後就會對該內存地址對應的值進行讀寫操作。讓我們對上面的代碼片段進行說明

    mov       ebp,esp
    mov       eax,dword ptr [ebp+8]

mov ebp,esp 中,esp 寄存器中的值被直接存儲在了 ebp 中,也就是說,如果 esp 寄存器的值是100的話那麼 ebp 寄存器的值也是 100。

而在 mov eax,dword ptr [ebp+8] 這條指令中,ebp 寄存器的值 + 8 後會被解析稱為內存地址。如果 ebp

寄存器的值是100的話,那麼 eax 寄存器的值就是 100 + 8 的地址的值。dword ptr 也叫做 double word pointer 簡單解釋一下就是從指定的內存地址中讀出4字節的數據

對棧進行 push 和 pop

程序運行時,會在內存上申請分配一個稱為棧的數據空間。棧(stack)的特性是后入先出,數據在存儲時是從內存的下層(大的地址編號)逐漸往上層(小的地址編號)累積,讀出時則是按照從上往下進行讀取的。

棧是存儲臨時數據的區域,它的特點是通過 push 指令和 pop 指令進行數據的存儲和讀出。向棧中存儲數據稱為 入棧 ,從棧中讀出數據稱為 出棧,32位 x86 系列的 CPU 中,進行1次 push 或者 pop,即可處理 32 位(4字節)的數據。

函數的調用機制

下面我們一起來分析一下函數的調用機制,我們以上面的 C 語言編寫的代碼為例。首先,讓我們從MyFunc 函數調用AddNum 函數的彙編語言部分開始,來對函數的調用機制進行說明。棧在函數的調用中發揮了巨大的作用,下面是經過處理后的 MyFunc 函數的彙編處理內容

_MyFunc      proc    near
    push            ebp       ; 將 ebp 寄存器的值存入棧中              (1) 
    mov             ebp,esp ; 將 esp 寄存器的值存入 ebp 寄存器中        (2)
    push            456         ; 將 456 入棧                                                (3)
    push            123         ; 將 123 入棧                                                (4)
    call            _AddNum ; 調用 AddNum 函數                                       (5)
    add             esp,8       ; esp 寄存器的值 + 8                                     (6)
    pop             ebp         ; 讀出棧中的數值存入 esp 寄存器中                 (7)
    ret                             ; 結束 MyFunc 函數,返回到調用源                   (8)
_MyFunc         endp

代碼解釋中的(1)、(2)、(7)、(8)的處理適用於 C 語言中的所有函數,我們會在後面展示 AddNum 函數處理內容時進行說明。這裏希望大家先關注(3) – (6) 這一部分,這對了解函數調用機制至關重要。

(3) 和 (4) 表示的是將傳遞給 AddNum 函數的參數通過 push 入棧。在 C 語言源代碼中,雖然記述為函數 AddNum(123,456),但入棧時則會先按照 456,123 這樣的順序。也就是位於後面的數值先入棧。這是 C 語言的規定。(5) 表示的 call 指令,會把程序流程跳轉到 AddNum 函數指令的地址處。在彙編語言中,函數名表示的就是函數所在的內存地址。AddNum 函數處理完畢后,程序流程必須要返回到編號(6) 這一行。call 指令運行后,call 指令的下一行(也就指的是 (6) 這一行)的內存地址(調用函數完畢后要返回的內存地址)會自動的 push 入棧。該值會在 AddNum 函數處理的最後通過 ret 指令 pop 出棧,然後程序會返回到 (6) 這一行。

(6) 部分會把棧中存儲的兩個參數 (456 和 123) 進行銷毀處理。雖然通過兩次的 pop 指令也可以實現,不過採用 esp 寄存器 + 8 的方式會更有效率(處理 1 次即可)。對棧進行數值的輸入和輸出時,數值的單位是4字節。因此,通過在負責棧地址管理的 esp 寄存器中加上4的2倍8,就可以達到和運行兩次 pop 命令同樣的效果。雖然內存中的數據實際上還殘留着,但只要把 esp 寄存器的值更新為數據存儲地址前面的數據位置,該數據也就相當於銷毀了。

我在編譯 Sample4.c 文件時,出現了下圖的這條消息

圖中的意思是指 c 的值在 MyFunc 定義了但是一直未被使用,這其實是一項編譯器優化的功能,由於存儲着 AddNum 函數返回值的變量 c 在後面沒有被用到,因此編譯器就認為 該變量沒有意義,進而也就沒有生成與之對應的彙編語言代碼。

下圖是調用 AddNum 這一函數前後棧內存的變化

函數的內部處理

上面我們用彙編代碼分析了一下 Sample4.c 整個過程的代碼,現在我們着重分析一下 AddNum 函數的源代碼部分,分析一下參數的接收、返回值和返回等機制

_AddNum         proc        near
    push            ebp                        -----------(1)
    mov             ebp,esp                -----------(2)
    mov             eax,dword ptr[ebp+8]   -----------(3)
    add             eax,dword ptr[ebp+12]  -----------(4)
    pop             ebp                                      -----------(5)
    ret             ----------------------------------(6)
_AddNum         endp

ebp 寄存器的值在(1)中入棧,在(5)中出棧,這主要是為了把函數中用到的 ebp 寄存器的內容,恢復到函數調用前的狀態。

(2) 中把負責管理棧地址的 esp 寄存器的值賦值到了 ebp 寄存器中。這是因為,在 mov 指令中方括號內的參數,是不允許指定 esp 寄存器的。因此,這裏就採用了不直接通過 esp,而是用 ebp 寄存器來讀寫棧內容的方法。

(3) 使用[ebp + 8] 指定棧中存儲的第1個參數123,並將其讀出到 eax 寄存器中。像這樣,不使用 pop 指令,也可以參照棧的內容。而之所以從多個寄存器中選擇了 eax 寄存器,是因為 eax 是負責運算的累加寄存器。

通過(4) 的 add 指令,把當前 eax 寄存器的值同第2個參數相加后的結果存儲在 eax 寄存器中。[ebp + 12] 是用來指定第2個參數456的。在 C 語言中,函數的返回值必須通過 eax 寄存器返回,這也是規定。也就是 函數的參數是通過棧來傳遞,返回值是通過寄存器返回的。

(6) 中 ret 指令運行后,函數返回目的地內存地址會自動出棧,據此,程序流程就會跳轉返回到(6) (Call _AddNum) 的下一行。這時,AddNum 函數入口和出口處棧的狀態變化,就如下圖所示

這是程序員需要了解的硬核知識之彙編語言(一) 第一篇文章,下一篇文章我們會着重討論局部變量和全局變量以及循環控制語句的彙編語言,防止斷更,請關注我

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選
Spring Cloud Alibaba(四)實現Dubbo服務消費

本項目演示如何使用 Spring Cloud Alibaba 完成 Dubbo 的RPC調用。

Spring Cloud與Dubbo

  • Spring Cloud是一套完整的微服務架構方案

  • Dubbo是國內目前非常流行的服務治理與RPC實現方案

由於Dubbo在國內有着非常大的用戶群體,但是其周邊設施與組件相對來說並不那麼完善(比如feign,ribbon等等)。很多開發者使用Dubbo,又希望享受Spring Cloud的生態,因此也會有一些Spring Cloud與Dubbo一起使用的案例與方法出現。

Spring Cloud Alibaba的出現,實現了Spring Cloud與Dubbo的完美融合。在之前的教程中,我們已經介紹過使用Spring Cloud Alibaba中的Nacos來作為服務註冊中心,並且在此之下可以如傳統的Spring Cloud應用一樣地使用Ribbon或Feign來實現服務消費。這篇,我們就來繼續說說Spring Cloud Alibaba 下額外支持的RPC方案:Dubbo

代碼實現

我們通過一個簡單的例子,使用Nacos做服務註冊中心,利用Dubbo來實現服務提供方與服務消費方。這裏省略Nacos的安裝與使用,下面就直接進入Dubbo的使用步驟。

定義 Dubbo 服務接口

創建 ali-nacos-dubbo-api 工程

Dubbo 服務接口是服務提供方與消費方的遠程通訊契約,通常由普通的 Java 接口(interface)來聲明,如 HelloService 接口:

public interface HelloService {
    String hello(String name);
}

為了確保契約的一致性,推薦的做法是將 Dubbo 服務接口打包在jar包中,如以上接口就存放在 ali-nacos-dubbo-api 之中。 對於服務提供方而言,不僅通過依賴 artifact 的形式引入 Dubbo 服務接口,而且需要將其實現。對應的服務消費端,同樣地需要依賴該 artifact, 並以接口調用的方式執行遠程方法。接下來進一步討論怎樣實現 Dubbo 服務提供方和消費方。

實現 Dubbo 服務提供方

創建 ali-nacos-dubbo-provider,端口:9001 工程

pom.xml配置

<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
    <parent>
        <artifactId>cloud-alibaba</artifactId>
        <groupId>com.easy</groupId>
        <version>1.0.0</version>
    </parent>

    <modelVersion>4.0.0</modelVersion>

    <artifactId>ali-nacos-dubbo-provider</artifactId>

    <dependencies>

        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>

        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-actuator</artifactId>
        </dependency>

        <!-- API -->
        <dependency>
            <groupId>com.easy</groupId>
            <artifactId>ali-nacos-dubbo-api</artifactId>
            <version>${project.version}</version>
        </dependency>

        <!--dubbo-->
        <dependency>
            <groupId>com.alibaba.cloud</groupId>
            <artifactId>spring-cloud-starter-dubbo</artifactId>
        </dependency>

        <!--nacos-->
        <dependency>
            <groupId>com.alibaba.cloud</groupId>
            <artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId>
        </dependency>
    </dependencies>

    <build>
        <plugins>
            <plugin>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-maven-plugin</artifactId>
            </plugin>
        </plugins>
    </build>

</project>

bootstrap.yaml配置

dubbo:
  scan:
    # dubbo 服務掃描基準包
    base-packages: com.easy.andProvider.service

  #Dubbo 服務暴露的協議配置,其中子屬性 name 為協議名稱,port 為協議端口( -1 表示自增端口,從 20880 開始)
  protocol:
    name: dubbo
    port: -1

  #Dubbo 服務註冊中心配置,其中子屬性 address 的值 “spring-cloud://localhost”,說明掛載到 Spring Cloud 註冊中心
  registry:
    address: spring-cloud://localhost

spring:
  application:
    # Dubbo 應用名稱
    name: ali-nacos-dubbo-provider
  main:
    allow-bean-definition-overriding: true
  cloud:
    # Nacos 服務發現與註冊配置
    nacos:
      discovery:
        server-addr: 127.0.0.1:8848

Dubbo Spring Cloud 繼承了 Dubbo Spring Boot 的外部化配置特性,也可以通過標註 @DubboComponentScan 來實現基準包掃描。

實現 Dubbo 服務

HelloService 作為暴露的 Dubbo 服務接口,服務提供方 ali-nacos-dubbo-provider 需要將其實現:

package com.easy.andProvider.service;

import com.easy.and.api.service.HelloService;
import org.apache.dubbo.config.annotation.Service;

@Service
public class HelloServiceImpl implements HelloService {
    @Override
    public String hello(String name) {
        return "你好 " + name;
    }
}

import org.apache.dubbo.config.annotation.Service 是 Dubbo 服務註解,僅聲明該 Java 服務實現為 Dubbo 服務

貼上啟動類代碼:

@EnableDiscoveryClient
@EnableAutoConfiguration
public class AndProviderApplication {
    public static void main(String[] args) {
        SpringApplication.run(AndProviderApplication.class);
    }
}

實現 Dubbo 服務消費方

創建 ali-nacos-dubbo-consumer,端口:9103 工程

pom.xml依賴

<?xml version="1.0" encoding="UTF-8"?>
<project xmlns="http://maven.apache.org/POM/4.0.0"
         xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance"
         xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 https://maven.apache.org/xsd/maven-4.0.0.xsd">
    <parent>
        <artifactId>cloud-alibaba</artifactId>
        <groupId>com.easy</groupId>
        <version>1.0.0</version>
    </parent>

    <modelVersion>4.0.0</modelVersion>

    <artifactId>ali-nacos-dubbo-consumer</artifactId>

    <dependencies>
        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-starter-web</artifactId>
        </dependency>

        <dependency>
            <groupId>org.springframework.boot</groupId>
            <artifactId>spring-boot-actuator</artifactId>
        </dependency>

        <dependency>
            <groupId>com.easy</groupId>
            <artifactId>ali-nacos-dubbo-api</artifactId>
            <version>${project.version}</version>
        </dependency>

        <dependency>
            <groupId>com.alibaba.cloud</groupId>
            <artifactId>spring-cloud-starter-dubbo</artifactId>
        </dependency>

        <dependency>
            <groupId>com.alibaba.cloud</groupId>
            <artifactId>spring-cloud-starter-alibaba-nacos-discovery</artifactId>
        </dependency>
    </dependencies>

    <build>
        <plugins>
            <plugin>
                <groupId>org.springframework.boot</groupId>
                <artifactId>spring-boot-maven-plugin</artifactId>
            </plugin>
        </plugins>
    </build>
</project>

yaml配置文件

dubbo:
  registry:
    address: spring-cloud://localhost
  cloud:
    subscribed-services: ali-nacos-dubbo-provider

spring:
  application:
    name: ali-nacos-dubbo-consumer
  main:
    allow-bean-definition-overriding: true
  cloud:
    nacos:
      discovery:
        server-addr: 127.0.0.1:8848

實現 Dubbo 服務消費方

HomeController.java

package com.easy.andConsumer;

import com.easy.and.api.service.HelloService;
import lombok.extern.slf4j.Slf4j;
import org.apache.dubbo.config.annotation.Reference;
import org.springframework.web.bind.annotation.GetMapping;
import org.springframework.web.bind.annotation.RestController;

@RestController
@Slf4j
public class HomeController {

    @Reference
    HelloService helloService;

    @GetMapping("/hello")
    public String hello(String name) {
        return helloService.hello("雲天");
    }
}

AndConsumerApplication.java啟動類

package com.easy.andConsumer;

import org.springframework.boot.SpringApplication;
import org.springframework.boot.autoconfigure.SpringBootApplication;
import org.springframework.cloud.client.discovery.EnableDiscoveryClient;

@EnableDiscoveryClient
@SpringBootApplication
public class AndConsumerApplication {
    public static void main(String[] args) {
        SpringApplication.run(AndConsumerApplication.class, args);
    }
}

使用示例

示例關聯項目

本示例我們創建了三個項目實現

  • ali-nacos-dubbo-api:定義Dubbo服務接口工程

  • ali-nacos-dubbo-provider:Dubbo服務提供方並向nacos註冊服務,服務名:ali-nacos-dubbo-provider,端口:9001

  • ali-nacos-dubbo-consumer:Dubbo服務消費方並向nacos註冊服務,服務名:ali-nacos-dubbo-consumer,端口:9103

運行示例測試

首先要啟動服務註冊中心 nacos、ali-nacos-dubbo-provider服務及ali-nacos-dubbo-consumer服務

  • 訪問服務消費方地址: http://localhost:9103/hello

返回

你好 雲天

或者你也可以通過 curl 命令執行 HTTP GET 方法

$curl http://127.0.0.1:9103/hello

HTTP 響應為:

你好 雲天

以上結果說明應用 ali-nacos-dubbo-consumer 通過消費 Dubbo 服務,返回服務提供方 ali-nacos-dubbo-provider 運算后的內容。

以上我們完成了 Dubbo 服務提供方和消費方的入門運用,源代碼請直接參考模塊:

資料

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品在網路上成為最夯、最多人討論的話題?

※高價收購3C產品,價格不怕你比較

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

【控制系統数字仿真與CAD】實驗三:離散相似法数字仿真

一、實驗目的
  1. 了解離散相似法的基本原理
  2. 掌握離散相似法仿真的基本過程
  3. 應用離散相似法仿真非線性系統
  4. MATLAB實現離散相似法的非線性系統仿真
  5. 掌握SIMULINK仿真方法,應用於非線性系統的仿真,並對實驗結果進行分析比較

二、實驗原理

  在ASR的輸出增加限幅裝置(飽和非線性,飽和界為c=8 )。 Ce=0.031,其它參數不變。輸入為單位階躍,用離散相似法求系統各環節的輸出。

  要求:採用零階保持器和一階保持器離散化系統,分別完成本實驗。

  1、各環節的參數:

  由5個典型環節組成:

  A=[0 0 1 1 0];

  B=[tn ti Ts Tl Tm*Ce];
  C=[Kn Ki Ks 1/R R];
  D=[Kn*tn Ki*ti 0 0 0];

  還有一飽和非線性環節:c=8;

  2、各環節的離散化係數矩陣

 3、各環節的輸入作用


    (1)、u(n)可通過聯接矩陣直接求得: 


      u(n)=[u1(n), u2(n),…,un(n)]為各環節的輸入量, n為環節數。 Y(n)=[Y1(n), Y2(n),…,Yn(n)]為各環節的輸出量, r為外中參考輸入量。

    (2)、U(n)由近似表達式求得:
      

    (3)、u(n+1)用折線法近似求得:


  4、狀態和輸出計算

    (1)、一階保持器
      X=FI’.*X+FIM’.*Uk+FIJ’.*Udot;
      Y=FIC’.*X+FID’.*Uf;
    (2)、零階保持器
      X=FI’.*X+FIM’.*Uk;
      Y=FIC’.*X+FID’.*Uf;

  5、飽和非線性環節

  看作環節1(ASR)的一部分。建立satur.m文件:

function [uo]=satur(ui,c)
    if (abs(ui)<=c)
        uo=ui;
    elseif ( ui > c )
        uo = c;
    else
        uo=-c;
    end
end

 三、實驗過程

  1、新建腳本文件,命名為satur.m

function [uo]=satur(ui,c)
    if (abs(ui)<=c)
        uo=ui;
    elseif ( ui > c )
        uo = c;
    else
        uo=-c;
    end
end

  2、新建腳本文件,命名為test3.m

  完整代碼:

clc;
clear;
% ******  各環節參數  ****** %
Kn=26.7;
tn=0.03;
Ki=0.269;
ti=0.067;
Ks=76;
Ts=0.00167;
R=6.58;
T1=0.018;
Tm=0.25;
Ce=0.031;
Alpha=0.00337;
Beta=0.4;
A=[0 0 1 1 0];
B=[tn ti Ts T1 Tm*Ce];
C=[Kn Ki Ks 1/R R];
D=[Kn*tn Ki*ti 0 0 0];
c=8;
r=1;
W=[0 0 0 0 -Alpha;
    1 0 0 -Beta 0;
    0 1 0 0 0;
    0 0 1 0 -Ce;
    0 0 0 1 0];
W0=[1 0 0 0 0]';
h=0.001;
t_end=0.5;
t=0:h:t_end;
n=length(t);
% ******  各環節離散化係數  ****** %
block_num=5;
for k=1:block_num
    if(A(k)==0)
        FI(k)=1;
        FIM(k)=h*C(k)/B(k);
        FIJ(k)=h*h*C(k)/B(k)/2;
        FIC(k)=1;
        FID(k)=0;
        if(D(k)~=0)
            FID(k)=D(k)/B(k);
        end
    else
        FI(k)=exp(-h*A(k)/B(k));
        FIM(k)=(1-FI(k))*C(k)/A(k);
        FIJ(k)=h*C(k)/A(k)-FIM(k)*B(k)/A(k);
        FIC(k)=1;
        FID(k)=0;
        if(D(k)~=0)
            FIC(k)=C(k)/D(k)-A(k)/B(k);
            FID(k)=D(k)/B(k);
        end
    end
end

Y0=[0 0 0 0 0]';
Y=Y0;
X=zeros(block_num,1);
result1=Y;
Uk=zeros(block_num,1);
Ub=Uk;

for m=1:(n-1)
    Ub=Uk;
    Uk=W*Y+W0*r;
    Uf=2*Uk-Ub;
    Udot=(Uk-Ub)/h;
    
    %******  零階保持器  ******%
    X=FI'.*X+FIM'.*Uk;
    Y=FIC'.*X+FID'.*Uf;
    
    Y(1)=satur(Y(1),c);
    result1=[result1,Y];
end

Y0=[0 0 0 0 0]';
Y=Y0;
X=zeros(block_num,1);
result2=Y;
Uk=zeros(block_num,1);
Ub=Uk;
for m=1:(n-1)
    Ub=Uk;
    Uk=W*Y+W0*r;
    Uf=2*Uk-Ub;
    Udot=(Uk-Ub)/h;
    
    %******  一階保持器  ******%
    X=FI'.*X+FIM'.*Uk + FIJ'.*Udot;
    Y=FIC'.*X + FID'.*Uf;
    
    Y(1)=satur(Y(1),c);
    result2=[result2,Y];
end

plot(t,result1(5,:),’-.’,t,result2(5,:),’–‘,t,ScopeData.signals.values,’k’);
legend(‘零階保持器’,’一階保持器’,’Simulink’);

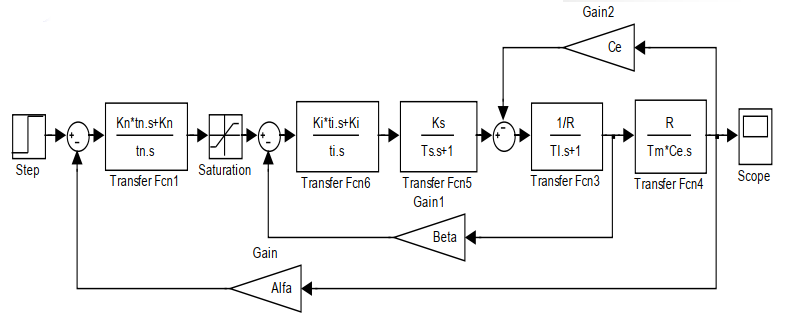
  3、在Simulink中繪製仿真圖


 注意:Simulink中的變量名和工作區變量關聯方法請點擊:https://www.cnblogs.com/KaifengGuan/p/11942615.html

四、實驗結果


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※為什麼 USB CONNECTOR 是電子產業重要的元件?

※收購3c,收購IPHONE,收購蘋果電腦-詳細收購流程一覽表

※網頁設計一頭霧水??該從何著手呢? 找到專業技術的網頁設計公司,幫您輕鬆架站!

※想要讓你的商品在網路上成為最夯、最多人討論的話題?

※高價收購3C產品,價格不怕你比較

※想知道最厲害的台北網頁設計公司推薦、台中網頁設計公司推薦專業設計師”嚨底家”!!

【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

Docker-Compose基礎與實戰,看這一篇就夠了

what & why

Compose 項目是 Docker 官方的開源項目,負責實現對 Docker 容器集群的快速編排。使用前面介紹的Dockerfile我們很容易定義一個單獨的應用容器。然而在日常開發工作中,經常會碰到需要多個容器相互配合來完成某項任務的情況。例如要實現一個 Web 項目,除了 Web 服務容器本身,往往還需要再加上後端的數據庫服務容器;再比如在分佈式應用一般包含若干個服務,每個服務一般都會部署多個實例。如果每個服務都要手動啟停,那麼效率之低、維護量之大可想而知。這時候就需要一個工具能夠管理一組相關聯的的應用容器,這就是Docker Compose。
Compose有2個重要的概念

  • 項目(Project):由一組關聯的應用容器組成的一個完整業務單元,在 docker-compose.yml 文件中定義。
  • 服務(Service):一個應用的容器,實際上可以包括若干運行相同鏡像的容器實例。

docker compose 安裝與卸載

安裝

二進制包在線安裝

curl -L https://github.com/docker/compose/releases/download/1.25.0/docker-compose-`uname -s`-`uname -m` -o /usr/local/bin/docker-compose 

sudo chmod +x /usr/local/bin/docker-compose

這個方法現在基本行不通,下載太慢了,不推薦使用。

二進制包離線安裝

從https://github.com/docker/compose/releases/download/1.25.0/docker-compose-Linux-x86_64下載對應的安裝包,比如我下載了Linux-x86_64的。

將下載好的安裝包剪切到/usr/local/bin/docker-compose目錄下
mv /app/download/docker-compose-Linux-x86_64 /usr/local/bin/docker-compose

添加執行權限
sudo chmod +x /usr/local/bin/docker-compose

pip安裝

  • 先安裝好pip工具
#安裝依賴 
yum -y install epel-release 
#安裝PIP 
yum -y install python-pip 
#升級PIP 
pip install --upgrade pip
  • 驗證pip 版本
[root@tymonitor bin]# pip --version
pip 8.1.2 from /usr/lib/python2.7/site-packages (python 2.7)
  • 安裝docker compose
    pip install -U docker-compose==1.25.0

  • 驗證docker compose版本
[root@tymonitor bin]# docker-compose --version
docker-compose version 1.25.0, build b42d419

安裝補全插件

curl -L https://raw.githubusercontent.com/docker/compose/1.25.0/contrib/completion/bash/docker-compose > /etc/bash_completion.d/docker-compose

卸載

二進制卸載

rm /usr/local/bin/docker-compose

pip卸載

pip uninstall docker-compose

docker compose 重要命令

命令選項

  • -f, –file FILE 指定使用的 Compose 模板文件,默認為 docker-compose.yml,可以多次指定。
  • -p, –project-name NAME 指定項目名稱,默認將使用所在目錄名稱作為項目名。
  • –x-networking 使用 Docker 的可拔插網絡後端特性
  • –x-network-driver DRIVER 指定網絡後端的驅動,默認為 bridge
  • –verbose 輸出更多調試信息。
  • -v, –version 打印版本並退出。

常用&重要命令

  • config
    驗證 Compose 文件格式是否正確,若正確則显示配置,若格式錯誤显示錯誤原因。
    如:docker-compose -f skywalking.yml config
    此命令不會執行真正的操作,而是显示 docker-compose 程序解析到的配置文件內容:

  • images
    列出 Compose 文件中包含的鏡像。如docker-compose -f skywalking.yml images

  • ps
    列出項目中目前的所有容器。如docker-compose -f skywalking.yml ps

  • build
    構建(重新構建)項目中的服務容器。如:docker-compose -f skywalking.yml build,一般搭配自定義鏡像,比如編寫的Dockfile,功能類似於docker build .

  • up
    該命令十分強大(重點掌握),它將嘗試自動完成包括構建鏡像,(重新)創建服務,啟動服務,並關聯服務相關容器的一系列操作。如docker-compose -f skywalking.yml up。默認情況,docker-compose up 啟動的容器都在前台,控制台將會同時打印所有容器的輸出信息,可以很方便進行調試。

    如果使用docker-compose up -d將會在後台啟動並運行所有的容器。一般推薦生產環境下使用該選項。
    默認情況,如果服務容器已經存在,docker-compose up 將會嘗試停止容器,然後重新創建(保持使用 volumes-from 掛載的卷),以保證新啟動的服務匹配 docker-compose.yml 文件的最新內容。如果用戶不希望容器被停止並重新創建,可以使用 docker-compose up --no-recreate。這樣將只會啟動處於停止狀態的容器,而忽略已經運行的服務。如果用戶只想重新部署某個服務,可以使用 docker-compose up --no-deps -d <SERVICE_NAME> 來重新創建服務並後台停止舊服務,啟動新服務,並不會影響到其所依賴的服務。此命令有如下選項:
    ①:-d 在後台運行服務容器。
    ②:--no-color 不使用顏色來區分不同的服務的控制台輸出。
    ③:--no-deps 不啟動服務所鏈接的容器。
    ④:--force-recreate 強制重新創建容器,不能與 –no-recreate 同時使用。
    ⑤:--no-recreate 如果容器已經存在了,則不重新創建,不能與 –force-recreate 同時使用。
    ⑥:--no-build 不自動構建缺失的服務鏡像。
    ⑦:-t, --timeout TIMEOUT 停止容器時候的超時(默認為 10 秒)。

  • down
    此命令停止用up命令所啟動的容器並移除網絡,如docker-compose -f skywalking.yml down

  • stop
    格式為 docker-compose stop [options] [SERVICE...]
    停止已經處於運行狀態的容器,但不刪除它。通過 docker-compose start 可以再次啟動這些容器,如果不指定service則默認停止所有的容器。如docker-compose -f skywalking.yml stop elasticsearch
    選項:
    -t, --timeout TIMEOUT 停止容器時候的超時(默認為 10 秒)。

  • start
    啟動已經存在的服務容器。用法跟上面的stop剛好相反,如docker-compose -f skywalking.yml start elasticsearch

  • restart
    重啟項目中的服務。用法跟上面的stop,start一樣

  • logs
    格式為docker-compose logs [options] [SERVICE...]
    查看服務容器的輸出。默認情況下,docker-compose 將對不同的服務輸出使用不同的顏色來區分。可以通過 –no-color 來關閉顏色。該命令在調試問題的時候十分有用。如docker-compose -f skywalking.yml logs 查看整體的日誌,docker-compose -f skywalking.yml logs elasticsearch 查看單獨容器的日誌

docker compose 模板文件

模板文件是使用 Compose 的核心,涉及到的指令關鍵字也比較多。本文主要列出幾個常見&重要的指令,其他指令大家可以自行百度。
默認的模板文件名稱為 docker-compose.yml,格式為 YAML 格式。

version: '3'
services:
  elasticsearch:
    image: elasticsearch:6.8.5
    container_name: elasticsearch
    restart: always
    volumes:
      - /app/skywalking/elasticsearch/data:/usr/share/elasticsearch/data:rw
      - /app/skywalking/elasticsearch/conf/elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml
      - /app/skywalking/elasticsearch/conf/jvm.options:/usr/share/elasticsearch/config/jvm.options
      - /app/skywalking/elasticsearch/logs:/usr/share/elasticsearch/logs:rw
    environment:
      - TZ=Asia/Shanghai
      - xpack.monitoring.enabled=false
      - xpack.watcher.enabled=false
    ports:
      - "9200:9200"
      - "9300:9300"

注意每個服務都必須通過 image 指令指定鏡像或 build 指令(需要 Dockerfile)等來自動構建生成鏡像。如果使用 build 指令,在 Dockerfile 中設置的選項(例如:CMD, EXPOSE, VOLUME, ENV 等) 將會自動被獲取,無需在 docker-compose.yml 中重複設置。

常用&重要命令

  • images
    指定為鏡像名稱或鏡像 ID。如果鏡像在本地不存在,Compose 將會嘗試拉取這個鏡像。
image: apache/skywalking-oap-server:6.5.0
image: apache/skywalking-ui:6.5.0
  • ports
    暴露端口信息。
    使用宿主端口:容器端口 (HOST:CONTAINER) 格式,或者僅僅指定容器的端口(宿主將會隨機選擇端口)都可以,端口字符串都使用引號包括起來的字符串格式。
ports: 
    - "3000" 
    - "8080:8080" 
    - "127.0.0.1:8001:8001"
  • volumes
    數據卷所掛載路徑設置。可以設置為宿主機路徑(HOST:CONTAINER)或者數據卷名稱(VOLUME:CONTAINER),並且可以設置訪問模式 (HOST:CONTAINER:ro)。
volumes:
      - /app/skywalking/elasticsearch/data:/usr/share/elasticsearch/data:rw
      - conf/elasticsearch.yml:/usr/share/elasticsearch/config/elasticsearch.yml
version: "3"
services:
  my_src:
    image: mysql:8.0
    volumes:
      - mysql_data:/var/lib/mysql
volumes:
  mysql_data:
  • ulimits
    指定容器的 ulimits 限制值。
    例如,指定最大進程數為 65535,指定文件句柄數為 20000(軟限制,應用可以隨時修改,不能超過硬限制) 和 40000(系統硬限制,只能 root 用戶提高)。
ulimits:
   nproc: 65535
   nofile:
     soft: 20000
     hard: 40000
  • depends_on
    解決容器的依賴、啟動先後的問題。以下例子中會先啟動 redis mysql 再啟動 web
version: '3'
services:
  web:
    build: .
    depends_on:
      - db
      - redis     
  redis:
    image: redis    
  db:
    image: mysql
  • environment
    設置環境變量。你可以使用數組或字典兩種格式。
environment:
      SW_STORAGE: elasticsearch
      SW_STORAGE_ES_CLUSTER_NODES: elasticsearch:9200
      
environment:
      - SW_STORAGE= elasticsearch
      - SW_STORAGE_ES_CLUSTER_NODES=elasticsearch:9200
  • restart
    指定容器退出后的重啟策略為始終重啟。該命令對保持服務始終運行十分有效,在生產環境中推薦配置為 always 或者 unless-stopped。
    restart: always

docker-compose 實戰

首先我需要推薦兩件事:

  • 配置docker加速鏡像
    創建或修改/etc/docker/daemon.json
sudo mkdir -p /etc/docker
sudo tee /etc/docker/daemon.json <<-'EOF'
{
    "registry-mirrors": [
        "https://hub-mirror.c.163.com",
        "https://mirror.ccs.tencentyun.com",
        "https://reg-mirror.qiniu.co"
    ]
}
EOF
sudo systemctl daemon-reload
sudo systemctl restart docker
  • 給你的ide工具裝上docker插件

本次實戰我們以docker-compose部署skywalking為例。編寫skywalking.yml,內容如下。

version: '3.3'
services:
  elasticsearch:
    image: docker.elastic.co/elasticsearch/elasticsearch:6.8.5
    container_name: elasticsearch
    restart: always
    ports:
      - 9200:9200
      - 9300:9300
    environment:
      discovery.type: single-node
    ulimits:
      memlock:
        soft: -1
        hard: -1
  oap:
    image: skywalking/oap
    container_name: oap
    depends_on:
      - elasticsearch
    links:
      - elasticsearch
    restart: always
    ports:
      - 11800:11800
      - 12800:12800
    environment:
      SW_STORAGE: elasticsearch
      SW_STORAGE_ES_CLUSTER_NODES: elasticsearch:9200
  ui:
    image: skywalking/ui
    container_name: ui
    depends_on:
      - oap
    links:
      - oap
    restart: always
    ports:
      - 8080:8080
    environment:
      SW_OAP_ADDRESS: oap:12800

部署完成后將其上傳至服務器,執行docker-compose -f /app/skywalking.yml up -d即可。

個人公眾號:JAVA日知錄 ,

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選
設計模式之美學習(九):業務開發常用的基於貧血模型的MVC架構違背OOP嗎?

我們都知道,很多業務系統都是基於 MVC 三層架構來開發的。實際上,更確切點講,這是一種基於貧血模型的 MVC 三層架構開發模式。

雖然這種開發模式已經成為標準的 Web 項目的開發模式,但它卻違反了面向對象編程風格,是一種徹徹底底的面向過程的編程風格,因此而被有些人稱為反模式(anti-pattern)。特別是領域驅動設計(Domain Driven Design,簡稱 DDD)盛行之後,這種基於貧血模型的傳統的開發模式就更加被人詬病。而基於充血模型的 DDD 開發模式越來越被人提倡。

基於上面的描述,我們先搞清楚下面幾個問題:

  • 什麼是貧血模型?什麼是充血模型?
  • 為什麼說基於貧血模型的傳統開發模式違反 OOP?
  • 基於貧血模型的傳統開發模式既然違反 OOP,那又為什麼如此流行?
  • 什麼情況下我們應該考慮使用基於充血模型的 DDD 開發模式?

什麼是基於貧血模型的傳統開發模式?

對於大部分的後端開發工程師來說,MVC 三層架構都不會陌生。

MVC 三層架構中的 M 表示 Model,V 表示 View,C 表示 Controller。它將整個項目分為三層:展示層、邏輯層、數據層。MVC 三層開發架構是一個比較籠統的分層方式,落實到具體的開發層面,很多項目也並不會 100% 遵從 MVC 固定的分層方式,而是會根據具體的項目需求,做適當的調整。

比如,現在很多 Web 或者 App 項目都是前後端分離的,後端負責暴露接口給前端調用。這種情況下,我們一般就將後端項目分為 Repository 層、Service 層、Controller 層。其中,Repository 層負責數據訪問,Service 層負責業務邏輯,Controller 層負責暴露接口。當然,這隻是其中一種分層和命名方式。不同的項目、不同的團隊,可能會對此有所調整。不過,萬變不離其宗,只要是依賴數據庫開發的 Web 項目,基本的分層思路都大差不差。

再來看一下,什麼是貧血模型?

目前幾乎所有的業務後端系統,都是基於貧血模型的。舉一個簡單的例子來解釋一下。

////////// Controller+VO(View Object) //////////
public class UserController {
  private UserService userService; //通過構造函數或者IOC框架注入
  
  public UserVo getUserById(Long userId) {
    UserBo userBo = userService.getUser(userId);
    UserVo userVo = [...convert userBo to userVo...];
    return userVo;
  }
}

public class UserVo {//省略其他屬性、get/set/construct方法
  private Long id;
  private String name;
  private String cellphone;
}

////////// Service+BO(Business Object) //////////
public class UserService {
  private UserRepository userRepository; //通過構造函數或者IOC框架注入
  
  public UserBo getUserById(Long userId) {
    UserEntity userEntity = userRepository.getUserById(userId);
    UserBo userBo = [...convert userEntity to userBo...];
    return userBo;
  }
}

public class UserBo {//省略其他屬性、get/set/construct方法
  private Long id;
  private String name;
  private String cellphone;
}

////////// Repository+Entity //////////
public class UserRepository {
  public UserEntity getUserById(Long userId) { //... }
}

public class UserEntity {//省略其他屬性、get/set/construct方法
  private Long id;
  private String name;
  private String cellphone;
}

平時開發 Web 後端項目的時候,基本上都是這麼組織代碼的。其中,UserEntity 和 UserRepository 組成了數據訪問層,UserBo 和 UserService 組成了業務邏輯層,UserVo 和 UserController 在這裏屬於接口層。

從代碼中可以發現,UserBo 是一個純粹的數據結構,只包含數據,不包含任何業務邏輯。業務邏輯集中在 UserService 中。我們通過 UserService 來操作 UserBo。換句話說,Service 層的數據和業務邏輯,被分割為 BO 和 Service 兩個類中。像 UserBo 這樣,只包含數據,不包含業務邏輯的類,就叫作貧血模型(Anemic Domain Model)。同理,UserEntity、UserVo 都是基於貧血模型設計的。這種貧血模型將數據與操作分離,破壞了面向對象的封裝特性,是一種典型的面向過程的編程風格。

什麼是基於充血模型的 DDD 開發模式?

首先,我們先來看一下,什麼是充血模型?

在貧血模型中,數據和業務邏輯被分割到不同的類中。充血模型(Rich Domain Model)正好相反,數據和對應的業務邏輯被封裝到同一個類中。因此,這種充血模型滿足面向對象的封裝特性,是典型的面向對象編程風格。

接下來,再來看一下,什麼是領域驅動設計?

領域驅動設計,即 DDD,主要是用來指導如何解耦業務系統,劃分業務模塊,定義業務領域模型及其交互。領域驅動設計這個概念並不新穎,早在 2004 年就被提出了,到現在已經有十幾年的歷史了。不過,它被大眾熟知,還是基於另一個概念的興起,那就是微服務。

除了監控、調用鏈追蹤、API 網關等服務治理系統的開發之外,微服務還有另外一個更加重要的工作,那就是針對公司的業務,合理地做微服務拆分。而領域驅動設計恰好就是用來指導劃分服務的。所以,微服務加速了領域驅動設計的盛行。

領域驅動設計有點兒類似敏捷開發、SOA、PAAS 等概念,聽起來很高大上,但實際上只值“五分錢”。即便你沒有聽說過領域驅動設計,對這個概念一無所知,只要你是在開發業務系統,也或多或少都在使用它。做好領域驅動設計的關鍵是,看你對自己所做業務的熟悉程度,而並不是對領域驅動設計這個概念本身的掌握程度。即便你對領域驅動搞得再清楚,但是對業務不熟悉,也並不一定能做出合理的領域設計。所以,不要把領域驅動設計當銀彈,不要花太多的時間去過度地研究它。

實際上,基於充血模型的 DDD 開發模式實現的代碼,也是按照 MVC 三層架構分層的。Controller 層還是負責暴露接口,Repository 層還是負責數據存取,Service 層負責核心業務邏輯。它跟基於貧血模型的傳統開發模式的區別主要在 Service 層。

在基於貧血模型的傳統開發模式中,Service 層包含 Service 類和 BO 類兩部分,BO 是貧血模型,只包含數據,不包含具體的業務邏輯。業務邏輯集中在 Service 類中。在基於充血模型的 DDD 開發模式中,Service 層包含 Service 類和 Domain 類兩部分。Domain 就相當於貧血模型中的 BO。不過,Domain 與 BO 的區別在於它是基於充血模型開發的,既包含數據,也包含業務邏輯。而 Service 類變得非常單薄。總結一下的話就是,基於貧血模型的傳統的開發模式,重 Service 輕 BO;基於充血模型的 DDD 開發模式,輕 Service 重 Domain。

為什麼基於貧血模型的傳統開發模式如此受歡迎?

基於貧血模型的傳統開發模式,將數據與業務邏輯分離,違反了 OOP 的封裝特性,實際上是一種面向過程的編程風格。但是,現在幾乎所有的 Web 項目,都是基於這種貧血模型的開發模式,甚至連 Java Spring 框架的官方 demo,都是按照這種開發模式來編寫的。

面向過程編程風格有種種弊端,比如,數據和操作分離之後,數據本身的操作就不受限制了。任何代碼都可以隨意修改數據。既然基於貧血模型的這種傳統開發模式是面向過程編程風格的,那它又為什麼會被廣大程序員所接受呢?

第一點原因是,大部分情況下,我們開發的系統業務可能都比較簡單,簡單到就是基於 SQL 的 CRUD 操作,所以,我們根本不需要動腦子精心設計充血模型,貧血模型就足以應付這種簡單業務的開發工作。除此之外,因為業務比較簡單,即便我們使用充血模型,那模型本身包含的業務邏輯也並不會很多,設計出來的領域模型也會比較單薄,跟貧血模型差不多,沒有太大意義。

第二點原因是,充血模型的設計要比貧血模型更加有難度。因為充血模型是一種面向對象的編程風格。我們從一開始就要設計好針對數據要暴露哪些操作,定義哪些業務邏輯。而不是像貧血模型那樣,我們只需要定義數據,之後有什麼功能開發需求,我們就在 Service 層定義什麼操作,不需要事先做太多設計。

第三點原因是,思維已固化,轉型有成本。基於貧血模型的傳統開發模式經歷了這麼多年,已經深得人心、習以為常。你隨便問一個旁邊的大齡同事,基本上他過往參与的所有 Web 項目應該都是基於這個開發模式的,而且也沒有出過啥大問題。如果轉向用充血模型、領域驅動設計,那勢必有一定的學習成本、轉型成本。很多人在沒有遇到開發痛點的情況下,是不願意做這件事情的。

什麼項目應該考慮使用基於充血模型的 DDD 開發模式?

基於貧血模型的傳統的開發模式,比較適合業務比較簡單的系統開發。相對應的,基於充血模型的 DDD 開發模式,更適合業務複雜的系統開發。比如,包含各種利息計算模型、還款模型等複雜業務的金融系統。

這兩種開發模式,落實到代碼層面,區別不就是一個將業務邏輯放到 Service 類中,一個將業務邏輯放到 Domain 領域模型中嗎?為什麼基於貧血模型的傳統開發模式,就不能應對複雜業務系統的開發?而基於充血模型的 DDD 開發模式就可以呢?

實際上,除了我們能看到的代碼層面的區別之外(一個業務邏輯放到 Service 層,一個放到領域模型中),還有一個非常重要的區別,那就是兩種不同的開發模式會導致不同的開發流程。基於充血模型的 DDD 開發模式的開發流程,在應對複雜業務系統的開發的時候更加有優勢。為什麼這麼說呢?先來回憶一下,我們平時基於貧血模型的傳統的開發模式,都是怎麼實現一個功能需求的。

不誇張地講,我們平時的開發,大部分都是 SQL 驅動(SQL-Driven)的開發模式。我們接到一個後端接口的開發需求的時候,就去看接口需要的數據對應到數據庫中,需要哪張表或者哪幾張表,然後思考如何編寫 SQL 語句來獲取數據。之後就是定義 Entity、BO、VO,然後模板式地往對應的 Repository、Service、Controller 類中添加代碼。

業務邏輯包裹在一個大的 SQL 語句中,而 Service 層可以做的事情很少。SQL 都是針對特定的業務功能編寫的,復用性差。當我要開發另一個業務功能的時候,只能重新寫個滿足新需求的 SQL 語句,這就可能導致各種長得差不多、區別很小的 SQL 語句滿天飛。

所以,在這個過程中,很少有人會應用領域模型、OOP 的概念,也很少有代碼復用意識。對於簡單業務系統來說,這種開發方式問題不大。但對於複雜業務系統的開發來說,這樣的開發方式會讓代碼越來越混亂,最終導致無法維護。

如果我們在項目中,應用基於充血模型的 DDD 的開發模式,那對應的開發流程就完全不一樣了。在這種開發模式下,我們需要事先理清楚所有的業務,定義領域模型所包含的屬性和方法。領域模型相當於可復用的業務中間層。新功能需求的開發,都基於之前定義好的這些領域模型來完成。

越複雜的系統,對代碼的復用性、易維護性要求就越高,我們就越應該花更多的時間和精力在前期設計上。而基於充血模型的 DDD 開發模式,正好需要我們前期做大量的業務調研、領域模型設計,所以它更加適合這種複雜系統的開發。

重點回顧

平時做 Web 項目的業務開發,大部分都是基於貧血模型的 MVC 三層架構,這裏把它稱為傳統的開發模式。之所以稱之為“傳統”,是相對於新興的基於充血模型的 DDD 開發模式來說的。基於貧血模型的傳統開發模式,是典型的面向過程的編程風格。相反,基於充血模型的 DDD 開發模式,是典型的面向對象的編程風格。

不過,DDD 也並非銀彈。對於業務不複雜的系統開發來說,基於貧血模型的傳統開發模式簡單夠用,基於充血模型的 DDD 開發模式有點大材小用,無法發揮作用。相反,對於業務複雜的系統開發來說,基於充血模型的 DDD 開發模式,因為前期需要在設計上投入更多時間和精力,來提高代碼的復用性和可維護性,所以相比基於貧血模型的開發模式,更加有優勢。

思考

  • 對於舉的例子中,UserEntity、UserBo、UserVo 包含的字段都差不多,是否可以合併為一個類呢?

參考:

本文由博客一文多發平台 發布!
更多內容請點擊我的博客

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

如何使用C#調用C++類虛函數(即動態內存調用)

  本文講解如何使用C#調用只有.h頭文件的c++類的虛函數(非實例函數,因為非虛函數不存在於虛函數表,無法通過類對象偏移計算地址,除非用export導出,而gcc默認是全部導出實例函數,這也是為什麼msvc需要.lib,如果你不清楚但希望了解,可以選擇找我擺龍門陣),並以COM組件的c#直接調用(不需要引用生成introp.dll)舉例。

  我們都知道,C#支持調用非託管函數,使用P/Inovke即可方便實現,例如下面的代碼

[DllImport("msvcrt", EntryPoint = "memcpy", CallingConvention = CallingConvention.Cdecl)]
public static extern void memcpy(IntPtr dest, IntPtr src, int count);

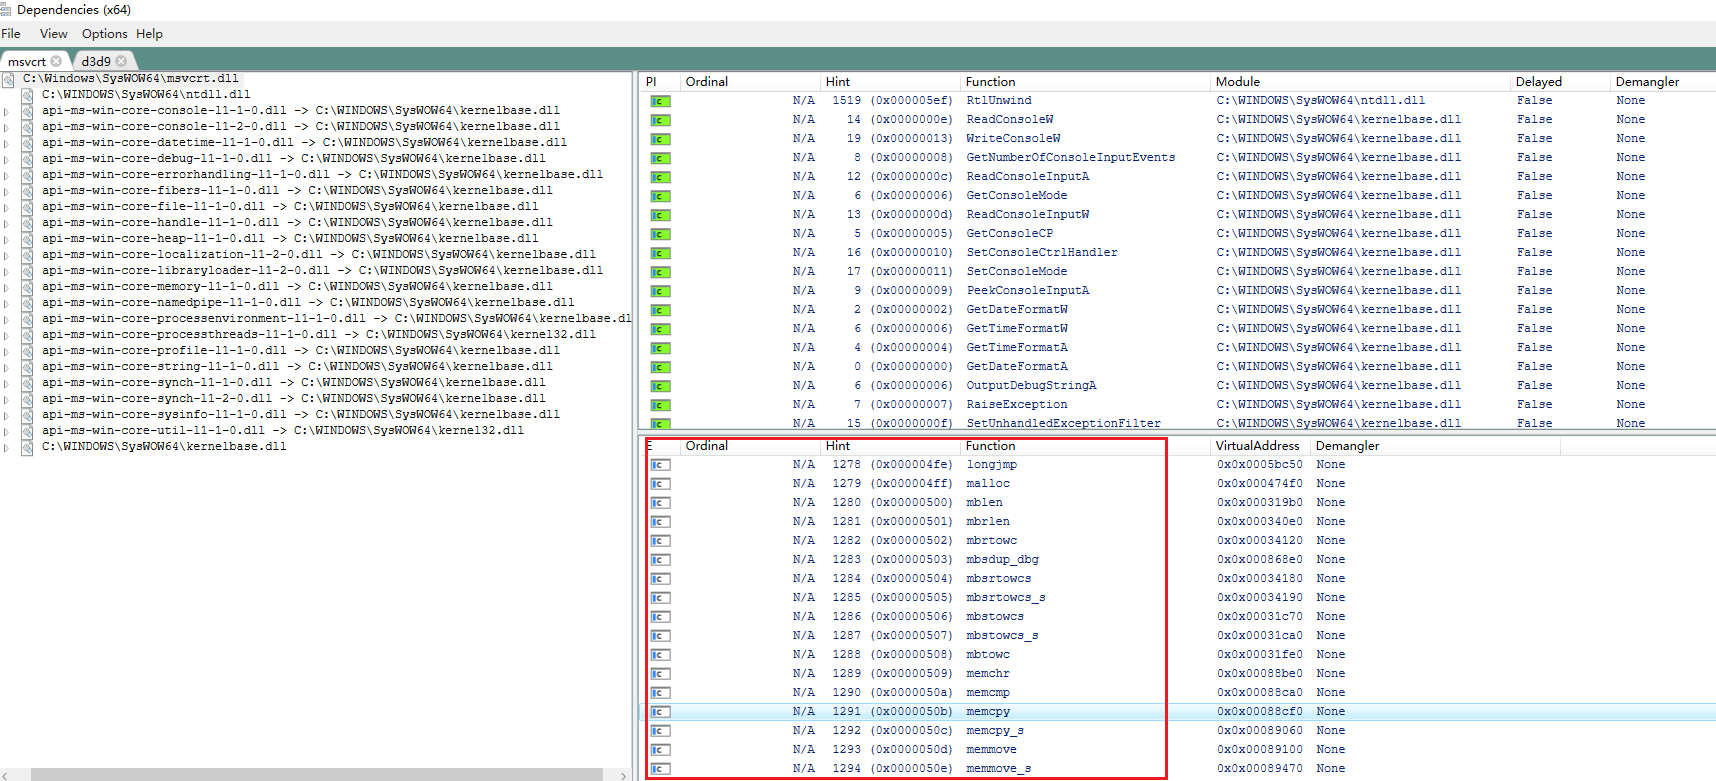
不過使用DllImport只能調用某個DLL中標記為導出的函數,我們可以使用一些工具查看函數導出,如下圖

一般會導出的函數,都是c語言格式的。

  C++類因為有多態,所以內存中維護了一個虛函數表,如果我們知道了某個C++類的內存地址,也有它的頭文件,那麼我們就能自己算出想要調用的某個函數的內存地址從而直接call,下面是一個簡單示例

#include <iostream>

class A_A_A {
public:
    virtual void hello() {
        std::cout << "hello from A\n";
    };
};

//typedef void (*HelloMethod)(void*);

int main()
{
    A_A_A* a = new A_A_A();
    a->hello();

    //HelloMethod helloMthd = *(HelloMethod *)*(void**)a;
    
    //helloMthd(a);
    (*(void(**)(void*))*(void**)a)(a);

    int c;
    std::cin >> c;
}

(上文中將第23行註釋掉,然後將其他註釋行打開也是一樣的效果,可能更便於閱讀)
從代碼中大家很容易看出,c++的類的內存結構是一個虛函數表二級指針(數組,多重繼承時可能有多個),每個虛函數表又是一個函數二級指針(數組,多少個虛函數就有多少個指針)。上文中我們假使只知道a是一個類對象,它的第一個虛函數是void (*) (void)類型的,那麼我們可以直接call它的函數。

  接下來開始騷操作,我們嘗試用c#來調用一個c++的虛函數,首先寫一個c++的dll,並且我們提供一個c格式的導出函數用於提供一個new出的對象(畢竟c++的new操作符很複雜,而且實際中我們經常是可以拿到這個new出來的對象,後面的com組件調用部分我會詳細說明),像下面這樣

dll.h

class DummyClass {
private:
    virtual void sayHello();
};

dll.cpp

#include "dll.h"
#include <stdio.h>

void DummyClass::sayHello() {
    printf("Hello World\n");
}

extern "C" __declspec(dllexport) DummyClass* __stdcall newObj() {
    return new DummyClass();
}

我們編譯出的dll長這樣

讓我們編寫使用C#來調用sayHello

using System;
using System.Runtime.InteropServices;

namespace ConsoleApp2
{
    class Program
    {
        [DllImport("Dll1", EntryPoint = "newObj")]
        static extern IntPtr CreateObject();

        [UnmanagedFunctionPointer(CallingConvention.ThisCall)]
        delegate void voidMethod1(IntPtr thisPtr);

        static void Main(string[] args)
        {
            IntPtr dummyClass = CreateObject();
            IntPtr vfptr = Marshal.ReadIntPtr(dummyClass);
            IntPtr funcPtr = Marshal.ReadIntPtr(vfptr);
            voidMethod1 voidMethod = (voidMethod1)Marshal.GetDelegateForFunctionPointer(funcPtr, typeof(voidMethod1));
            voidMethod(dummyClass);

            Console.ReadKey();
        }
    }
}

(因為調用的是c++的函數,所以this指針是第一個參數,當然,不同調用約定時它入棧方式和順序不一樣)
下面有一種另外的寫法

using System;
using System.Reflection;
using System.Reflection.Emit;
using System.Runtime.InteropServices;

namespace ConsoleApp2
{
    class Program
    {
        [DllImport("Dll1", EntryPoint = "newObj")]
        static extern IntPtr CreateObject();

        //[UnmanagedFunctionPointer(CallingConvention.ThisCall)]
        //delegate void voidMethod1(IntPtr thisPtr);

        static void Main(string[] args)
        {
            IntPtr dummyClass = CreateObject();
            IntPtr vfptr = Marshal.ReadIntPtr(dummyClass);
            IntPtr funcPtr = Marshal.ReadIntPtr(vfptr);
            /*voidMethod1 voidMethod = (voidMethod1)Marshal.GetDelegateForFunctionPointer(funcPtr, typeof(voidMethod1));
            voidMethod(dummyClass);*/

            AssemblyName MyAssemblyName = new AssemblyName();
            MyAssemblyName.Name = "DummyAssembly";
            AssemblyBuilder MyAssemblyBuilder = AppDomain.CurrentDomain.DefineDynamicAssembly(MyAssemblyName, AssemblyBuilderAccess.Run);
            ModuleBuilder MyModuleBuilder = MyAssemblyBuilder.DefineDynamicModule("DummyModule");
            MethodBuilder MyMethodBuilder = MyModuleBuilder.DefineGlobalMethod("DummyFunc", MethodAttributes.Public | MethodAttributes.Static, typeof(void), new Type[] { typeof(int) });
            ILGenerator IL = MyMethodBuilder.GetILGenerator();

            IL.Emit(OpCodes.Ldarg, 0);
            IL.Emit(OpCodes.Ldc_I4, funcPtr.ToInt32());

            IL.EmitCalli(OpCodes.Calli, CallingConvention.ThisCall, typeof(void), new Type[] { typeof(int) });
            IL.Emit(OpCodes.Ret);

            MyModuleBuilder.CreateGlobalFunctions();

            MethodInfo MyMethodInfo = MyModuleBuilder.GetMethod("DummyFunc");

            MyMethodInfo.Invoke(null, new object[] { dummyClass.ToInt32() });

            Console.ReadKey();
        }
    }
}

上文中的方法雖然複雜了一點,但……就是沒什麼用。不用懷疑!

文章寫到這裏,可能有童鞋就要發問了。你說這麼多,tmd到底有啥用?那接下來,我舉一個栗子,activex組件的直接調用!
以前,我們調用activex組件需要做很多複雜的事情,首先需要使用命令行調用regsvr32將dll註冊到系統,然後回到vs去引用com組件是吧

  仔細想想,需要嗎?並不需要,因為兩個原因:

  • COM組件規定DLL需要給出一個DllGetClassObject函數,它就可以為我們在DLL內部new一個所需對象
  • COM組件返回的對象其實就是一個只有虛函數的C++類對象(COM組件規定屬性和事件用getter/setter方式實現)
  • COM組件其實不需要用戶手動註冊,執行regsvr32會操作註冊表,而且32位/64位會混淆,其實regsvr32隻是調用了DLL導出函數DllRegisterServer,而這個函數的實現一般只是把自己註冊到註冊表中,這一步可有可無(特別是對於我們已經知道某個activex的dll存在路徑且它能提供的服務時,如果你非要註冊,使用p/invoke調用該dll的DllRegisterServer函數是一樣的效果)

因此,假如我們有一個activex控件(例如vlc),我們希望把它嵌入我們程序中,我們先看看常規的做法(本文沒有討論帶窗體的vlc,因為窗體這塊兒又複雜一些),直接貼圖:

看起來很簡單,但當我們需要打包給客戶使用時就很麻煩,涉及到嵌入vlc的安裝程序。而當我們會動態內存調用之後,就可以不註冊而使用vlc的功能,我先貼出代碼:

using System;
using System.Runtime.InteropServices;

namespace ConsoleApp3
{
    class Program
    {
        [DllImport("kernel32")]
        static extern IntPtr LoadLibraryEx(string path, IntPtr hFile, int dwFlags);
        [DllImport("kernel32")]
        static extern IntPtr GetProcAddress(IntPtr dll, string func);

        delegate int DllGetClassObject(Guid clsid, Guid iid, ref IntPtr ppv);

        delegate int CreateInstance(IntPtr _thisPtr, IntPtr unkown, Guid iid, ref IntPtr ppv);

        delegate int getVersionInfo(IntPtr _thisPtr, [MarshalAs(UnmanagedType.BStr)] out string bstr);

        static void Main(string[] args)
        {
            IntPtr dll = LoadLibraryEx(@"D:\Program Files\VideoLAN\VLC\axvlc.dll", default, 8);
            IntPtr func = GetProcAddress(dll, "DllGetClassObject");
            DllGetClassObject dllGetClassObject = (DllGetClassObject)Marshal.GetDelegateForFunctionPointer(func, typeof(DllGetClassObject));

            Guid vlc = new Guid("2d719729-5333-406c-bf12-8de787fd65e3");
            Guid clsid = new Guid("9be31822-fdad-461b-ad51-be1d1c159921");
            Guid iidClassFactory = new Guid("00000001-0000-0000-c000-000000000046");
            IntPtr objClassFactory = default;
            dllGetClassObject(clsid, iidClassFactory, ref objClassFactory);
            CreateInstance createInstance = (CreateInstance)Marshal.GetDelegateForFunctionPointer(Marshal.ReadIntPtr(Marshal.ReadIntPtr(objClassFactory) + IntPtr.Size * 3), typeof(CreateInstance));
            IntPtr obj = default;
            createInstance(objClassFactory, default, vlc, ref obj);
            getVersionInfo getVersion = (getVersionInfo)Marshal.GetDelegateForFunctionPointer(Marshal.ReadIntPtr(Marshal.ReadIntPtr(obj) + IntPtr.Size * 18), typeof(getVersionInfo));
            string versionInfo;
            getVersion(obj, out versionInfo);

            Console.ReadKey();
        }
    }
}

  上文中的代碼有幾處可能大家不容易懂,特別是指針偏移量的運算,這裏面有比較複雜的地方,文章篇幅有限,下來咱們細細研究。

  從11年下半年開始學習編程到現在已經很久了,有時候會覺得沒什麼奔頭。其實人生,無外乎兩件事,愛情和青春,我希望大家能有抓住的,就不要放手。兩年前,我為了要和一個女孩子多說幾句話,給人家講COM組件,其實我連c++有虛函數表都不知道,時至今日,我已經失去了她。今後怕是一直會任由靈魂遊盪,半夢半醒,即是人生。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※公開收購3c價格,不怕被賤賣!

※想知道網站建置、網站改版該如何進行嗎?將由專業工程師為您規劃客製化網頁設計及後台網頁設計

※不管是台北網頁設計公司、台中網頁設計公司,全省皆有專員為您服務

※Google地圖已可更新顯示潭子電動車充電站設置地點!!

※帶您來看台北網站建置,台北網頁設計,各種案例分享

在React舊項目中安裝並使用TypeScript的實踐

前言

本篇文章默認您大概了解什麼是TypeScript,主要講解如何在React舊項目中安裝並使用TypeScript。

寫這個的目的主要是網上關於TypeScript這塊的講解雖然很多,但都是一些語法概念或者簡單例子,真正改造一個React舊項目使用TypeScript的文章很少。

所以在這裏記錄下改造一個React項目的實踐。

博客內容部分參照 ,這個網站有官方文檔的中文版。

安裝TypeScript及相關庫

對於集成了TypeScript的腳手架可以略過這一步,這裏主要講一下如何將TypeScript集成到一個React腳手架中。

首先執行

npm install --save @types/react @types/react-dom

這一步主要是為了獲取react和react-dom的聲明文件,因為並不是所有的庫都有TypeScript的聲明文件,所以通過運行

npm install --save @types/庫名字

的方式來獲取TypeScript的聲明文件。

只有獲取了聲明文件,才能實現對這個庫的類型檢查。

如果你使用了一些其它的沒有聲明文件的庫,那麼可能也需要這麼做。

然後運行命令:

npm install --save-dev typescript awesome-typescript-loader source-map-loader

這一步,我們安裝了typescript、awesome-typescript-loader和source-map-loader。

awesome-typescript-loader可以讓Webpack使用TypeScript的標準配置文件tsconfig.json編譯TypeScript代碼。

source-map-loader使用TypeScript輸出的sourcemap文件來告訴webpack何時生成自己的sourcemaps,源碼映射,方便調試。

添加TypeScript配置文件

在項目根目錄下創建一個tsconfig.json文件,以下為內容示例:

{
  "compilerOptions": {
    "allowSyntheticDefaultImports": true, // 允許從沒有設置默認導出的模塊中默認導入。這並不影響代碼的輸出,僅為了類型檢查。
    "outDir": "./dist/", // 重定向輸出目錄
    "sourceMap": true, // 生成相應的 .map文件
    "noImplicitAny": true, // 在表達式和聲明上有隱含的 any類型時報錯。
    "module": "esnext", // 模塊引入方式
    "target": "esnext", // 指定ECMAScript目標版本
    "moduleResolution": "node", // 決定如何處理模塊
    "lib": [
      "esnext",
      "dom"
    ], // 編譯過程中需要引入的庫文件的列表。
    "skipLibCheck": true, //忽略所有庫中的聲明文件( *.d.ts)的類型檢查。
    "jsx": "react" // 在 .tsx文件里支持JSX
  },
  "include": [
    "./src/**/*", // 這個表示處理根目錄的src目錄下所有的.ts和.tsx文件,並不是所有文件
  ]
}

skipLibCheck非常重要,並不是每個庫都能通過typescript的檢測。

moduleResolution設為node也很重要。如果不這麼設置的話,找聲明文件的時候typescript不會在node_modules這個文件夾中去找。

更多配置文件信息可以參考:。

配置webpack

這裏列出一些TypeScript需要在webpack中使用的配置。

解析tsx文件的rule配置

示例如下:

module: {
    rules: [
      {
        test: /\.jsx?$/,
        exclude: /(node_modules)/,
        use: {
          loader: 'babel-loader',
          options: {
            presets: ['react', 'env', 'stage-0', 'stage-3'],
            plugins: [
              'transform-decorators-legacy',
              ['import', { libraryName: 'antd', style: 'css' }], // `style: true` 會加載 less 文件
            ],
          },
        },
      },
      { test: /\.tsx?$/, loader: "awesome-typescript-loader" }
      //...
    ]
    //...
}

其實就只是多加了一行:

{ test: /\.tsx?$/, loader: "awesome-typescript-loader" }

注意這一行需要加在解析jsx的rule下面,因為rule的執行順序是從下往上的,先解析tsx和ts再解析js和jsx。

當然用

enforce: 'pre'

調整過rule順序的可以不用在意這一點。

解決使用css-moudule的問題

如果代碼中使用了以下這種代碼:

import styles from './index.css'

那麼很可能報下面的錯:

Cannot find module './index.css'

解決方法就是在根目錄下新建文件一個叫declaration.d.ts的文件,內容為:

declare module '*.css' {
  const content: any;
  export default content;
}

這行代碼就是為所有的css文件進行聲明。

同時需要更改一下我們之前的tsconfig.json文件,將這個文件路徑放在include中:

"include": [
  "./src/**/*", 
  "./declaration.d.ts"
]

這個問題有通過安裝一些庫來解決的辦法,但是會給每個css生成一個聲明文件,感覺有點奇怪,我這裏自己考慮了一下採用了上面這種方法。

用於省略後綴名的配置

如果你慣於在使用

import Chart from './Chart/index.jsx'

時省略後綴,即:

import Chart from './Chart/index'

那麼在webpack的resolve中同樣需要加入ts和tsx:

resolve: {
  extensions: [".ts", ".tsx", ".js", ".jsx"]
},

引入Ant Design

實際上這個東西Ant Design的官網上就有怎麼在TypeScript中使用:。

那麼為什麼還是要列出來呢?

因為這裏要指出,對於已經安裝了Ant Design的舊項目而言(一般都是配了按需加載的吧),在安裝配置TypeScript時上面這個文檔基本沒有任何用處。

在網上可以搜到的貌似都是文檔中的方案,而實際上我們需要做的只是安裝ts-import-plugin。

npm i ts-import-plugin --save-dev

然後結合之前的 awesome-typescript-loader ,在webpack中進行如下配置

const tsImportPluginFactory = require('ts-import-plugin')

module.exports = {
  // ...
  module: {
    rules: [
      {
        test: /\.tsx?$/,
        loader: "awesome-typescript-loader",
        options: {
          getCustomTransformers: () => ({
            before: [tsImportPluginFactory([
              {
                libraryName: 'antd',
                libraryDirectory: 'lib',
                style: 'css'
              }
            ])]
          }),
        },
        exclude: /node_modules/
      }
    ]
  },
  // ...
}

配置完成,修改前的準備

注意,直到這一步,實際上您的項目在編譯過程中仍然沒有用到TypeScript。

因為我們這裏只會用TypeScript處理.ts和.tsx後綴的文件,除非在配置中將allowJs設為true。

在使用之前,默認您已經對TypeScript語法有了了解,不了解可以參考:。

也就是說,經過了上面的這些步驟,您的原有代碼在不改動後綴的情況下應該是可以繼續用的。

如果要使用TypeScript,那麼新建tsx和ts文件,或者修改原有的文件後綴名即可。

接下來會列出一些典型的修改示例。

函數式組件的修改示例(含children)

import React from 'react'
import styles from './index.css'

interface ComputeItemProps {
  label: string;
  children: React.ReactNode;
}

function ComputeItem({ label, children }: ComputeItemProps) {
  return <div className={styles['item']}>
    <div className={styles['label']}>{label}:</div>
    <div className={styles['content']}>{children}</div>
  </div>
}
export default ComputeItem

這個例子中語法都可以在TypeScript的官網查到,唯一需要注意的是children的類型是React.ReactNode。

class組件修改示例(含函數聲明,事件參數的定義)

import React from 'react'
import styles from './index.css'

interface DataSourceItem {
  dayOfGrowth: string;
  netValueDate: string;
}

interface ComputeProps {
  fundCode: string;
  dataSource: DataSourceItem[];
  onChange(value: Object): void;
}

export default class Compute extends React.Component<ComputeProps, Object> {
  // 改變基金代碼
  handleChangeFundCode = (e: React.ChangeEvent<HTMLInputElement>) => {
    const fundCode = e.target.value
    this.props.onChange({
      fundCode
    })

  }  
  render() {
      //...
    );
  }
}

這個例子展示如何聲明class組件:

React.Component<ComputeProps, Object>

語法雖然看起來很怪,但是這就是TypeScript中的泛型,以前有過C#或者Java經驗的應該很好理解。

其中,第一個參數定義Props的類型,第二個參數定義State的類型。

而react的事件參數類型應該如下定義:

React.ChangeEvent<HTMLInputElement>

這裏同樣使用了泛型,上面表示Input的Change事件類型。

而組件的Prop上有函數類型的定義,這裏就不單獨列出來了。

這幾個例子算是比較典型的TypeScript與React結合的例子。

處理window上的變量

使用寫在window上的全局變量會提示window上不存在這個屬性。

為了處理這點,可以在declaration.d.ts這個文件中定義變量:

// 定義window變量
interface Window{
  r:string[]
}

其中r是變量名。

總結

本來還想再多寫幾個示例的,但是Dota2版本更新了,導致我不想繼續寫下去了,以後如果有時間再更新常用的示例吧。

本篇文章只專註於在React舊項目中安裝並集成TypeScript,盡可能做到不涉及TypeScript的具體語法與介紹,因為介紹這些東西就不是一篇博客能搞定的了。

文章如有疏漏還請指正,希望能幫助到在TypeScript面前遲疑的你。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR 掌控什麼技術要點? 帶您認識其相關發展及效能

※高價3c回收,收購空拍機,收購鏡頭,收購 MACBOOK-更多收購平台討論專區

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※收購3c瘋!各款手機、筆電、相機、平板,歡迎來詢價!

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選