程序員修神之路–kubernetes是微服務發展的必然產物


菜菜哥,我昨天又請假出去面試了


戰況如何呀?


多數面試題回答的還行,但是最後讓我介紹微服務和kubernetes的時候,掛了


話說微服務和kubernetes內容確實挺多的


那你給我大體介紹一下唄


可以呀,不過要請和coffee哦


◆◆
kubernetes介紹
◆◆

在很多項目的發展初期,都是小型或者大型的單體項目,部署在單台或者多台服務器上,以單個進程的方式來運行。這些項目隨着需求的遞增,發布周期逐漸增長,迭代速度明顯下降。傳統的發布方式是:開發人員將項目打包發給運維人員,運維人員進行部署、資源分配等操作。

隨着軟件行業架構方式的改變,這些大型的單體應用按照業務或者其他維度逐漸被分解為可獨立運行的組件,我們稱之為微服務。微服務彼此之間被獨立開發、部署、升級、擴容,真正實現了大型應用的解耦工作。關於微服務的介紹,大家可以去擼一下菜菜之前的文章:

https://mp.weixin.qq.com/s/b7Bd8giwWVNF1CtkaDaVpw

https://mp.weixin.qq.com/s/BixgyGFrlwZ7wpgDdrmU_g

軟件開發行業就是這樣奇葩,每一個問題被解決之後總是伴隨着另外的問題出現,就像程序員改bug,為什麼總有改不完的bug,真的很令人頭大!!!

微服務雖然解決了一些問題,但是隨着微服務數量的增多,配置、管理、擴容、高可用等要求的實現變的越來越困難,包括運維團隊如何更好的利用硬件資源並降低服務器成本,以及部署的自動化和故障處理等問題變得原來越棘手。

以上問題正是kubernetes要解決並且擅長的領域,它可以讓開發者自主部署應用,自主控制迭代的頻率,完全解放運維團隊。而運維團隊的工作重心從以往的服務器資源管理轉移到了kubernetes的資源管理。kubernetes最厲害之處是對硬件基礎設施進行了封裝和抽象,使得開發人員完全不用去了解硬件的基礎原理,不用去關注底層服務器。kubernetes內部把設置的服務器抽象為資源池,在部署應用的時候,它會自動給應用分配合適合理的服務器資源,並且能夠保證這些應用能正常的和其他應用進行通信。一個kubernetes集群的大體結構如下:

那kubernetes有哪些具體優勢呢?能說下不?


再加一杯coffee?


◆◆
kubernetes優勢
◆◆

微服務雖好,但是數量多了就會有量帶來的問題。隨着系統組件的不斷增長,這些組件的管理問題逐漸浮出水面。首先我們要明白kubernetes是一個軟件系統,它依賴於linux容器的特性來管理組件(kubernetes和容器並非一個概念,請不要混淆)。通過kubernetes部署應用程序時候,你的集群無論包含多少個節點,對於kubernetes來說不會有什麼差異,這完全得益於它對底層基礎設置的抽象,使得數個節點運行的時候表現的好像一個節點一樣。

自動擴容

在kubernetes系統中,它可以對每個應用進行實時的監控,並能根據策略來應對突發的流量做出反應。例如:在流量高峰期間,kubernetes可以根據各個節點的資源利用情況,進行自動的增加節點或者減少節點操作,這在以前的傳統應用部署方式中是不容易做到的。

簡化部署流程

以往的傳統應用發布的時候,需要開發人員把項目打包,並檢查項目的配置文件是否正確,然後發給運維人員,運維人員然後把線上的應用版本備份,然後停止服務進行更新。在kubernetes中,我們多數情況下只需要一條指令或者點擊一個按鈕,就可以把應用升級到最新版本,而且升級的過程中還可做做到不間斷服務。當然整個的流程還涉及到容器的操作,本次這裏不再做過多介紹。

但是這裡有一個意外情況,如果kubernetes集群中存在不同架構CPU的服務器,而你的應用程序是針對特定CPU架構的軟件,可能需要在kubernetes中指定節點去運行你的應用程

提高服務器資源的利用率

傳統應用部署的時候,多數情況下總會把資源留有一定的比例來作為資源的緩衝,來應對流量的峰值,很少有人把單個服務器資源利用率提高到90%以上,從服務器故障的概率來說,服務器資源使用率在90%要比50%高很多,而且服務器一旦出現故障,都是運維人員來解決問題和背鍋,所以傳統的物理機或者虛擬機部署應用的方式,硬件的資源利用率相比較來說是比較低的。

而kubernetes對集群的管理由於抽象了底層硬件設施,所以已經將應用程序和基礎設施分離開來。當你告訴kubernetes運行你 應用程序時,它會根據程序的資源需求和集群內每隔節點的可用資源情況選擇合適的節點來運行。而且通過容器的技術,可以讓應用程序在任何時間遷移到集群中的任何機器上。而對於服務器選擇的最優的組合,kubernetes比人工做的更好,它會根據集群中每台服務器的負載情況來把硬件利用率提高到最高。

自動修復

在傳統的應用架構中,如果一台服務器發生故障,那麼這台服務器上的應用將會全部down掉,多數情況下需要運維人員去處理,這也是為什麼運維人員需要7*24小時隨時待命的一個重要原因。相信你也曾看到過因為半夜故障運維人員罵娘的情景。在kubernetes中,它監視並管理着所有的節點和應用,在節點出現故障的時候,kubernetes可以自動將該節點上的應用遷移到其他健康節點,並將故障節點在資源池中排除。如果你的kubernetes集群基礎設施有足夠的備用資源來支撐系統的正常運行,運維人員完全可以拖延到正常的工作時間再處理故障,讓程序員和運維人員過一下965的工作節奏。

這點有點像Actor模型的設計理論,提倡的是任其崩潰原理。

一致的運行環境

無論你是開發還是運維人員,在傳統的部署方案中,總會有運行環境差異性的煩惱,這樣的差異性大到每個服務器的差異,小到開發環境、仿真環境、生產環境,而且每個環境的服務器都會隨着時間的推移而變化。我相信你一定遇到過開發環境程序運行正常,生產環境卻異常的情況。這種差異性不僅僅是因為生產環境由運維團隊管理,開發環境由開發者管理,更重要的這兩組人對系統的要求是不同的,運維團隊會對線上生產環境定時的打補丁,做安全監測等操作,而開發者可能根本就不會弔這些問題。除此之外,應用系統依賴的第三方庫可能在開發、仿真、生產環境中版本不同,這樣的問題反正我是遇到過。

而kubernetes採用的容器技術,在把應用打包的時候,運行環境也一起被打入包中,這就保證了相同版本的容器包(鏡像)在任何服務器上都有相同的運行環境

kubernetes原來有這麼優勢,那我得好好學學了


雖然kubernetes優勢很多,但是入門門檻比較高,而且在個別情況下反而不合適


kubernetes要求開發人員對容器技術和網絡知識有一定了解,所以是否採用kubernetes要根據團隊的綜合技能和項目斟酌使用,並不是所有項目採用kubernetes都有利


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

使用Amazon EMR和Apache Hudi在S3上插入,更新,刪除數據

將數據存儲在Amazon S3中可帶來很多好處,包括規模、可靠性、成本效率等方面。最重要的是,你可以利用Amazon EMR中的Apache Spark,Hive和Presto之類的開源工具來處理和分析數據。 儘管這些工具功能強大,但是在處理需要進行增量數據處理以及記錄級別插入,更新和刪除場景時,仍然非常具有挑戰。

與客戶交談時,我們發現有些場景需要處理對單條記錄的增量更新,例如:

  • 遵守數據隱私法規,在該法規中,用戶選擇忘記或更改應用程序對數據使用方式的協議。
  • 使用流數據,當你必須要處理特定的數據插入和更新事件時。
  • 實現變更數據捕獲(CDC)架構來跟蹤和提取企業數據倉庫或運營數據存儲中的數據庫變更日誌。
  • 恢復遲到的數據,或分析特定時間點的數據。

從今天開始,EMR 5.28.0版包含Apache Hudi(孵化中),因此你不再需要構建自定義解決方案來執行記錄級別的插入,更新和刪除操作。Hudi是Uber於2016年開始開發,以解決攝取和ETL管道效率低下的問題。最近幾個月,EMR團隊與Apache Hudi社區緊密合作,提供了一些補丁,包括將Hudi更新為Spark 2.4.4,支持Spark Avro,增加了對AWS Glue Data Catalog的支持,以及多個缺陷修復。

使用Hudi,即可以在S3上執行記錄級別的插入,更新和刪除,從而使你能夠遵守數據隱私法律、消費實時流、捕獲更新的數據、恢復遲到的數據和以開放的、供應商無關的格式跟蹤歷史記錄和回滾。 創建數據集和表,然後Hudi管理底層數據格式。Hudi使用Apache Parquet和Apache Avro進行數據存儲,並內置集成Spark,Hive和Presto,使你能夠使用與現在所使用的相同工具來查詢Hudi數據集,並且幾乎實時地訪問新數據。

啟動EMR群集時,只要選擇以下組件之一(Hive,Spark,Presto),就可以自動安裝和配置Hudi的庫和工具。你可以使用Spark創建新的Hudi數據集,以及插入,更新和刪除數據。每個Hudi數據集都會在集群的已配置元存儲庫(包括AWS Glue Data Catalog)中進行註冊,並显示為可以通過Spark,Hive和Presto查詢的表。

Hudi支持兩種存儲類型,這些存儲類型定義了如何寫入,索引和從S3讀取數據:

  • 寫時複製(Copy On Write)– 數據以列格式(Parquet)存儲,並且在寫入時更新數據數據會創建新版本文件。此存儲類型最適合用於讀取繁重的工作負載,因為數據集的最新版本在高效的列式文件中始終可用。

  • 讀時合併(Merge On Read)– 將組合列(Parquet)格式和基於行(Avro)格式來存儲數據; 更新記錄至基於行的增量文件中,並在以後進行壓縮,以創建列式文件的新版本。 此存儲類型最適合於繁重的寫工作負載,因為新提交(commit)會以增量文件格式快速寫入,但是要讀取數據集,則需要將壓縮的列文件與增量文件合併。

下面讓我們快速預覽下如何在EMR集群中設置和使用Hudi數據集。

結合Apache Hudi與Amazon EMR

從EMR控制台開始創建集群。在高級選項中,選擇EMR版本5.28.0(第一個包括Hudi的版本)和以下應用程序:Spark,Hive和Tez。在硬件選項中,添加了3個任務節點,以確保有足夠的能力運行Spark和Hive。

群集就緒后,使用在安全性選項中選擇的密鑰對,通過SSH進入主節點並訪問Spark Shell。 使用以下命令來啟動Spark Shell以將其與Hudi一起使用:

$ spark-shell --conf "spark.serializer=org.apache.spark.serializer.KryoSerializer"
              --conf "spark.sql.hive.convertMetastoreParquet=false"
              --jars /usr/lib/hudi/hudi-spark-bundle.jar,/usr/lib/spark/external/lib/spark-avro.jar

使用以下Scala代碼將一些示例ELB日誌導入寫時複製存儲類型的Hudi數據集中:

import org.apache.spark.sql.SaveMode
import org.apache.spark.sql.functions._
import org.apache.hudi.DataSourceWriteOptions
import org.apache.hudi.config.HoodieWriteConfig
import org.apache.hudi.hive.MultiPartKeysValueExtractor

//Set up various input values as variables
val inputDataPath = "s3://athena-examples-us-west-2/elb/parquet/year=2015/month=1/day=1/"
val hudiTableName = "elb_logs_hudi_cow"
val hudiTablePath = "s3://MY-BUCKET/PATH/" + hudiTableName

// Set up our Hudi Data Source Options
val hudiOptions = Map[String,String](
    DataSourceWriteOptions.RECORDKEY_FIELD_OPT_KEY -> "request_ip",
    DataSourceWriteOptions.PARTITIONPATH_FIELD_OPT_KEY -> "request_verb", 
    HoodieWriteConfig.TABLE_NAME -> hudiTableName, 
    DataSourceWriteOptions.OPERATION_OPT_KEY ->
        DataSourceWriteOptions.INSERT_OPERATION_OPT_VAL, 
    DataSourceWriteOptions.PRECOMBINE_FIELD_OPT_KEY -> "request_timestamp", 
    DataSourceWriteOptions.HIVE_SYNC_ENABLED_OPT_KEY -> "true", 
    DataSourceWriteOptions.HIVE_TABLE_OPT_KEY -> hudiTableName, 
    DataSourceWriteOptions.HIVE_PARTITION_FIELDS_OPT_KEY -> "request_verb", 
    DataSourceWriteOptions.HIVE_ASSUME_DATE_PARTITION_OPT_KEY -> "false", 
    DataSourceWriteOptions.HIVE_PARTITION_EXTRACTOR_CLASS_OPT_KEY ->
        classOf[MultiPartKeysValueExtractor].getName)

// Read data from S3 and create a DataFrame with Partition and Record Key
val inputDF = spark.read.format("parquet").load(inputDataPath)

// Write data into the Hudi dataset
inputDF.write
       .format("org.apache.hudi")
       .options(hudiOptions)
       .mode(SaveMode.Overwrite)
       .save(hudiTablePath)

在Spark Shell中,現在就可以計算Hudi數據集中的記錄:

scala> inputDF2.count()
res1: Long = 10491958

在選項(options)中,使用了與為集群中的Hive Metastore集成,以便在默認數據庫(default)中創建表。 通過這種方式,我可以使用Hive查詢Hudi數據集中的數據:

hive> use default;
hive> select count(*) from elb_logs_hudi_cow;
...
OK
10491958

現在可以更新或刪除數據集中的單條記錄。 在Spark Shell中,設置了一些用來查詢更新記錄的變量,並準備用來選擇要更改的列的值的SQL語句:

val requestIpToUpdate = "243.80.62.181"
val sqlStatement = s"SELECT elb_name FROM elb_logs_hudi_cow WHERE request_ip = '$requestIpToUpdate'"

執行SQL語句以查看列的當前值:

scala> spark.sql(sqlStatement).show()
+------------+                                                                  
|    elb_name|
+------------+
|elb_demo_003|
+------------+

然後,選擇並更新記錄:

// Create a DataFrame with a single record and update column value
val updateDF = inputDF.filter(col("request_ip") === requestIpToUpdate)
                      .withColumn("elb_name", lit("elb_demo_001"))

現在用一種類似於創建Hudi數據集的語法來更新它。 但是這次寫入的DataFrame僅包含一條記錄:

// Write the DataFrame as an update to existing Hudi dataset
updateDF.write
        .format("org.apache.hudi")
        .options(hudiOptions)
        .option(DataSourceWriteOptions.OPERATION_OPT_KEY,
                DataSourceWriteOptions.UPSERT_OPERATION_OPT_VAL)
        .mode(SaveMode.Append)
        .save(hudiTablePath)

在Spark Shell中,檢查更新的結果:

scala> spark.sql(sqlStatement).show()
+------------+                                                                  
|    elb_name|
+------------+
|elb_demo_001|
+------------+

現在想刪除相同的記錄。要刪除它,可在寫選項中傳入了EmptyHoodieRecordPayload有效負載:

// Write the DataFrame with an EmptyHoodieRecordPayload for deleting a record
updateDF.write
        .format("org.apache.hudi")
        .options(hudiOptions)
        .option(DataSourceWriteOptions.OPERATION_OPT_KEY,
                DataSourceWriteOptions.UPSERT_OPERATION_OPT_VAL)
        .option(DataSourceWriteOptions.PAYLOAD_CLASS_OPT_KEY,
                "org.apache.hudi.EmptyHoodieRecordPayload")
        .mode(SaveMode.Append)
        .save(hudiTablePath)

在Spark Shell中,可以看到該記錄不再可用:

scala> spark.sql(sqlStatement).show()
+--------+                                                                      
|elb_name|
+--------+
+--------+

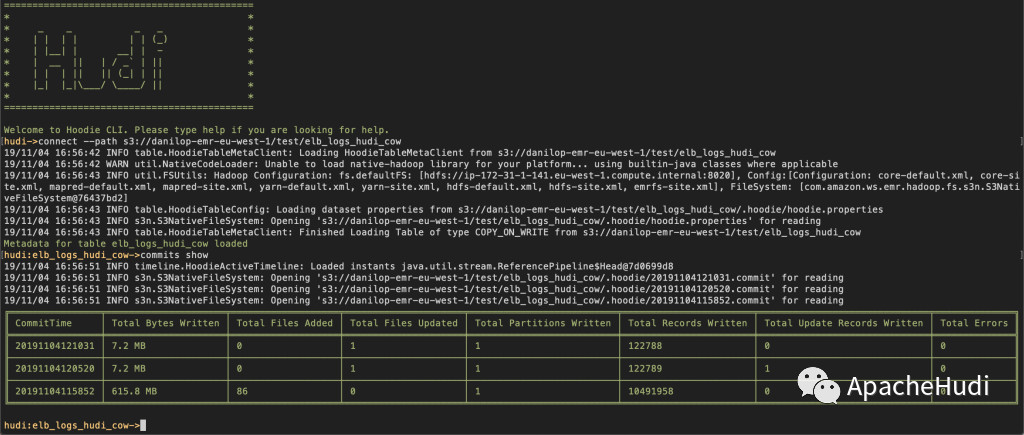
Hudi是如何管理所有的更新和刪除? 我們可以通過Hudi命令行界面(CLI)連接到數據集,便可以看到這些更改被解釋為提交(commits):

可以看到,此數據集是寫時複製數據集,這意味着每次對記錄進行更新時,包含該記錄的文件將被重寫以包含更新后的值。 你可以查看每次提交(commit)寫入了多少記錄。表格的底行描述了數據集的初始創建,上方是單條記錄更新,頂部是單條記錄刪除。

使用Hudi,你可以回滾到每個提交。 例如,可以使用以下方法回滾刪除操作:

hudi:elb_logs_hudi_cow->commit rollback --commit 20191104121031

在Spark Shell中,記錄現在回退到更新之後的位置:

scala> spark.sql(sqlStatement).show()
+------------+                                                                  
|    elb_name|
+------------+
|elb_demo_001|
+------------+

寫入時複製是默認存儲類型。 通過將其添加到我們的hudiOptions中,我們可以重複上述步驟來創建和更新讀時合併數據集類型:

DataSourceWriteOptions.STORAGE_TYPE_OPT_KEY -> "MERGE_ON_READ"

如果更新讀時合併數據集並使用Hudi CLI查看提交(commit)時,則可以看到讀時合併與寫時複製相比有何不同。使用讀時合併,你僅寫入更新的行,而不像寫時複製一樣寫入整個文件。這就是為什麼讀時合併對於需要更多寫入或使用較少讀取次數更新或刪除繁重工作負載的用例很有幫助的原因。增量提交作為Avro記錄(基於行的存儲)寫入磁盤,而壓縮數據作為Parquet文件(列存儲)寫入。為避免創建過多的增量文件,Hudi會自動壓縮數據集,以便使得讀取盡可能地高效。

創建讀時合併數據集時,將創建兩個Hive表:

  • 第一個表的名稱與數據集的名稱相同。
  • 第二個表的名稱後面附加了字符_rt; _rt後綴表示實時。

查詢時,第一個表返回已壓縮的數據,並不會显示最新的增量提交。使用此表可提供最佳性能,但會忽略最新數據。查詢實時表會將壓縮的數據與讀取時的增量提交合併,因此該數據集稱為讀時合併。這將導致可以使用最新數據,但會導致性能開銷,並且性能不如查詢壓縮數據。這樣,數據工程師和分析人員可以靈活地在性能和數據新鮮度之間進行選擇。

已可用

EMR 5.28.0的所有地區現在都可以使用此新功能。將Hudi與EMR結合使用無需額外費用。你可以在EMR文檔中了解更多有關Hudi的信息。 這個新工具可以簡化你在S3中處理,更新和刪除數據的方式。也讓我們知道你打算將其用於哪些場景!

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

你必須知道的容器日誌 (2) 開源日誌管理方案 ELK/EFK

本篇已加入《》,可以點擊查看更多容器化技術相關係列文章。上一篇《》中介紹了Docker自帶的logs子命令以及其Logging driver,本篇將會介紹一個流行的開源日誌管理方案ELK。

一、關於ELK

1.1 ELK簡介

  ELK 是Elastic公司提供的一套完整的日誌收集以及展示的解決方案,是三個產品的首字母縮寫,分別是ElasticSearch、Logstash 和 Kibana。

  • Elasticsearch是實時全文搜索和分析引擎,提供搜集、分析、存儲數據三大功能
  • Logstash是一個用來搜集、分析、過濾日誌的工具
  • Kibana是一個基於Web的圖形界面,用於搜索、分析和可視化存儲在 Elasticsearch指標中的日誌數據   

1.2 ELK日誌處理流程

   上圖展示了在Docker環境下,一個典型的ELK方案下的日誌收集處理流程:

  • Logstash從各個Docker容器中提取日誌信息
  • Logstash將日誌轉發到ElasticSearch進行索引和保存
  • Kibana負責分析和可視化日誌信息

  由於Logstash在數據收集上並不出色,而且作為Agent,其性能並不達標。基於此,Elastic發布了beats系列輕量級採集組件。

  這裏我們要實踐的Beat組件是Filebeat,Filebeat是構建於beats之上的,應用於日誌收集場景的實現,用來替代 Logstash Forwarder 的下一代 Logstash 收集器,是為了更快速穩定輕量低耗地進行收集工作,它可以很方便地與 Logstash 還有直接與 Elasticsearch 進行對接。

  本次實驗直接使用Filebeat作為Agent,它會收集我們在第一篇《》中介紹的json-file的log文件中的記錄變動,並直接將日誌發給ElasticSearch進行索引和保存,其處理流程變為下圖,你也可以認為它可以稱作 EFK。

二、ELK套件的安裝

  本次實驗我們採用Docker方式部署一個最小規模的ELK運行環境,當然,實際環境中我們或許需要考慮高可用和負載均衡。

  首先拉取一下sebp/elk這個集成鏡像,這裏選擇的tag版本是640(最新版本已經是7XX了):

docker pull sebp/elk:640

  注:由於其包含了整個ELK方案,所以需要耐心等待一會。

  通過以下命令使用sebp/elk這個集成鏡像啟動運行ELK:

docker run -it -d --name elk \
    -p 5601:5601 \
    -p 9200:9200 \
    -p 5044:5044 \
    sebp/elk:640

  運行完成之後就可以先訪問一下 http://[Your-HostIP]:5601 看看Kibana的效果:  

  Kibana管理界面

Kibana Index Patterns界面

  當然,目前沒有任何可以显示的ES的索引和數據,再訪問一下http://[Your-HostIP]:9200 看看ElasticSearch的API接口是否可用:

ElasticSearch API

  Note:如果啟動過程中發現一些錯誤,導致ELK容器無法啟動,可以參考《》及《》一文。如果你的主機內存低於4G,建議增加配置設置ES內存使用大小,以免啟動不了。例如下面增加的配置,限制ES內存使用最大為1G:

docker run -it -d --name elk \
    -p 5601:5601 \
    -p 9200:9200 \
    -p 5044:5044 \
  -e ES_MIN_MEM=512m \ -e ES_MAX_MEM=1024m \ sebp/elk:640

三、Filebeat配置

3.1 安裝Filebeat

  這裏我們通過rpm的方式下載Filebeat,注意這裏下載和我們ELK對應的版本(ELK是6.4.0,這裏也是下載6.4.0,避免出現錯誤):

wget https://artifacts.elastic.co/downloads/beats/filebeat/filebeat-6.4.0-x86_64.rpm
rpm -ivh filebeat-6.4.0-x86_64.rpm

3.2 配置Filebeat  

   這裏我們需要告訴Filebeat要監控哪些日誌文件 及 將日誌發送到哪裡去,因此我們需要修改一下Filebeat的配置:

cd /etc/filebeat
vim filebeat.yml

  要修改的內容為:

  (1)監控哪些日誌?

filebeat.inputs:

# Each - is an input. Most options can be set at the input level, so
# you can use different inputs for various configurations.
# Below are the input specific configurations.

- type: log

  # Change to true to enable this input configuration.
  enabled: true

  # Paths that should be crawled and fetched. Glob based paths.
  paths:
    - /var/lib/docker/containers/*/*.log - /var/log/syslog

  這裏指定paths:/var/lib/docker/containers/*/*.log,另外需要注意的是將 enabled 設為 true。

  (2)將日誌發到哪裡?

#-------------------------- Elasticsearch output ------------------------------
output.elasticsearch:
  # Array of hosts to connect to.
  hosts: ["192.168.16.190:9200"]

  # Optional protocol and basic auth credentials.
  #protocol: "https"
  #username: "elastic"
  #password: "changeme"

  這裏指定直接發送到ElasticSearch,配置一下ES的接口地址即可。

  Note:如果要發到Logstash,請使用後面這段配置,將其取消註釋進行相關配置即可:

#----------------------------- Logstash output --------------------------------
#output.logstash:
  # The Logstash hosts
  #hosts: ["localhost:5044"]

  # Optional SSL. By default is off.
  # List of root certificates for HTTPS server verifications
  #ssl.certificate_authorities: ["/etc/pki/root/ca.pem"]

  # Certificate for SSL client authentication
  #ssl.certificate: "/etc/pki/client/cert.pem"

  # Client Certificate Key
  #ssl.key: "/etc/pki/client/cert.key"

3.3 啟動Filebeat

  由於Filebeat在安裝時已經註冊為systemd的服務,所以只需要直接啟動即可:

systemctl start filebeat.service

  檢查Filebeat啟動狀態:

systemctl status filebeat.service

3.4 驗證Filebeat

  通過訪問ElasticSearch API可以發現以下變化:ES建立了以filebeat-開頭的索引,我們還能夠看到其來源及具體的message。

四、Kibana配置

  接下來我們就要告訴Kibana,要查詢和分析ElasticSearch中的哪些日誌,因此需要配置一個Index Pattern。從Filebeat中我們知道Index是filebeat-timestamp這種格式,因此這裏我們定義Index Pattern為 filebeat-*

  點擊Next Step,這裏我們選擇Time Filter field name為@timestamp:

  單擊Create index pattern按鈕,即可完成配置。

  這時我們單擊Kibana左側的Discover菜單,即可看到容器的日誌信息啦:

  仔細看看細節,我們關注一下message字段:

  可以看到,我們重點要關注的是message,因此我們也可以篩選一下只看這個字段的信息:

  此外,Kibana還提供了搜索關鍵詞的日誌功能,例如這裏我關注一下日誌中包含unhandled exception(未處理異常)的日誌信息:

  這裏只是樸素的展示了導入ELK的日誌信息,實際上ELK還有很多很豐富的玩法,例如分析聚合、炫酷Dashboard等等。筆者在這裏也是初步使用,就介紹到這裏啦。

五、Fluentd引入

5.1 關於Fluentd

  前面我們採用的是Filebeat收集Docker的日誌信息,基於Docker默認的json-file這個logging driver,這裏我們改用Fluentd這個開源項目來替換json-file收集容器的日誌。

  Fluentd是一個開源的數據收集器,專為處理數據流設計,使用JSON作為數據格式。它採用了插件式的架構,具有高可擴展性高可用性,同時還實現了高可靠的信息轉發。Fluentd也是雲原生基金會 (CNCF) 的成員項目之一,遵循Apache 2 License協議,其github地址為:。Fluentd與Logstash相比,比佔用內存更少、社區更活躍,兩者的對比可以參考這篇文章《》。

  因此,整個日誌收集與處理流程變為下圖,我們用 Filebeat 將 Fluentd 收集到的日誌轉發給 Elasticsearch。

   當然,我們也可以使用Fluentd的插件(fluent-plugin-elasticsearch)直接將日誌發送給 Elasticsearch,可以根據自己的需要替換掉Filebeat,從而形成Fluentd => ElasticSearch => Kibana 的架構,也稱作EFK。

5.2 運行Fluentd

  這裏我們通過容器來運行一個Fluentd採集器:

docker run -d -p 24224:24224 -p 24224:24224/udp -v /edc/fluentd/log:/fluentd/log fluent/fluentd

  默認Fluentd會使用24224端口,其日誌會收集在我們映射的路徑下。

  此外,我們還需要修改Filebeat的配置文件,將/edc/fluentd/log加入監控目錄下:

#=========================== Filebeat inputs =============================

filebeat.inputs:

# Each - is an input. Most options can be set at the input level, so
# you can use different inputs for various configurations.
# Below are the input specific configurations.

- type: log

  # Change to true to enable this input configuration.
  enabled: true

  # Paths that should be crawled and fetched. Glob based paths.
  paths:
    - /edc/fluentd/log/*.log

  添加監控配置之後,需要重新restart一下filebeat:

systemctl restart filebeat

5.3 運行測試容器

  為了驗證效果,這裏我們Run兩個容器,並分別制定其log-dirver為fluentd:

docker run -d \
           --log-driver=fluentd \
           --log-opt fluentd-address=localhost:24224 \
           --log-opt tag="test-docker-A" \
           busybox sh -c 'while true; do echo "This is a log message from container A"; sleep 10; done;'

docker run -d \
           --log-driver=fluentd \
           --log-opt fluentd-address=localhost:24224 \
           --log-opt tag="test-docker-B" \
           busybox sh -c 'while true; do echo "This is a log message from container B"; sleep 10; done;'

  這裏通過指定容器的log-driver,以及為每個容器設立了tag,方便我們後面驗證查看日誌。

5.4 驗證EFK效果

  這時再次進入Kibana中查看日誌信息,便可以通過剛剛設置的tag信息篩選到剛剛添加的容器的日誌信息了:

六、小結

  本文從ELK的基本組成入手,介紹了ELK的基本處理流程,以及從0開始搭建了一個ELK環境,演示了基於Filebeat收集容器日誌信息的案例。然後,通過引入Fluentd這個開源數據收集器,演示了如何基於EFK的日誌收集案例。當然,ELK/EFK有很多的知識點,筆者也還只是初步使用,希望未來能夠分享更多的實踐總結。

參考資料

CloudMan,《》

一杯甜酒,《》

於老三,《》

zpei0411,《》

曹林華,《》


作者:

出處:

本文版權歸作者和博客園共有,歡迎轉載,但未經作者同意必須保留此段聲明,且在文章頁面明顯位置給出原文鏈接。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

RALM: 實時 Look-alike 算法在微信看一看中的應用

嘉賓:劉雨丹 騰訊 高級研究員

整理:Jane Zhang

來源:DataFunTalk

出品:DataFun

注:歡迎關注DataFunTalk同名公眾號,收看第一手原創技術文章。

導讀:本次分享是微信看一看團隊在 KDD2019 上發表的一篇論文。長尾問題是推薦系統中的經典問題,但現今流行的點擊率預估方法無法從根本上解決這個問題。文章在 look-alike 方法基礎上,針對微信看一看的應用場景設計了一套實時 look-alike 框架,在解決長尾問題的同時也滿足了資訊推薦的高時效性要求。

▌背景

微信大家可能都用過,微信中的“看一看”是 feed 推薦流的形式,涵蓋了騰訊整個生態鏈的內容分發平台,包括騰訊新聞、公眾號文章、騰訊視頻等。每天總分發量在千萬級以上,面對如此大的分發量,要滿足不同興趣偏好的用戶需求,使用傳統的方法時遇到了一些問題。我們針對發現的問題做了優化和改進,接下來分享下我們優化的過程。

▌未緩解的馬太效應

馬太效應,簡單解釋,在內容的生態系統中,自然分髮狀態會造成一種現象:頭部10%的內容佔據了系統90%的流量、曝光量or點擊量,剩下90%的內容,集中在長尾的10%里。這對於內容的生產方、內容系統的生態和使用系統的用戶來說,都是不健康的狀態。造成這種現象的原因,是因為系統分發能力不夠強,無法處理信息過載的現象,推薦系統設計的初衷就是為了解決馬太效應問題。

回顧推薦系統的發展,從最開始的規則匹配 -> 協同過濾 -> 線性模型 -> deep learning,逐步緩解了馬太效應現象,但沒有完全解決。

造成這個現象的原因是傳統模型、CTR 預估和 deep model,都對部分特徵有依賴,沒有把特徵完全發掘出來,導致模型推薦結果是趨熱的,使生態系統內優質長尾內容投放依然困難。因為 CTR model 最終趨向於行為特徵,或者后驗結果較好的數據,對於優質長尾內容,如小眾興趣的音樂、電影、深度報道的新聞專題等,獲得的相應曝光依舊困難,處於馬太效應 long tail 90%的部分,這會影響推薦系統的生態,導致推薦系統內容越來越窄。

▌為什麼無法準確投放長尾?

怎樣解決這個問題?這個問題歸根結底是對內容的建模不夠完整。我們嘗試分析下問題出在哪:

先看下推薦系統建模流程。首先得到原始樣本,這是業務下的訓練數據,形式是三元組:userid,itemid 和 label。如果是 timeline 的樣本,那就是點擊或者不點擊。原始樣本中,一條樣本可以完整表示一個用戶在某個時間點對一個 item 產生了一次行為,把這個三元組當作信息的最完整形式。對於這個完整形式,直接建模很簡單,如傳統的 item CF,或者協同過濾。協同過濾是最初級的方法,直接對 uid,itemid,label 做擬合,因為可以完全利用初始樣本的信息,擬合的準確性非常好。弱點也很明顯,對原始樣本中沒有包含的 userid 或者 itemid,沒有泛化推理能力,後續新曝光的 user 和 item 是無法處理的。這個問題,就是我們要做的第二步驟,對原始樣本做抽象。既然無法獲取所有的 userid 和 itemid,那就要對 user 或者 item 做一層抽象,如 user 抽象成基礎畫像:年齡、性別或所處地域;item 抽象成語義特徵:topic、tag 等;item 歷史行為特徵,簡單做統計:過去一段時間的點擊率、曝光率、曝光次數。最後基於泛化過的特徵做擬合,得到最終模型。

問題出在哪?做原始特徵抽象,抽象意味着發生了信息損失,這部分信息損失導致模型擬合時走向了比較偏的道路。舉個簡單的例子:同一個 item,有相同的 topic tag,歷史點擊率和歷史曝光次數和點擊次數也相同,可以說這兩個 item 是相同的嗎?顯然有可能是不同的。使用統計特徵無法完整表達,同樣的 item 點擊都是0.5,PV 都是1000 or 2000。有些 item 被這群用戶看過,有些 item 被那群用戶看過。儘管語義特徵和行為特徵都相同,但兩群 user 不同,Item 的受眾也不同。這裏說的抽象的方式,是不完整的 item 行為建模,也是對 item 歷史行為不完整的刻畫,這就導致了整個 model,對 item 后驗數據十分依賴,導致推薦結果趨向於 CTR 表現好或者 PV 表現好的 item。最終后驗數據表現好的數據又會更進一步被模型推薦且曝光,這樣會造成惡性循環:一方面,加劇了頭部效應的影響,使模型陷入局部最優;另一方面,整個推薦系統邊界效應收窄,用戶趨向於看之前表現好的數據,很少看到能拓寬推薦系統邊界或者用戶視野的長尾數據。

▌Look-alike 模型

問題就是這樣產生的, 可以思考一下,問題的本質是什麼?就是因為模型無法對 item 行為完整建模,這一步信息損失太大,怎麼解決這個問題呢?我們首先想到了一種方案:look-alike。

這是廣告領域的經典方案,這類模型的方法也很簡單,首先可以有一個候選集合的 item,我們要推這部分 item,怎麼推呢?第一個步驟:找到歷史上已知的、廣告主提供的對 item 表達過興趣的用戶,這部分用戶稱為種子用戶。然後使用用戶相似度法方法,找到和種子用戶最相似的目標人群,稱為目標用戶,把這部分 item 直接推給目標用戶。這個方法在廣告系統中,是用來做定向投放的,效果很好。為什麼呢?我們來看下模型的整體思路。

把相關的 item 找到對它發生過歷史行為的種子用戶,直接用種子用戶的特徵,作為模型的輸入,這是正樣本;從全局用戶中負採樣一部分用戶作為負樣本。用歷史行為的用戶的特徵來學習 item 的歷史行為,相當於把不同用戶看過的 item 區分開,其實是對 item 的歷史行為特徵的完整建模。之前提到,行為樣本是信息量最大的樣本,它們沒有經過抽象,如果能完整的用受眾用戶的行為來計算 item 的特徵,可以說是最完整的 item 歷史特徵的建模。

Look-alike 在廣告領域的應用已經很完善,也有很多方式。可以把 look-alike 相關的研究分成兩個方向:第一種是基於相似度的 look-alike,這種 look-alike 比較簡單,大體思路是把所有用戶做 user embedding,映射到低維的向量中,對它做基於 k-means 或者局部敏感 hash 做聚類,根據當前用戶屬於哪個聚類,把這個種子用戶的類感興趣的內容推給目標用戶。這種方法的特點:性能強。因為簡單,只需要找簇中心,或者向量相似度的計算,因為簡單、性能好,模型準確性低。

第二種是和第一種相反的,基於回歸。包括 LR,或者樹模型,或者 DNN or deep model 的方法,主要思路是直接建模種子用戶的特徵。把種子用戶當做模型的正樣本, 針對每個 item 訓練一個回歸模型,做二分類,得出種子用戶的特徵規律。這種方法的優點是:準確性高,因為會針對每個 item 建模。缺點也明顯:訓練開銷大,針對每個 item 都要單獨訓練一個模型。對於廣告來說,可以接受,因為廣告的候選集沒有那麼大,更新頻率也沒那麼高。

但是對於我們的推薦場景,有一些問題:1. 對內容時效性要求高,如推薦的新聞專題,必須在5分鐘或10分鐘內要觸達用戶;2. 候選集更新頻率高,我們每天的候選集上千萬,每分鐘、每一秒都有新內容,如果新內容無法進入推薦池,會影響推薦效果。

▌核心需求

在我們的場景下,如果還用廣告領域的經典的 look-alike,是無法解決的。如果要對每個候選集建模,採用 regression-base 的方法,如每分鐘都要對新加進來的候選集做建模,包括積累種子用戶、做負採樣、訓練,等模型收斂后離線預測 target user 的相似分,這對於線上的時效性是不能接受的。

對於 similarity base 的方法,它的問題是計算過於簡單,如果直接和 CTR 模型 PK,核心指標會下降,得出來的結論是:傳統的 look-alike 不能直接照搬到我們的系統中。

針對我們的需求,我們整理出來了應該滿足的3點核心需求:

  1. 實時。新 item 分發不需要重新訓練模型,要能實時完成種子用戶的擴展;

  2. 高效。因為線上加到 rank 模型 CTR 的後面, 要保持模型核心指標 CTR 的前提下,再去加強長尾內容分發,這樣模型才有意義。要學習準確性和多樣性的用戶表達方式。

  3. 快速。Look-alike 模型要部署到線上,實時預測種子用戶和目標用戶群體的相似度,要滿足線上實時計算的耗時性能要求,也要精簡模型預測的計算次數。

▌RALM:Real-time Attention based Look-alike Model

基於這三個核心需求,我們提出了一個新的方法,全稱是 real-time attention based look-alike model,簡稱 RALM。我先簡單講下 RALM 核心的三個點。

  1. 核心點

① 模型可總結為 user-users 的 model。回想下經典的 CTR 預估模型,是 user2item 的 point-wise 的處理流程建模。User、item、label,我們做的最大的變化,是借鑒了 look-alike 的思想,把 item 替換成種子用戶。用種子用戶的用戶特徵,代替 item 的行為特徵。所以模型從 user2item 的 model,變成 user2user 的 model。圖中右側是 target user,左側是 seeds。

② 完善的 seeds representation。用種子用戶代替 item 行為特徵。這樣面臨的問題是:怎樣更好地表達一個人群。這個 seeds representation,是我們研究中的核心步驟,要得到一個高效、自適應更新的種子用戶的表達方式。

③ real-time。最終目標是部署在線上,實時預測種子用戶群體相似度,需要是能夠實現 real-time 的框架。

上述是模型表達的思路。I 是一個 item,把 item 用 seeds 的 embedding 的集合來表示,seeds embedding,是組成這個種子用戶的每個用戶的 embedding 的函數。學習了 seeds representation,就是這個函數 f。

  1. 整體結構

接下來看下離線訓練部分,這是離線訓練的整體結構。

模型離線訓練分成兩個階段:右側 user representation learning, 左側第二階段是 look alike learning。user representation learning 模型結構,最後的目標是通過一個用戶在不同領域的行為,學習到用戶在所有領域的多樣性且兼顧準確性的用戶興趣的高階畫像。這個畫像在這個位置是低維特徵,向量特徵通過 user presentation learning 的目標學到了所有用戶的 embedding 之後,第二階段是 look alike learning。Look alike learning 模型,是一個 user to user 的 model,右側是目標用戶的特徵輸入,左側是種子用戶人群的 embedding 輸入,左邊種子用戶是一群用戶的 embedding 堆疊到一起,輸入其實是一個矩陣。這兩邊的輸入來源都是第一階段 representation learning 輸出的 embedding。Look alike 的目標是學習目標用戶和候選 item 種子用戶的相似度,最上面是學習兩次相似分的,最後完成種子用戶的擴展。

▌User Representation Learning

按順序來分析下,第一階段,是用戶的表示學習,user representation learning。

這個模型大家看着會比較眼熟,它是用 Youtube 的 representation model 中演化過來的。Youbute 的基礎模型很簡單,下面是用戶在不同領域的行為,下面的基礎特徵可能會有離散值,也可能是連續值。如果是離散值,可以通過 embedding lookup,再過一個 pooling,再和所有領域的特徵做 merge,上面過一個全連接,最後輸出 embedding。右側是感興趣的 item,也會做一些 embedding lookup,整個做 sce loss,或者是多分類。要預測的是:用戶在點擊了這麼多 item 之後,下一個要點擊的 item,最後要預測的就是表達用戶興趣的 embedding。這層 merge layer,最初 Youtube 的版本是用一個 concat。可以看到最初版模型在訓練時遇到了一個問題,最下層是用到了用戶很多個域 ( 每個 field 稱為一個域,可能是每個用戶在每個分佈下的行為,如電商購物下行為,或者是公眾號閱讀的行為 )。

訓練時看到一個現象,有些域的行為學的非常強,參數來看學的非常充分,某些 field 參數分佈不大,最後的權重值較小,對最終預估的分數沒有影響。這裡有兩個名詞:強關聯和弱關聯。最終預估結果關係比較大的 field、參數學習較強的,稱為強關聯特徵域;相反,學的不充分的、對最終結果影響小的,稱為弱關聯特徵域。對於強關聯和弱關聯,如果看到參數分佈是這樣的,是不是就表明弱關聯特徵不重要呢?並不是。舉例來說,representation learning 如果訓練目標是在“看一看”中的閱讀行為,對於某些經常使用微信公眾號、或者閱讀的用戶來說,他們在公眾號平台的閱讀歷史就是非常強的關聯特徵,能夠決定再看一看中的興趣。對於這些特徵來說,這些特徵是很強的,對於其他的如在電商中的購物或者是在搜索中的 query,這些是比較弱的,對看一看的影響很有限。再思考另一種 case,比如,看一看通過某種形式,吸引了很多新用戶。新用戶進來之後,沒有在公眾號平台的閱讀歷史,但是他們在購物或者搜索中有歷史行為,此時這些歷史行為會影響他下一次閱讀的文章,或者感興趣的 item。這些特徵對這些用戶來說是非常重要的。但目前,顯然這些用戶是沒有學到這些變化的。

排查了下模型訓練的過程,可以把結果集中在這一點上,就是這個 merge layer,其實是負責把用戶不同域的特徵 merge 到一起。Merge layer,可以看到右側的圖,原始的 deep model 用的是左側的實現方法,直接用 concat。Concat 的優點是,可以學到所有 field 的參數,缺點是,無法根據輸入的不同分佈,來調整權重值。也就是說,如果80%的用戶的閱讀歷史都是看一看的種子用戶,閱讀歷史都是很豐富的,就很有可能對所有用戶都把這個特徵學的很強。如果是少量用戶,就學不到了,少量用戶關注對其它特徵的啟發作用,concat layer 是學不到的。因為它對於大部分用戶來說,已經把參數學的非常重了,小部分用戶不足以對它產生影響。所以需要一個機制,針對不同用戶的特徵域的輸入動態調整 merge layer 的方式,我們想到的最好的辦法是 attention。Attention 是最近在 NLP 中非常火的,很多模型都會用到。為什麼要用 attetnion?

右下角的結構,就是 attention。我們用到的 attention 是把用戶的輸入的所有的域當做 attention 的 query,key 和 value 都是自身 field 的本身。這是一個典型的 self-attetnion,我們最後要做的是,讓模型根據用戶自己的輸入領域的情況,動態調整不同領域的融合方式,相對於之前的 concat 的方式來說,concat 其實是把所有領域的 field 強行放在同一個向量空間中來學習,自然會有學習不充分的情況。Self-attenion merge 是讓不同的域在自己的向量空間中學習充分,再通過不同的權重組合在一起。其實是相當於讓用戶能有屬於自己的表達,而不是被歷史豐富的用戶帶着走。這是一個優化,可以明顯改善強弱特徵、訓練不均衡的問題。

可以看一下這是我之前訓練的時候在某個特徵域用 tensorboard 打出來的參數分佈的情況,可以看到 attention merge layer 前後,訓練參數有很大變化,之前這些參數基本上都是0,之後會激活出一些值,這個是最後 user presentat learning 的值:precession、recall、auc。也可以看到模型加完 attention 之後,在 auc 和 loss 上都有所優化。

經過 user representation learning 之後,我們現在擁有了所有用戶的兼顧多樣性和準確性的 embedding 表達。接下來要做的是怎麼用 embedding 來表達種子用戶人群?

▌Look-alike learning

Look-alike 要做的第一步就是如何表達 seeds user。

一個種子用戶應該包含什麼信息,這裏我們做兩點假設:

  1. 每個用戶都有自己的興趣,但對整個群體的人群信息存在不同的貢獻度,我們稱為群體的共性信息:global info。共性信息和目標用戶無關,只和用戶群體自身有關。

  2. 種子用戶群體的個性信息。種子群體中一定存在一小部分用戶和 target 用戶興趣相似,這時,當 target 人群變化時,信息會變化,稱為 local info。

種子用戶的相對表達=個性信息+共性信息。怎樣學習 local info 和 global info 呢?我們想到的是用不同的 attention 機制,學習出兩個 embedding:local & global embedding,分別表示這兩種信息。對於 local embedding,是右上角的圖,稱為 local attention unit,這個 attention,是一個乘法開始,它的公式是把種子用戶的矩陣乘以 w,再乘以 target user 的 embedding,再做一層 softmax,再乘以種子用戶自己,這是一個典型的乘法 attention。它的作用是提取種子用戶群體中和 target user 相關的部分。捕獲種子用戶的 local info。

第二部分是 global info,用 global attention,只和 user 相關,和 attention merge 的方法類似,也是一個 self-attention。作用是把種子用戶乘以矩陣轉換,再乘以種子用戶自己,所做的就是捕捉用戶群體自身內部的興趣分佈。得到的這兩種 local & global embedding 之後,進行加權和,這就是種子用戶群體的全部信息。另一個問題來了,採用兩種 attention union 來捕獲信息,這意味着要計算很多次矩陣乘法,對線上開銷很大。兩個 embedding 需要多少次計算?這裡有個表達公式,這個 h 是 embedding 的維度,K 是種子用戶用戶的數量,總的計算次數 = h * h * K * 2。對於線上耗時,一次預測超過 1000ms,無法接受。

優化耗時,第一個方法是減少種子用戶的數量,這樣會影響種子用戶的表達完整性;另一種是我們線上採取的方式,使用聚類。找到種子用戶內部比較相似的,把它們聚在一起。這種方法:1. 減少 key 的數量,2. 保持種子用戶的全部信息。聚類的方式比較簡單,用的是 k-means。

簡單看下這個模型,右側是 target user embedding,經過全連接,左邊是 series user embedding 矩陣,兩邊都經過 embedding 之後,首先對種子用戶的 embedding 做聚類,得到 k 個聚類中心,把種子用戶的向量根據 k 個聚類中心做聚和,在類似中心內部做類似於 average 的聚和,然後得到 k 個向量,在這 k 個向量之上,一邊做 global embedding,另一邊和 target user 做 local embedding。有了這兩個 embedding 之後,通過加權和的方式,做 cosine,再去擬合 user 到 item 的 label。這裏的 label 用的是點擊。

細節:

聚類的過程需要迭代,比較耗時,並非每個 batch 都去更新聚類中心,而是採取迭代更新的方式,比如把1000個 batch 一輪,訓練完1000個 batch 之後,這1000個 batch 中,不更新聚類中心;到了第二輪,根據全連接參數的變化,再去更新種子用戶的聚類中心,每通過一輪更新一次聚類中心,保證和核心參數是同步的。這樣既保證了訓練的效率,也保證了訓練的準確性。聚類的優化,使線上的計算次數減小到了 k/K 中,之前 K 是萬級別的數量,現在 k 是百級別的數量,耗時也下降了很多。

根據實驗結果,確定不同聚類中心數 k 帶來的影響,選擇了合適的 k。實驗中,k=20,線上 k 是100左右。模型訓練的 label 優化方式,是一個多分類。對不同的種子用戶人群選擇最相似的用戶。多分類的優化方式和 deep model 相似,採用 negative sampling 的方式。

▌系統架構

線上需要實現實時預測,系統實際部署到線上,需要整套系統架構。簡單介紹下 RALM 的配套體系。

大體過程,分成三個模塊,從最底下的離線訓練,到在線異步處理,到在線服務,接下來分別講一下。

  1. 離線訓練

離線訓練,就是兩個階段的訓練,representation learning,look alike learning,需要一提的是,進行完 look alike learning 之後,可以把 user 經過全連接層的 user 表達緩存起來。全量用戶,有10多億,可以 catch 到 KV 中。可以提供給在線服務做緩存,線上不用做實時全量傳播。

2.在線異步處理

離線訓練結束后,是在線異步處理,主要作用是某些可以離線且和線上請求無關的計算,可以先計算完,如更新種子用戶。每個 item 候選集都會對應一個種子用戶列表,更新種子用戶列表,可以每一分鐘更新一次,這和訪問用戶無關,只和候選集的 item 有關。可以實時拉取用戶的點擊日誌,更新點擊某個候選集的種子列表。

① 可以把 global embedding 預計算 ( gl 只和種子用戶有關,是 self-attenion,可在線做異步處理,如每隔一分鐘算一次 )。

② 計算 k-means 聚類中心,也是只和種子用戶有關,可以提前計算好,如推到推薦系統內存中。

③ 所有的東西都是定時更新,不需要線上實時計算。

3.在線服務

線上把聚類中心、global embedding 和所有用戶的 embedding 都已緩存好,只需要拉取 user embedding,和候選集的 global embedding 和聚類中心。線上只需要計算 local embedding,是 target user 到種子用戶的 attention,這需要根據線上請求的 urn 來實時計算。再計算一次 cosine,就可以得到相似度,這個計算量很小。

▌實驗結果

算出 look alike 相似度之後,相似度的分數,可直接給到排序服務,做曝光依據。這是當時寫論文之前做的 ABtest,對比的是用戶畫像匹配推送的策略,上線之後,在擴大曝光規模的前提下,CTR 基本取向穩定,而且有微小提升,多樣性也提升了很多,這都是相對提升。

▌一些細節和思考

特徵:

為什麼要用第一階段的 user representation learning 得到用戶的高階畫像?高階畫像的作用:包含了用戶在某個領域的全部信息,信息量很大,結合 look alike learning 中的行為,需要去學習用戶群體的特徵。不用高階特徵,怎樣學習用戶群體?比較簡單的方法是通過統計的方式:平均年齡分佈和平均閱讀傾向。這些都是基於離散的統計,信息損失很大。如果有了高階的特徵,高階特徵也是從低階特徵,如基礎畫像、年月分佈,這些都是可以學到高階特徵中。如果能夠直接輸出所有領域的高階特徵,之後的利用、或者作為召回、作為 CTR 特徵,都很方便。

模型調優:

① 防止模型過擬合。look alike 的結構很簡單,這樣做的原因: 直接使用用戶的高階特徵,使用了用戶特徵,如果模型不做處理,容易對高階特徵過擬合。採取了2種方式:

  1. 盡量保證 look alike learning 結構簡單;

  2. 全連接層做 dropout。

② 採用 stacking model 的形式。看一看閱讀、電商、新聞、音樂領域都做一次 user representation learning,這些特徵用 stacking 的模式都放到 look alike model 中學習,這就是不同特徵根據不同目標來訓練的,更加減少了在同一個模型中過擬合的防線。

冷啟動曝光:

Look alike model 中用了種子用戶的表達,如果線上有新的 item,怎樣做曝光?

  1. 初始投放策略。使用基於 user item 的語義特徵做線性模型的預測,當做冷啟動 item 的初始投放。這個初始投放不需要積累很多種子用戶,大概到百級別的種子用戶就可以切到 look alike 邏輯了。

  2. Look alike 出來的相似度分數,怎麼做曝光的依據?如果直接用相似度分數,需要確定曝光閾值,如對於某個 item,高於多少分才曝光。我們使用的是線上試探曝光機制:最初給1000條流量,做曝光,這次曝光后,收集在用戶側的打分,取打分的分佈統計,根據不同業務的要求,曝光 top 5% 或者 top10%, 來砍一個閾值分數,最後取曝光閾值。

本次分享就到這裏,謝謝大家。

▌Q & A

Q:這個算法有沒有在召迴環節用,曝光該如何理解?

A:目前的策略有兩種方式:

  1. 直接採用召回的方式,定一個曝光閾值,直接確定是否曝光;

  2. 把相似分數給到下游的 CTR model 作為參考。

Q:能否將兩階段學習合併成一個端到端學習?

A:End-to-End 方式存在兩個問題:

  1. 整個模型參數量很大,結構比較複雜,採用 End-to-End 方式不一定能學習到或者學習的很充分;

  2. 剛剛講到的 stacking 方式,我們最後需要的是盡可能全的表達用戶的方式,所以右側的 user representation learning 並不是從單一業務領域得出的結果,有可能是在多個領域得到的結果,比如在看一看訓練一版 user representation learning,然後用社交或者電商上的行為,再做一版用戶的表示,最後用 stacking 的方式把它們拼接起來,作為特徵輸入,這樣達到的效果會更好。

Q:如果將第一階段用戶表徵學習換成其他通用能學習表徵用戶向量的模型,效果會有什麼影響?

A:我們單獨用 user representation learning 和其它模型做過對比,比如 CTR 中的 user embedding,是針對當前業務比較精準化的表達,所在在泛化性上沒有 user representation learning 效果好。

▌參考資料

Real-time Attention Based Look-alike Model for Recommender System

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益
.NET core3.0 使用Jwt保護api

摘要:

本文演示如何向有效用戶提供jwt,以及如何在webapi中使用該token通過JwtBearerMiddleware中間件對用戶進行身份認證。

認證和授權區別?

首先我們要弄清楚認證(Authentication)和授權(Authorization)的區別,以免混淆了。認證是確認的過程中你是誰,而授權圍繞是你被允許做什麼,即權限。顯然,在確認允許用戶做什麼之前,你需要知道他們是誰,因此,在需要授權時,還必須以某種方式對用戶進行身份驗證。 

什麼是JWT?

根據維基百科的定義,JSON WEB Token(JWT),是一種基於JSON的、用於在網絡上聲明某種主張的令牌(token)。JWT通常由三部分組成:頭信息(header),消息體(payload)和簽名(signature)。

頭信息指定了該JWT使用的簽名算法:

header = '{"alg":"HS256","typ":"JWT"}'

HS256表示使用了HMAC-SHA256來生成簽名。

消息體包含了JWT的意圖:

payload = '{"loggedInAs":"admin","iat":1422779638}'//iat表示令牌生成的時間

未簽名的令牌由base64url編碼的頭信息和消息體拼接而成(使用”.”分隔),簽名則通過私有的key計算而成:

key = 'secretkey'  
unsignedToken = encodeBase64(header) + '.' + encodeBase64(payload)  
signature = HMAC-SHA256(key, unsignedToken)

最後在未簽名的令牌尾部拼接上base64url編碼的簽名(同樣使用”.”分隔)就是JWT了:

token = encodeBase64(header) + '.' + encodeBase64(payload) + '.' + encodeBase64(signature)

# token看起來像這樣: eyJhbGciOiJIUzI1NiIsInR5cCI6IkpXVCJ9.eyJsb2dnZWRJbkFzIjoiYWRtaW4iLCJpYXQiOjE0MjI3Nzk2Mzh9.gzSraSYS8EXBxLN_oWnFSRgCzcmJmMjLiuyu5CSpyHI

JWT常常被用作保護服務端的資源(resource),客戶端通常將JWT通過HTTP的Authorization header發送給服務端,服務端使用自己保存的key計算、驗證簽名以判斷該JWT是否可信:

Authorization: Bearer eyJhbGci*...<snip>...*yu5CSpyHI

準備工作

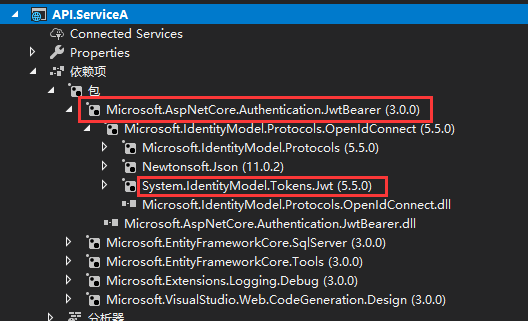
使用vs2019創建webapi項目,並且安裝nuget包

Microsoft.AspNetCore.Authentication.JwtBearer

Startup類
  • ConfigureServices 添加認證服務

services.AddAuthentication(options =>
            {
                options.DefaultAuthenticateScheme = JwtBearerDefaults.AuthenticationScheme;
                options.DefaultChallengeScheme = JwtBearerDefaults.AuthenticationScheme;
                options.DefaultScheme = JwtBearerDefaults.AuthenticationScheme;
            }).AddJwtBearer(options =>
            {
                options.SaveToken = true;
                options.RequireHttpsMetadata = false;
                options.TokenValidationParameters = new TokenValidationParameters()
                {
                    ValidateIssuer = true,
                    ValidateAudience = true,
                    ValidAudience = "https://www.cnblogs.com/chengtian",
                    ValidIssuer = "https://www.cnblogs.com/chengtian",
                    IssuerSigningKey = new SymmetricSecurityKey(Encoding.UTF8.GetBytes("SecureKeySecureKeySecureKeySecureKeySecureKeySecureKey"))
                };
            });
  • Configure 配置認證中間件

 app.UseAuthentication();//認證中間件

創建一個token

  • 添加一個登錄model命名為LoginInput

public class LoginInput
    {

        public string Username { get; set; }

        public string Password { get; set; }
    }
  • 添加一個認證控制器命名為AuthenticateController

[Route("api/[controller]")]
    public class AuthenticateController : Controller
    {
        [HttpPost]
        [Route("login")]
        public IActionResult Login([FromBody]LoginInput input)
        {
            //從數據庫驗證用戶名,密碼 
            //驗證通過 否則 返回Unauthorized

            //創建claim
            var authClaims = new[] {
                new Claim(JwtRegisteredClaimNames.Sub,input.Username),
                new Claim(JwtRegisteredClaimNames.Jti,Guid.NewGuid().ToString())
            };
            IdentityModelEventSource.ShowPII = true;
            //簽名秘鑰 可以放到json文件中
            var authSigningKey = new SymmetricSecurityKey(Encoding.UTF8.GetBytes("SecureKeySecureKeySecureKeySecureKeySecureKeySecureKey"));

            var token = new JwtSecurityToken(
                   issuer: "https://www.cnblogs.com/chengtian",
                   audience: "https://www.cnblogs.com/chengtian",
                   expires: DateTime.Now.AddHours(2),
                   claims: authClaims,
                   signingCredentials: new SigningCredentials(authSigningKey, SecurityAlgorithms.HmacSha256)
                   );

            //返回token和過期時間
            return Ok(new
            {
                token = new JwtSecurityTokenHandler().WriteToken(token),
                expiration = token.ValidTo
            });
        }
    }
添加api資源

利用默認的控制器WeatherForecastController

    • 添加個Authorize標籤

    • 路由調整為:[Route(“api/[controller]”)] 代碼如下

 [Authorize]
    [ApiController]
    [Route("api/[controller]")]
    public class WeatherForecastController : ControllerBase

到此所有的代碼都已經准好了,下面進行運行測試

運行項目

使用postman進行模擬

  • 輸入url:https://localhost:44364/api/weatherforecast


     發現返回時401未認證,下面獲取token

  • 通過用戶和密碼獲取token

    如果我們的憑證正確,將會返回一個token和過期日期,然後利用該令牌進行訪問

  • 利用token進行請求

    ok,最後發現請求狀態200!

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

人臉檢測和人臉識別原理,微調(Fine-tune)原理

一、MTCNN的原理

  搭建人臉識別系統的第一步是人臉檢測,也就是在圖片中找到人臉的位置。在這個過程中,系統的輸入是一張可能含有人臉的圖片,輸出是人臉位置的矩形框,如下圖所示。一般來說,人臉檢測應該可以正確檢測出圖片中存在的所有人臉,不能用遺漏,也不能有錯檢。  


  獲得包含人臉的矩形框后,第二步要做的就是人臉對齊(Face Alignment)。原始圖片中人臉的姿態、位置可能較大的區別,為了之後統一處理,要把人臉“擺正”。為此,需要檢測人臉中的關鍵點(Landmark),如眼睛的位置、鼻子的位置、嘴巴的位置、臉的輪廓點等。根據這些關鍵點可以使用仿射變換將人臉統一校準,以盡量消除姿勢不同帶來的誤差,人臉對齊的過程如下圖所示。


  這裏介紹一種基於深度卷積神經網絡的人臉檢測和人臉對齊方法—-MTCNN,它是基於卷積神經網絡的一種高精度的實時人臉檢測和對齊技術。MT是英文單詞Multi-task的縮寫,意思就是這種方法可以同時完成人臉檢測的人臉對齊兩項任務。相比於傳統方法,MTCNN的性能更好,可以更精確的定位人臉,此外,MTCNN也可以做到實時的檢測。

  MTCNN由三個神經網絡組成,分別是P-Net、R-Net、O-Net。在使用這些網絡之前,首先要將原始圖片縮放到不同尺度,形成一個“圖像金字塔”,如下圖所示。


  接着會對每個尺度的圖片通過神經網絡計算一遍。這樣做的原因在於:原始圖片中的人臉存在不同的尺度,如有的人臉比較大,有的人臉比較小。對於比較小的人臉,可以在放大后的圖片上檢測;對於比較大的人臉,可以在縮小后的圖片上進行檢測。這樣,就可以在統一的尺度下檢測人臉了。

  現在再來討論第一個網絡P-Net的結構,如下圖所示


  P-Net的輸入是一個寬和高皆為12像素,同時是3通道的RGB圖像,該網絡要判斷這個12×12的圖像中是否含有人臉,並且給出人臉框和關鍵點的位置。因此對應的輸出應該由3部分組成:

  (1)第一個部分要判斷該圖像是否是人臉(上圖中的face classification),輸出向量的形狀為1x1x2,也就是兩個值,分別為該圖像是人臉的概率,以及該圖像不是人臉的概率。這兩個值加起來應該嚴格等1。之所以使用兩個值來表示,是為了方便定義交叉熵損失。
  (2)第二個部分給出框的精確位置(上圖中的bounding box regression),一般稱之為框回歸。P-Net輸入的12×12的圖像塊可能並不是完美的人臉框的位置,如有的時候人臉並不正好為方形,有的時候12×12的圖像塊可能偏左或偏右,因此需要輸出當前框位置相對於完美的人臉框位置的偏移。這個偏移由四個變量組成。一般地,對於圖像中的框,可以用四個數來表示它的位置:框左上角的橫坐標、框左上角的縱坐標、框的寬度、框的高度。因此,框回歸輸出的值是:框左上角的橫坐標的相對偏移、框左上角的縱坐標的相對偏移、框的寬度的誤差、框的 高度的誤差。輸出向量的形狀就是上圖中的1x1x4。
  (3)第三個部分給出人臉的5個關鍵點的位置。5個關鍵點分別為:左眼的位置、右眼的位置、鼻子的位置、左嘴角的位置、右嘴角的位置。每個關鍵點又需要橫坐標和縱坐標來表示,因此輸出一共是10維(即1x1x10)

  上面的介紹大致就是P-Net的結構了。在實際計算中,通過P-Net中第一層卷積的移動,會對圖像中每一個12×12的區域做一次人臉檢測,得到的結構如下圖所示:


  圖中框的大小各有不同,除了框回歸的影響外,主要是因為將圖片金字塔的各個尺度都使用P-Net計算了一遍,因此形成了大小不同的人臉框。P-Net的結果還是比較粗糙的,所以接下來又使用R-Net進一步調優。R-Net的網絡結構如下圖所示。


  這個結構與之前的P-Net非常類似,P-Net的輸入是12x12x3的圖像,R-Net是24x24x3的圖像,也就是說,R-Net判斷24x24x3的圖像中是否含有人臉,以及預測關鍵點的位置。R-Net的輸出和P-Net完全一樣,同樣有人臉判別、框回歸、關鍵點位置預測三部分組成。

  在實際應用中,對每個P-Net輸出可能為人臉的區域都放縮到24×24的大小,在輸入到R-Net中,進行進一步的判定。得到的結果如下圖所示:


  顯然R-Net消除了P-Net中很多誤判的情況。

  進一步把所有得到的區域縮放成48×48的大小,輸入到最後的O-Net中,O-Net的結構同樣與P-Net類似,不同點在於它的輸入是48x48x3的圖像,網絡的通道數和層數也更多了。O-Net的網絡的結構如下圖所示:


  檢測結果如下圖所示:


  從P-Net到R-Net,最後再到O-Net,網絡輸入的圖片越來越大,卷積層的通道數越來越多,內部的層數也越來越多,因此它們識別人臉的準確率應該是越來越高的。同時,P-Net的運行速度是最快的,R-Net的速度其次,O-Net的運行速度最慢。之所以要使用三個網絡,是因為如果一開始直接對圖中的每個區域使用O-Net,速度會非常慢慢。實際上P-Net先做了一遍過濾,將過濾后的結果再交給R-Net進行過濾,最後將過濾后的結果交給效果最好但速度較慢的O-Net進行判別。這樣在每一步都提前減少了需要判別的數量,有效降低了處理時間。

  最後介紹MTCNN的損失定義和訓練過程。MTCNN中每個網絡都有三部分輸出,因此損失也由三部分組成。針對人臉判別部分,直接使用交叉熵損失,針對框回歸和關鍵點判定,直接使用L2損失。最後這三部分損失各自乘以自身的權重再加起來,就形成最後的總損失了。在訓練P-Net和R-Net時,更關心框位置的準確性,而較少關注關鍵點判定的損失,因此關鍵點判定損失的權重很小。對於O-Net,關鍵點判定損失的權重較大。

二、使用深度卷積網絡提取特徵

  經過人臉檢測和人臉對齊兩個步驟,就獲得了包含人臉的區域圖像,接下來就要進行人臉識別了。這一步一般是使用深度卷積網絡,將輸入的人臉圖像轉換為一個向量的表示,也就是所謂的“特徵”。

  如何針對人臉來提取特徵?可以先來回憶VGG16的網絡結構(見),輸入神經網絡的是圖像,經過一系列卷積計算后,全連接分類得到類別概率。

  在通常的圖像應用中,可以去掉全連接層,使用卷積層的最後一層當作圖像的“特徵”。但如果對人臉識別問題同樣採用這種方法,即使用卷積層最後一層做為人臉的“向量表示”,效果其實是不好的。這其中的原因和改進方法是什麼?在後面會談到,這裏先談談希望這種人臉的“向量表示”應該具有哪些性質。

  在理想的狀況下,希望“向量表示”之間的距離可以直接反映人臉的相似度:

  對於同一個人的兩張人臉圖像,對應的向量之間的歐幾里得距離應該比較小。對於不同人的兩張人臉圖像,對應的向量之間的歐幾里得距離應該比較大。

  例如,設人臉圖像為$x_{1}$,$x_{2}$,對應的特徵為$f(x_{1})$,$f(x_{2})$,當$x_{1}$,$x_{2}$對應是同一個人的人臉時,$f(x_{1})$,$f(x_{2})$的距離$\left \| f(x_{1}),f(x_{2}) \right \|$2應該很小,而當$x_{1}$,$x_{2}$是不同人的人臉時,$f(x_{1})$,$f(x_{2})$的距離$\left \| f(x_{1}),f(x_{2}) \right \|$2應該很大。

  在原始的CNN模型中,使用的是Softmax損失。Softmax是類別間的損失,對於人臉來說,每一類就是一個人。儘管使用Softmax損失可以區別出每個人,但其本質上沒有對每一類的向量表示之間的距離做出要求。

  舉個例子,使用CNN對MNIST進行分類,設計一個特殊的卷積網絡,讓其最後一層的向量變為2維,此時可以畫出每一類對應的2維向量(圖中一種顏色對應一種類別),如下圖所示:


  上圖是我們直接使用softmax訓練得到的結果,它就不符合我們希望特徵具有的特點:

  (1)我們希望同一類對應的向量表示盡可能接近。但這裏同一類(如紫色),可能具有很大的類間距離;
  (2)我們希望不同類對應的向量應該盡可能遠。但在圖中靠中心的位置,各個類別的距離都很近;

  對於人臉圖像同樣會出現類似的情況,對此,有很改進方法。這裏介紹其中兩種:一種是三元組損失函數(Triplet Loss),一種是中心損失函數。 

三、三元組損失的定義

  三元組損失函數的原理:既然目標是特徵之間的距離應該具備某些性質,那麼我們就圍繞這個距離來設計損失。具體的,我們每次都在訓練數據中抽出三張人臉圖像,第一張圖像記為$x_{i}^{a}$,第二張圖像記為$x_{i}^{p}$,第三張圖像記為$x_{i}^{n}$。在這樣的一個“三元組”中,$x_{i}^{a}$和$x_{i}^{p}$對應的是同一個人的圖像,而$x_{i}^{n}$是另外一個不同的人的人臉圖像。因此,距離$\left \| f(x_{i}^{a})-f(x_{i}^{p}) \right \|_{2}$應該較小,而距離$\left \| f(x_{i}^{a})-f(x_{i}^{n}) \right \|_{2}$應該較大。嚴格來說,三元組損失要求下面的式子成立:

   $\left \| f(x_{i}^{a})- f(x_{i}^{p})\right \|_{2}^{2}+\alpha <\left \| f(x_{i}^{a})- f(x_{i}^{p})\right \|_{2}^{2}$

  然後計算相同人臉之間與不同人臉之間距離的平方

   $\left [ \left \| f(x_{i}^{a})-f(x_{i}^{p}) \right \|_{2}^{2}+\alpha -\left \| f(x_{i}^{a})-f(x_{i}^{n}) \right \|_{2}^{2} \right ]_{+}$

  上式表達相同人臉間的距離平方至少要比不同人臉間的距離平方小α(取平方主要是為了方便求導),據此,上式實際上就是相當於一個損失函數。這樣的話,當三元組的距離滿足 $\left \| f(x_{i}^{a})- f(x_{i}^{p})\right \|_{2}^{2}+\alpha <\left \| f(x_{i}^{a})- f(x_{i}^{p})\right \|_{2}^{2}$時,不產生任何損失,此時$L_{i}=0$。當距離不滿足上述等式時,就會有值為$\left \| f(x_{i}^{a})-f(x_{i}^{p}) \right \|_{2}^{2}+\alpha -\left \| f(x_{i}^{a})-f(x_{i}^{n}) \right \|_{2}^{2}$的損失。此外,在訓練時會固定$\left \| f(x) \right \|_{2}=1$,以保證特徵不會無限地“遠離”。

  三元組損失直接對距離進行優化,因此可以解決人臉的特徵表示問題。但是在訓練過程中,三元組的選擇非常地有技巧性。如果每次都是隨機選擇三元組,雖然模型可以正確的收斂,但是並不能達到最好的性能。如果加入”難例挖掘”,即每次都選擇最難分辨率的三元組進行訓練,模型又往往不能正確的收斂。對此,又提出每次都選擇那些“半難”(Semi-hard)的數據進行訓練,讓模型在可以收斂的同時也保持良好的性能。此外,使用三元組損失訓練人臉模型通常還需要非常大的人臉數據集,才能取得較好的效果。

四、中心損失的定義

  與三元組損失不同,中心損失(Center Loss)不直接對距離進行優化,它保留了原有的分類模型,但又為每個類(在人臉模型中,一個類就對應一個人)指定了一個類別中心。同一類的圖像對應的特徵都應該盡量靠近自己的類別中心,不同類的類別中心盡量遠離。與三元組損失函數相比,使用中心損失訓練人臉模型不需要使用特別的採樣方法,而且利用較少的圖像就可以達到與單元組損失相似的效果。下面我們一起來學習中心損失的定義:

   還是設輸入的人臉圖像為$x_{i}$,該人臉對應的類別為$y_{i}$,對每個類別都規定一個類別中心,記作$c_{yi}$。希望每個人臉圖像對應的特徵$f(x_{i})$都盡可能接近其中心$c_{yi}$。因此定義中心損失為:

    $L_{i}=\frac{1}{2}\left \| f(x_{i})-c_{yi}\right \|_{2}^{2}$

  多張圖像的中心損失就是將它們的值加在一起:

   $L_{center}=\sum\limits_{i}L_i$

  這是一個非常簡單的定義。不過還有一個問題沒有解決,那就是如何確定每個類別的中心$c_{yi}$呢?從理論上來說,類別$y_{i}$的最佳中心應該是它對應的所有圖片的特徵的平均值。但如果採取這樣的定義,那麼在每一次梯度下降時,都要對所有圖片計算一次$c_{yi}$,計算複雜度就太高了。針對這種情況,不妨近似一處理下,在初始階段,先隨機確定$c_{yi}$,接着在每個batch內,使用$L_i=\|f(x_i)-c_{yi}\|_2^2$對當前batch內的$c_{yi}$ 也計算梯度,並使用該梯度更新$c_{yi}$ 。此外,不能只使用中心損失來訓練分類模型,還需要加入Softmax損失,也就是說,最終的損失由兩部分構成,即$L = L_{softmax}+\lambda L_{center}$,其中$\lambda $是一個超參數。

  最後來總結使用中心損失來訓練人臉模型的過程。首先隨機初始化各个中心$c_{yi}$,接着不斷地取出batch進行訓練,在每個batch中,使用總的損失$L$,除了使用神經網絡模型的參數對模型進行更新外,也對$c_{yi}$進行計算梯度,並更新中心的位置。

  中心損失可以讓訓練處的特徵具有“內聚性”。還是以MNIST的例子來說,在未加入中心損失時,訓練的結果不具有內聚性。再加入中心損失后,得到的特徵如下圖所示。 


從圖中可以看出,當中心損失的權重λ越大時,生成的特徵就會具有越明顯的“內聚性” 。

五、使用特徵設計應用

當提取出特徵后,剩下的問題就非常簡單了。因為這種特徵已經具有了相同人對應的向量的距離小,不同人對應的向量距離大的特點,接下來,一般的應用有以下幾類:

  • 人臉驗證(Face Identification)。就是檢測A、B是否屬於同一個人。只需要計算向量之間的距離,設定合適的報警閾值(threshold)即可。
  • 人臉識別(Face Recognition)。這個應用是最多的,給定一張圖片,檢測數據庫中與之最相似的人臉。顯然可以被轉換為一個求距離的最近鄰問題。
  • 人臉聚類(Face Clustering)。在數據庫中對人臉進行聚類,直接用K-means即可。


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益
Java虛擬機詳解(十)——類加載過程

  在上一篇文章中,我們詳細的介紹了Java,那麼這些Class文件是如何被加載到內存,由虛擬機來直接使用的呢?這就是本篇博客將要介紹的——類加載過程。

1、類的生命周期

  類從被加載到虛擬機內存開始,到卸載出內存為止,其聲明周期流程如下:


  上圖中紅色的5個部分(加載、驗證、準備、初始化、卸載)順序是確定的,也就是說,類的加載過程必須按照這種順序按部就班的開始。這裏的“開始”不是按部就班的“進行”或者“完成”,因為這些階段通常是互相交叉混合的進行的,通常會在一個階段執行過程中調用另一個階段。

2、加載

  “加載”階段是“類加載”生命周期的第一個階段。在加載階段,虛擬機要完成下面三件事:

  ①、通過一個類的全限定名來獲取定義此類的二進制字節流。

  ②、將這個字節流所代表的靜態存儲結構轉化為方法區的運行時數據結構。

  ③、在Java堆中生成一個代表這個類的java.lang.Class對象,作為方法區這些數據的訪問入口。

  PS:類的全限定名可以理解為這個類存放的絕對路徑。方法區是JDK1.7以前定義的運行時數據區,而在JDK1.8以後改為元數據區(Metaspace),主要用於存放被Java虛擬機加載的類信息、常量、靜態變量、即時編譯器編譯后的代碼等數據。詳情可以參考這邊該系列的第二篇文章——。

  另外,我們看第一點——通過類的權限定名來獲取定義此類的二進制流,這裏並沒有明確指明要從哪裡獲取以及怎樣獲取,也就是說並沒有明確規定一定要我們從一個 Class 文件中獲取。基於此,在Java的發展過程中,充滿創造力的開發人員在這個舞台上玩出了各種花樣:

  1、從 ZIP 包中讀取。這稱為後面的 JAR、EAR、WAR 格式的基礎。

  2、從網絡中獲取。比較典型的應用就是 Applet。

  3、運行時計算生成。這就是動態代理技術。

  4、由其它文件生成。比如 JSP 應用。

  5、從數據庫中讀取。

  加載階段完成后,虛擬機外部的二進制字節流就按照虛擬機所需的格式存儲在方法區中,然後在Java堆中實例化一個 java.lang.Class 類的對象,這個對象將作為程序訪問方法區中這些類型數據的外部接口。

  注意,加載階段與連接階段的部分內容(如一部分字節碼文件的格式校驗)是交叉進行的,加載階段尚未完成,連接階段可能已經開始了。

3、驗證

  驗證是連接階段的第一步,作用是為了確保 Class 文件的字節流中包含的信息符合當前虛擬機的要求,並且不會危害虛擬機自身的安全。

  我們說Java語言本身是相對安全,因為編譯器的存在,純粹的Java代碼要訪問數組邊界外的數據、跳轉到不存在的代碼行之類的,是要被編譯器拒絕的。但是前面我們也說過,Class 文件不一定非要從Java源碼編譯過來,可以使用任何途徑,包括你很牛逼,直接用十六進制編輯器來編寫 Class 文件。

  所以,如果虛擬機不檢查輸入的字節流,將會載入有害的字節流而導致系統崩潰。但是虛擬機規範對於檢查哪些方面,何時檢查,怎麼檢查都沒有明確的規定,不同的虛擬機實現方式可能都會有所不同,但是大致都會完成下面四個方面的檢查。

①、文件格式驗證

  校驗字節流是否符合Class文件格式的規範,並且能夠被當前版本的虛擬機處理。

  一、是否以魔數 0xCAFEBABE 開頭。

  二、主、次版本號是否是當前虛擬機處理範圍之內。

  三、常量池的常量中是否有不被支持的常量類型(檢查常量tag標誌)

  四、指向常量的各種索引值中是否有指向不存在的常量或不符合類型的常量。

  五、CONSTANT_Utf8_info 型的常量中是否有不符合 UTF8 編碼的數據。

  六、Class 文件中各個部分及文件本身是否有被刪除的或附加的其他信息。

  以上是一部分校驗內容,當然遠不止這些。經過這些校驗后,字節流才會進入內存的方法區中存儲,接下來後面的三個階段校驗都是基於方法區的存儲結構進行的。

②、元數據驗證

  第二個階段主要是對字節碼描述的信息進行語義分析,以保證其描述的信息符合Java語言規範要求。

  一、這個類是否有父類(除了java.lang.Object 類之外,所有的類都應當有父類)。

  二、這個類的父類是否繼承了不允許被繼承的類(被final修飾的類)。

  三、如果這個類不是抽象類,是否實現了其父類或接口之中要求實現的所有普通方法。

  四、類中的字段、方法是否與父類產生了矛盾(例如覆蓋了父類的final字段、或者出現不符合規則的重載)

③、字節碼驗證

  第三個階段字節碼驗證是整個驗證階段中最複雜的,主要是進行數據流和控制流分析。該階段將對類的方法進行分析,保證被校驗的方法在運行時不會做出危害虛擬機安全的行為。

  一、保證任意時刻操作數棧中的數據類型與指令代碼序列都能配合工作。例如不會出現在操作數棧中放置了一個 int 類型的數據,使用時卻按照 long 類型來加載到本地變量表中。

  二、保證跳轉指令不會跳轉到方法體以外的字節碼指令中。

  三、保證方法體中的類型轉換是有效的。比如把一個子類對象賦值給父類數據類型,這是安全的。但是把父類對象賦值給子類數據類型,甚至賦值給完全不相干的類型,這就是不合法的。

④、符號引用驗證

  符號引用驗證主要是對類自身以外(常量池中的各種符號引用)的信息進行匹配性的校驗,通常需要校驗如下內容:

  一、符號引用中通過字符串描述的全限定名是否能夠找到相應的類。

  二、在指定類中是否存在符合方法的字段描述符及簡單名稱所描述的方法和字段。

  三、符號引用中的類、字段和方法的訪問性(private、protected、public、default)是否可以被當前類訪問。

4、準備

  準備階段是正式為類變量分配內存並設置類變量初始值的階段,這些內存是在方法區中進行分配。

  注意:

  一、上面說的是類變量,也就是被 static 修飾的變量,不包括實例變量。實例變量會在對象實例化時隨着對象一起分配在堆中。

  二、初始值,指的是一些數據類型的默認值。基本的數據類型初始值如下(引用類型的初始值為null):


   比如,定義 public static int value = 123 。那麼在準備階段過後,value 的值是 0 而不是 123,把 value 賦值為123 是在程序被編譯后,存放在類的構造器方法之中,是在初始化階段才會被執行。但是有一種特殊情況,通過final 修飾的屬性,比如 定義 public final static int value = 123,那麼在準備階段過後,value 就被賦值為123了。

5、解析

  解析階段是虛擬機將常量池中的符號引用替換為直接引用的過程。

  符號引用(Symbolic References):符號引用以一組符號來描述所引用的目標,符號可以是任何形式的字面量,只要使用時能無歧義的定位到目標即可。符號引用與虛擬機實現的內存布局無關,引用的目標不一定已經加載到內存中。

  直接引用(Direct References):直接引用可以是直接指向目標的指針、相對偏移量或是一個能間接定位到目標的句柄。直接引用是與虛擬機實現內存布局相關的,同一個符號引用在不同虛擬機實例上翻譯出來的直接引用一般不會相同。如果有了直接引用,那麼引用的目標必定已經在內存中存在。

  解析動作主要針對類或接口、字段、類方法、接口方法四類符號引用,分別對應於常量池的 CONSTANT_Class_info、CONSTANT_Fieldref_info、CONSTANT_Methodref_info、CONSTANTS_InterfaceMethodref_info四種類型常量。

6、初始化

   初始化階段是類加載階段的最後一步,前面過程中,除第一個加載階段可以通過用戶自定義類加載器參与之外,其餘過程都是完全由虛擬機主導和控制。而到了初始化階段,則開始真正執行類中定義的Java程序代碼(或者說是字節碼)。

  在前面介紹的準備階段中,類變量已經被賦值過初始值了,而初始化階段,則根據程序員的編碼去初始化變量和資源。

  換句話來說,初始化階段是執行類構造器<clinit>() 方法的過程。

  ①、<clinit>() 方法 是由編譯器自動收集類中的所有類變量的賦值動作和靜態語句塊(static{})中的語句合併產生的,編譯器收集的順序是由語句在源文件中出現的順序所決定的,靜態語句塊中只能訪問到定義在靜態語句塊之前的變量,定義在它之後的變量,在前面的靜態語句塊中可以賦值,但是不能訪問。

  比如如下代碼會報錯:


   但是你把第 14 行代碼放到 static 靜態代碼塊的上面就不會報錯了。或者不改變代碼順序,將第 11 行代碼移除,也不會報錯。

  ②、<clinit>() 方法與類的構造函數(或者說是實例構造器<init>()方法)不同,它不需要显示的調用父類構造器,虛擬機會保證在子類的<init>()方法執行之前,父類的<init>()方法已經執行完畢。因此虛擬機中第一個被執行的<init>()方法的類肯定是 java.lang.Object。

  ③、由於父類的<clinit>() 方法先執行,所以父類中定義的靜態語句塊要優先於子類的變量賦值操作。

  ④、<clinit>() 方法對於接口來說並不是必須的,如果一個類中沒有靜態語句塊,也沒有對變量的賦值操作,那麼編譯器可以不為這個類生成<clinit>() 方法。

  ⑤、接口中不能使用靜態語句塊,但仍然有變量初始化的賦值操作,因此接口與類一樣都會生成<clinit>() 方法。但接口與類不同的是,執行接口中的<clinit>() 方法不需要先執行父接口的<clinit>() 方法。只有當父接口中定義的變量被使用時,父接口才會被初始化。

  ⑥、接口的實現類在初始化時也一樣不會執行接口的<clinit>() 方法。

  ⑦、虛擬機會保證一個類的<clinit>() 方法在多線程環境中被正確的加鎖和同步。如果多個線程同時去初始化一個類,那麼只會有一個線程去執行這個類的<clinit>() 方法,其他的線程都需要阻塞等待,直到活動線程執行<clinit>() 方法完畢。如果在一個類的<clinit>() 方法中有很耗時的操作,那麼可能造成多個進程的阻塞。

  比如對於如下代碼:

package com.yb.carton.controller;

/**
 * Create by YSOcean
 */
public class ClassLoadInitTest {


    static class Hello{
        static {
            if(true){
                System.out.println(Thread.currentThread().getName() + "init");
                while(true){}
            }
        }
    }

    public static void main(String[] args) {
        new Thread(()->{
            System.out.println(Thread.currentThread().getName()+"start");
            Hello h1 = new Hello();
            System.out.println(Thread.currentThread().getName()+"run over");
        }).start();


        new Thread(()->{
            System.out.println(Thread.currentThread().getName()+"start");
            Hello h2 = new Hello();
            System.out.println(Thread.currentThread().getName()+"run over");
        }).start();
    }

}

View Code

  運行結果如下:


   線程1搶到了執行<clinit>() 方法,但是該方法是一個死循環,線程2將一直阻塞等待。

  知道了類的初始化過程,那麼類的初始化何時被觸發呢?JVM大概規定了如下幾種情況:

  ①、當虛擬機啟動時,初始化用戶指定的類。

  ②、當遇到用以新建目標類實例的 new 指令時,初始化 new 指定的目標類。

  ③、當遇到調用靜態方法的指令時,初始化該靜態方法所在的類。

  ④、當遇到訪問靜態字段的指令時,初始化該靜態字段所在的類。

  ⑤、子類的初始化會觸發父類的初始化。

  ⑥、如果一個接口定義了 default 方法,那麼直接實現或間接實現該接口的類的初始化,會觸發該接口的初始化。

  ⑦、使用反射 API 對某個類進行反射調用時,會初始化這個類。

  ⑧、當初次調用 MethodHandle 實例時,初始化該 MethodHandle 指向的方法所在的類。


本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

Java——內部類詳解

說起內部類,大家肯定感覺熟悉又陌生,因為一定在很多框架源碼中有看到別人使用過,但又感覺自己使用的比較少,今天我就帶你具體來看看內部類。

內部類基礎

所謂內部類就是在類的內部繼續定義其他內部結構類。

在 Java 中,廣泛意義上的內部類一般來說包括這四種:成員內部類、局部內部類、匿名內部類和靜態內部類。下面就先來了解一下這四種內部類的用法。

成員內部類

成員內部類是最普通的內部類,它的定義為位於另一個類的內部,具體使用如下:

class Circle {
    double radius = 0;

    public Circle(double radius) {
        this.radius = radius;
    }

    /**
     * 內部類
     */
    class Draw {
        public void drawSahpe() {
            System.out.println("drawshape");
        }
    }
}

這樣看起來,類 Draw 像是類 Circle 的一個成員, Circle 稱為外部類。成員內部類可以無條件訪問外部類的所有成員屬性和成員方法(包括 private 成員和靜態成員),例如:

class Circle {
    private double radius = 0;
    public static int count =1;
    public Circle(double radius) {
        this.radius = radius;
    }

    /**
     * 內部類
     */
    class Draw {
        public void drawSahpe() {
            // 外部類的private成員
            System.out.println(radius);
            // 外部類的靜態成員
            System.out.println(count);
        }
    }
}

不過要注意的是,當成員內部類擁有和外部類同名的成員變量或者方法時,會發生隱藏現象,即默認情況下訪問的是成員內部類的成員。如果要訪問外部類的同名成員,需要採取以下形式進行訪問:

外部類.this.成員變量
外部類.this.成員方法

雖然成員內部類可以無條件地訪問外部類的成員,而外部類想訪問成員內部類的成員卻不是這麼隨心所欲了。在外部類中如果要訪問成員內部類的成員,必須先創建一個成員內部類的對象,再通過指向這個對象的引用來訪問,其具體形式為:

class Circle {
    private double radius = 0;

    public Circle(double radius) {
        this.radius = radius;
        // 必須先創建成員內部類的對象,再進行訪問
        getDrawInstance().drawSahpe();
    }

    private Draw getDrawInstance() {
        return new Draw();
    }

    /**
     * 內部類
     */
    class Draw {
        public void drawSahpe() {
            // 外部類的private成員
            System.out.println(radius);
        }
    }
}

成員內部類是依附外部類而存在的,也就是說,如果要創建成員內部類的對象,前提是必須存在一個外部類的對象。創建成員內部類對象的一般方式如下:

public class Test {
    public static void main(String[] args)  {
        // 第一種方式
        Outter outter = new Outter();
        // 必須通過Outter對象來創建
        Outter.Inner inner = outter.new Inner();

        // 第二種方式
        Outter.Inner inner1 = outter.getInnerInstance();
    }
}

class Outter {
    private Inner inner = null;
    public Outter() {
    }

    public Inner getInnerInstance() {
        if(inner == null)
            inner = new Inner();
        return inner;
    }

    class Inner {
        public Inner() {
        }
    }
}

內部類可以擁有 private 訪問權限、 protected 訪問權限、 public 訪問權限及包訪問權限。

比如上面的例子,如果成員內部類 Inner 用 private 修飾,則只能在外部類的內部訪問;如果用 public 修飾,則任何地方都能訪問;如果用 protected 修飾,則只能在同一個包下或者繼承外部類的情況下訪問;如果是默認訪問權限,則只能在同一個包下訪問。

這一點和外部類有一點不一樣,外部類只能被 public 和包訪問兩種權限修飾。

我個人是這麼理解的,由於成員內部類看起來像是外部類的一個成員,所以可以像類的成員一樣擁有多種權限修飾。

局部內部類

局部內部類是定義在一個方法或者一個作用域裏面的類,它和成員內部類的區別在於局部內部類的訪問僅限於方法內或者該作用域內。

class People{
    public People() {
    }
}

class Man{
    public Man(){
    }

    public People getWoman(){
        /**
         * 局部內部類
         */
        class Woman extends People{
            int age =0;
        }
        return new Woman();
    }
}

注意,局部內部類就像是方法裏面的一個局部變量一樣,是不能用 public 、 protected 、 private 以及 static 修飾的。

匿名內部類

匿名內部類應該是平時我們編寫代碼時用得最多的,比如創建一個線程的時候:

class Test {

    public static void main(String[] args) {
        Thread thread = new Thread(
                // 匿名內部類
                new Runnable() {
                    @Override
                    public void run() {
                        System.out.println("Thread run");
                    }
                }
        );
    }
}

同樣的,匿名內部類也是不能有訪問修飾符和 static 修飾符的。

匿名內部類是唯一一種沒有構造器的類。正因為其沒有構造器,所以匿名內部類的使用範圍非常有限,大部分匿名內部類用於接口回調。

匿名內部類在編譯的時候由系統自動起名為Outter$1.class。一般來說,匿名內部類用於繼承其他類或是實現接口,並不需要增加額外的方法,只是對繼承方法的實現或是重寫。

靜態內部類

靜態內部類也是定義在另一個類裏面的類,只不過在類的前面多了一個關鍵字 static 。

靜態內部類是不需要依賴於外部類的,這點和類的靜態成員屬性有點類似,並且它不能使用外部類的非 static 成員變量或者方法,這點很好理解,因為在沒有外部類的對象的情況下,可以創建靜態內部類的對象,如果允許訪問外部類的非 static 成員就會產生矛盾,因為外部類的非 static 成員必須依附於具體的對象。

例如:

public class Test {
    public static void main(String[] args)  {
        Outter.Inner inner = new Outter.Inner();
    }
}

class Outter {
    public Outter() {
    }

    /**
     * 靜態
     */
    static class Inner {
        public Inner() {
        }
    }
}

深入理解內部類

通過上面的介紹,相比你已經大致了解的內部類的使用,那麼你的心裏想必會有一個疑惑:

為什麼成員內部類可以無條件訪問外部類的成員?

首先我們先定義一個內部類:

public class Outter {
    private Inner inner = null;

    public Outter() {
    }

    public Inner getInnerInstance() {
        if (inner == null)
            inner = new Inner();
        return inner;
    }

    protected class Inner {
        public Inner() {
        }
    }
}

先用 javac 進行編譯,你可以發現會生成兩個文件: Outter$Inner.class 和 Outter.class 。接下來利用javap -p反編譯 Outter$Inner.class ,其結果如下:

Classfile /D:/project/Test/src/test/java/test/Outter$Inner.class
  Last modified 2019-11-25; size 408 bytes
  MD5 checksum b936e37bc77059b83951429e28f3f225
  Compiled from "Outter.java"
public class Outter$Inner
  minor version: 0
  major version: 52
  flags: ACC_PUBLIC, ACC_SUPER
Constant pool:
   #1 = Fieldref           #3.#13         // test/Outter$Inner.this$0:Ltest/Outter;
   #2 = Methodref          #4.#14         // java/lang/Object."<init>":()V
   #3 = Class              #16            // test/Outter$Inner
   #4 = Class              #19            // java/lang/Object
   #5 = Utf8               this$0
   #6 = Utf8               Ltest/Outter;
   #7 = Utf8               <init>
   #8 = Utf8               (Ltest/Outter;)V
   #9 = Utf8               Code
  #10 = Utf8               LineNumberTable
  #11 = Utf8               SourceFile
  #12 = Utf8               Outter.java
  #13 = NameAndType        #5:#6          // this$0:Ltest/Outter;
  #14 = NameAndType        #7:#20         // "<init>":()V
  #15 = Class              #21            // test/Outter
  #16 = Utf8               test/Outter$Inner
  #17 = Utf8               Inner
  #18 = Utf8               InnerClasses
  #19 = Utf8               java/lang/Object
  #20 = Utf8               ()V
  #21 = Utf8               test/Outter
{
  final Outter this$0;
    descriptor: Ltest/Outter;
    flags: ACC_FINAL, ACC_SYNTHETIC

  public Outter$Inner(Outter);
    descriptor: (Ltest/Outter;)V
    flags: ACC_PUBLIC
    Code:
      stack=2, locals=2, args_size=2
         0: aload_0
         1: aload_1
         2: putfield      #1                  // Field this$0:Ltest/Outter;
         5: aload_0
         6: invokespecial #2                  // Method java/lang/Object."<init>":()V
         9: return
      LineNumberTable:
        line 16: 0
        line 17: 9
}
SourceFile: "Outter.java"
InnerClasses:
     protected #17= #3 of #15; //Inner=class test/Outter$Inner of class test/Outter

32行的內容為:final Outter this$0;

學過 C 的朋友應該能知道,這是一個指向外部類 Outter 對象的指針,也就是說編譯器會默認為成員內部類添加一個指向外部類對象的引用,這樣也就解釋了為什麼成員內部類能夠無條件訪問外部類了。

那麼這個引用是如何賦初值的呢?下面接着看內部類的構造器:public Outter$Inner(Outter);

從這裏可以看出,雖然我們在定義的內部類的構造器是無參構造器,但編譯器還是會默認添加一個參數,該參數的類型為指向外部類對象的一個引用,所以成員內部類中的 Outter this&0 指針便指向了外部類對象,因此可以在成員內部類中隨意訪問外部類的成員。

從這裏也間接說明了成員內部類是依賴於外部類的,如果沒有創建外部類的對象,則無法對 Outter this&0 引用進行初始化賦值,也就無法創建成員內部類的對象了。

為什麼局部內部類和匿名內部類只能訪問局部final變量?

我們還是採用和之前一樣的解答方式,先定義一個類:

public class Outter {

    public static void main(String[] args)  {
        Outter outter = new Outter();
        int b = 10;
        outter.test(b);
    }

    public void test(final int b) {
        final int a = 10;
        new Thread(){
            public void run() {
                System.out.println(a);
                System.out.println(b);
            };
        }.start();
    }
}

通過 javac 編譯 Outter,也會生成兩個文件: Outter.class 和 Outter1.class。默認情況下,編譯器會為匿名內部類和局部內部類起名為 Outter$x.class( x 為正整數)。

根據我提供的類,可以思考一個問題:

當 test 方法執行完畢之後,變量 a 的生命周期就結束了,而此時 Thread 對象的生命周期很可能還沒有結束,那麼在 Thread 的 run 方法中繼續訪問變量 a 就變成不可能了,但是又要實現這樣的效果,怎麼辦呢?

Java 採用了複製的手段來解決這個問題。將 Outter$1.class 反編譯可以得到下面的內容:

Classfile /D:/project/Test/src/test/java/test/Outter$1.class
  Last modified 2019-11-25; size 653 bytes
  MD5 checksum 2e238dafbd73356eba22d473c6469082
  Compiled from "Outter.java"
class test.Outter$1 extends java.lang.Thread
  minor version: 0
  major version: 52
  flags: ACC_SUPER
Constant pool:
   #1 = Fieldref           #6.#23         // test/Outter$1.this$0:Ltest/Outter;
   #2 = Fieldref           #6.#24         // test/Outter$1.val$b:I
   #3 = Methodref          #7.#25         // java/lang/Thread."<init>":()V
   #4 = Fieldref           #26.#27        // java/lang/System.out:Ljava/io/PrintStream;
   #5 = Methodref          #28.#29        // java/io/PrintStream.println:(I)V
   #6 = Class              #30            // test/Outter$1
   #7 = Class              #32            // java/lang/Thread
   #8 = Utf8               val$b
   #9 = Utf8               I
  #10 = Utf8               this$0
  #11 = Utf8               Ltest/Outter;
  #12 = Utf8               <init>
  #13 = Utf8               (Ltest/Outter;I)V
  #14 = Utf8               Code
  #15 = Utf8               LineNumberTable
  #16 = Utf8               run
  #17 = Utf8               ()V
  #18 = Utf8               SourceFile
  #19 = Utf8               Outter.java
  #20 = Utf8               EnclosingMethod
  #21 = Class              #33            // test/Outter
  #22 = NameAndType        #34:#35        // test:(I)V
  #23 = NameAndType        #10:#11        // this$0:Ltest/Outter;
  #24 = NameAndType        #8:#9          // val$b:I
  #25 = NameAndType        #12:#17        // "<init>":()V
  #26 = Class              #36            // java/lang/System
  #27 = NameAndType        #37:#38        // out:Ljava/io/PrintStream;
  #28 = Class              #39            // java/io/PrintStream
  #29 = NameAndType        #40:#35        // println:(I)V
  #30 = Utf8               test/Outter$1
  #31 = Utf8               InnerClasses
  #32 = Utf8               java/lang/Thread
  #33 = Utf8               test/Outter
  #34 = Utf8               test
  #35 = Utf8               (I)V
  #36 = Utf8               java/lang/System
  #37 = Utf8               out
  #38 = Utf8               Ljava/io/PrintStream;
  #39 = Utf8               java/io/PrintStream
  #40 = Utf8               println
{
  final int val$b;
    descriptor: I
    flags: ACC_FINAL, ACC_SYNTHETIC

  final test.Outter this$0;
    descriptor: Ltest/Outter;
    flags: ACC_FINAL, ACC_SYNTHETIC

  test.Outter$1(test.Outter, int);
    descriptor: (Ltest/Outter;I)V
    flags:
    Code:
      stack=2, locals=3, args_size=3
         0: aload_0
         1: aload_1
         2: putfield      #1                  // Field this$0:Ltest/Outter;
         5: aload_0
         6: iload_2
         7: putfield      #2                  // Field val$b:I
        10: aload_0
        11: invokespecial #3                  // Method java/lang/Thread."<init>":()V
        14: return
      LineNumberTable:
        line 10: 0

  public void run();
    descriptor: ()V
    flags: ACC_PUBLIC
    Code:
      stack=2, locals=1, args_size=1
         0: getstatic     #4                  // Field java/lang/System.out:Ljava/io/PrintStream;
         3: bipush        10
         5: invokevirtual #5                  // Method java/io/PrintStream.println:(I)V
         8: getstatic     #4                  // Field java/lang/System.out:Ljava/io/PrintStream;
        11: aload_0
        12: getfield      #2                  // Field val$b:I
        15: invokevirtual #5                  // Method java/io/PrintStream.println:(I)V
        18: return
      LineNumberTable:
        line 12: 0
        line 13: 8
        line 14: 18
}
SourceFile: "Outter.java"
EnclosingMethod: #21.#22                // test.Outter.test
InnerClasses:
     #6; //class test/Outter$1

我們看到在 run 方法中有一條指令:bipush 10

這條指令表示將操作數10壓棧,表示使用的是一個本地局部變量。

這個過程是在編譯期間由編譯器默認進行,如果這個變量的值在編譯期間可以確定,則編譯器默認會在匿名內部類(局部內部類)的常量池中添加一個內容相等的字面量或直接將相應的字節碼嵌入到執行字節碼中。

這樣一來,匿名內部類使用的變量是另一個局部變量,只不過值和方法中局部變量的值相等,因此和方法中的局部變量完全獨立開。

接下來也來看一下 test.Outter$1 的構造方法:test.Outter$1(test.Outter, int);

我們看到匿名內部類 Outter$1 的構造器含有兩個參數,一個是指向外部類對象的引用,一個是 int 型變量,很顯然,這裡是將變量 test 方法中的形參 b 以參數的形式傳進來對匿名內部類中的拷貝(變量 b 的拷貝)進行賦值初始化。

也就說如果局部變量的值在編譯期間就可以確定,則直接在匿名內部裏面創建一個拷貝。如果局部變量的值無法在編譯期間確定,則通過構造器傳參的方式來對拷貝進行初始化賦值。

從上面可以看出,在 run 方法中訪問的變量 b 根本就不是test方法中的局部變量 b 。這樣一來就解決了前面所說的 生命周期不一致的問題。但是新的問題又來了,既然在 run 方法中訪問的變量 b 和test方法中的變量 b 不是同一個變量,那麼當在 run 方法中改變變量 b 的值的話,會出現什麼情況?

會造成數據不一致性,這樣就達不到原本的意圖和要求。為了解決這個問題, Java 編譯器就限定必須將變量 b 限製為 final ,不允許對變量 b 進行更改(對於引用類型的變量,是不允許指向新的對象),這樣數據不一致性的問題就得以解決了。

到這裏,想必大家應該清楚為何 方法中的局部變量和形參都必須用 final 進行限定了。

靜態內部類有特殊的地方嗎?

從前面可以知道,靜態內部類是不依賴於外部類的,也就說可以在不創建外部類對象的情況下創建內部類的對象。

另外,靜態內部類是不持有指向外部類對象的引用的,這個讀者可以自己嘗試反編譯 class 文件看一下就知道了,是沒有 Outter this&0 引用的。

總結

今天介紹了內部類相關的知識,包括其一般的用法以及內部類和外部類的依賴關係,通過對字節碼進行反編譯詳細了解了其實現模式,最後留給大家一個任務自己去實際探索一下靜態內部類的實現。希望通過這篇介紹可以幫大家更加深刻了解內部類。

有興趣的話可以訪問我的博客或者關注我的公眾號、頭條號,說不定會有意外的驚喜。

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※帶您來了解什麼是 USB CONNECTOR  ?

※自行創業 缺乏曝光? 下一步"網站設計"幫您第一時間規劃公司的門面形象

※如何讓商品強力曝光呢? 網頁設計公司幫您建置最吸引人的網站,提高曝光率!!

※綠能、環保無空污,成為電動車最新代名詞,目前市場使用率逐漸普及化

※廣告預算用在刀口上,網站設計公司幫您達到更多曝光效益

羞,Spring Bean 初始化/銷毀竟然有這麼多姿勢

文章來源:

一、前言

日常開發過程有時需要在應用啟動之後加載某些資源,或者在應用關閉之前釋放資源。Spring 框架提供相關功能,圍繞 Spring Bean 生命周期,可以在 Bean 創建過程初始化資源,以及銷毀 Bean 過程釋放資源。Spring 提供多種不同的方式初始化/銷毀 Bean,如果同時使用這幾種方式,Spring 如何處理這幾者之間的順序?

有沒有覺得標題很熟悉,沒錯標題模仿二哥 「@沉默王二」 文章。

二、姿勢剖析

首先我們先來回顧一下 Spring 初始化/銷毀 Bean 幾種方式,分別為:

  • init-method/destroy-method
  • InitializingBean/DisposableBean
  • @PostConstruct/@PreDestroy
  • ContextStartedEvent/ContextClosedEvent

PS: 其實還有一種方式,就是繼承 Spring Lifecycle 接口。不過這種方式比較繁瑣,這裏就不再分析。

2.1、init-method/destroy-method

這種方式在配置文件文件指定初始化/銷毀方法。XML 配置如下

<bean id="demoService" class="com.dubbo.example.provider.DemoServiceImpl"  destroy-method="close"  init-method="initMethod"/>

或者也可以使用註解方式配置:

@Configurable
public class AppConfig {

    @Bean(initMethod = "init", destroyMethod = "destroy")
    public HelloService hello() {
        return new HelloService();
    }
}

還記得剛開始接觸學習 Spring 框架,使用就是這種方式。

2.2、InitializingBean/DisposableBean

這種方式需要繼承 Spring 接口 InitializingBean/DisposableBean,其中 InitializingBean 用於初始化動作,而 DisposableBean 用於銷毀之前清理動作。使用方式如下:

@Service
public class HelloService implements InitializingBean, DisposableBean {
    
    @Override
    public void destroy() throws Exception {
        System.out.println("hello destroy...");
    }

    @Override
    public void afterPropertiesSet() throws Exception {
        System.out.println("hello init....");
    }
}

2.3、@PostConstruct/@PreDestroy

這種方式相對於上面兩種方式來說,使用方式最簡單,只需要在相應的方法上使用註解即可。使用方式如下:

@Service
public class HelloService {


    @PostConstruct
    public void init() {
        System.out.println("hello @PostConstruct");
    }

    @PreDestroy
    public void PreDestroy() {
        System.out.println("hello @PreDestroy");
    }
}

這裏踩過一個坑,如果使用 JDK9 之後版本 ,@PostConstruct/@PreDestroy 需要使用 maven 單獨引入 javax.annotation-api,否者註解不會生效。

2.4、ContextStartedEvent/ContextClosedEvent

這種方式使用 Spring 事件機制,日常業務開發比較少見,常用與框架集成中。Spring 啟動之後將會發送 ContextStartedEvent 事件,而關閉之前將會發送 ContextClosedEvent 事件。我們需要繼承 Spring ApplicationListener 才能監聽以上兩種事件。

@Service
public class HelloListener implements ApplicationListener {

    @Override
    public void onApplicationEvent(ApplicationEvent event) {
        if(event instanceof ContextClosedEvent){
            System.out.println("hello ContextClosedEvent");
        }else if(event instanceof ContextStartedEvent){
            System.out.println("hello ContextStartedEvent");
        }

    }
}

也可以使用 @EventListener註解,使用方式如下:

public class HelloListenerV2 {
    
    @EventListener(value = {ContextClosedEvent.class, ContextStartedEvent.class})
    public void receiveEvents(ApplicationEvent event) {
        if (event instanceof ContextClosedEvent) {
            System.out.println("hello ContextClosedEvent");
        } else if (event instanceof ContextStartedEvent) {
            System.out.println("hello ContextStartedEvent");
        }
    }
}

PS:只有調用 ApplicationContext#start 才會發送 ContextStartedEvent。若不想這麼麻煩,可以監聽 ContextRefreshedEvent 事件代替。一旦 Spring 容器初始化完成,就會發送 ContextRefreshedEvent。

三、綜合使用

回顧完上面幾種方式,這裏我們綜合使用上面的四種方式,來看下 Spring 內部的處理順序。在看結果之前,各位讀者大人可以猜測下這幾種方式的執行順序。

public class HelloService implements InitializingBean, DisposableBean {


    @PostConstruct
    public void init() {
        System.out.println("hello @PostConstruct");
    }

    @PreDestroy
    public void PreDestroy() {
        System.out.println("hello @PreDestroy");
    }

    @Override
    public void destroy() throws Exception {
        System.out.println("bye DisposableBean...");
    }

    @Override
    public void afterPropertiesSet() throws Exception {
        System.out.println("hello InitializingBean....");
    }

    public void xmlinit(){
        System.out.println("hello xml-init...");
    }

    public void xmlDestory(){
        System.out.println("bye xmlDestory...");
    }

    @EventListener(value = {ContextClosedEvent.class, ContextStartedEvent.class})
    public void receiveEvents(ApplicationEvent event) {
        if (event instanceof ContextClosedEvent) {
            System.out.println("bye ContextClosedEvent");
        } else if (event instanceof ContextStartedEvent) {
            System.out.println("hello ContextStartedEvent");
        }
    }

}

xml 配置方式如下:

    <context:annotation-config />
    <context:component-scan base-package="com.dubbo.example.demo"/>
    
    <bean class="com.dubbo.example.demo.HelloService" init-method="xmlinit" destroy-method="xmlDestory"/>

應用啟動方法如下:

ClassPathXmlApplicationContext context = new ClassPathXmlApplicationContext("spring/dubbo-provider.xml");
context.start();
context.close();

程序輸出結果如下所示:

最後採用圖示說明總結以上結果:

四、源碼解析

不知道各位讀者有沒有猜對這幾種方式的執行順序,下面我們就從源碼角度解析 Spring 內部處理的順序。

4.1、初始化過程

使用 ClassPathXmlApplicationContext 啟動 Spring 容器,將會調用 refresh 方法初始化容器。初始化過程將會創建 Bean 。最後當一切準備完畢,將會發送 ContextRefreshedEvent。當容器初始化完畢,調用 context.start() 就發送 ContextStartedEvent 事件。

refresh 方法源碼如下:

public void refresh() throws BeansException, IllegalStateException {
    synchronized (this.startupShutdownMonitor) {
            //... 忽略無關代碼

            // 初始化所有非延遲初始化的 Bean
            finishBeanFactoryInitialization(beanFactory);

            // 發送 ContextRefreshedEvent
            finishRefresh();

            //... 忽略無關代碼
    }
}

一路跟蹤 finishBeanFactoryInitialization 源碼,直到 AbstractAutowireCapableBeanFactory#initializeBean,源碼如下:

protected Object initializeBean(final String beanName, final Object bean, RootBeanDefinition mbd) {
    Object wrappedBean = bean;
    if (mbd == null || !mbd.isSynthetic()) {
        // 調用 BeanPostProcessor#postProcessBeforeInitialization 方法
        wrappedBean = applyBeanPostProcessorsBeforeInitialization(wrappedBean, beanName);
    }

    try {
        // 初始化 Bean
        invokeInitMethods(beanName, wrappedBean, mbd);
    }
    catch (Throwable ex) {
        throw new BeanCreationException(
                (mbd != null ? mbd.getResourceDescription() : null),
                beanName, "Invocation of init method failed", ex);
    }
}

BeanPostProcessor 將會起着攔截器的作用,一旦 Bean 符合條件,將會執行一些處理。這裏帶有 @PostConstruct 註解的 Bean 都將會被 CommonAnnotationBeanPostProcessor 類攔截,內部將會觸發 @PostConstruct 標註的方法。

接着執行 invokeInitMethods ,方法如下:

protected void invokeInitMethods(String beanName, final Object bean, RootBeanDefinition mbd)
        throws Throwable {

    boolean isInitializingBean = (bean instanceof InitializingBean);
    if (isInitializingBean && (mbd == null || !mbd.isExternallyManagedInitMethod("afterPropertiesSet"))) {
        // 省略無關代碼
        // 如果是 Bean 繼承 InitializingBean,將會執行  afterPropertiesSet 方法
        ((InitializingBean) bean).afterPropertiesSet();
    }

    if (mbd != null) {
        String initMethodName = mbd.getInitMethodName();
        if (initMethodName != null && !(isInitializingBean && "afterPropertiesSet".equals(initMethodName)) &&
                !mbd.isExternallyManagedInitMethod(initMethodName)) {
            // 執行 XML 定義 init-method
            invokeCustomInitMethod(beanName, bean, mbd);
        }
    }
}

如果 Bean 繼承 InitializingBean 接口,將會執行 afterPropertiesSet 方法,另外如果在 XML 中指定了 init-method ,也將會觸發。

上面源碼其實都是圍繞着 Bean 創建的過程,當所有 Bean 創建完成之後,調用 context#start 將會發送 ContextStartedEvent 。這裏源碼比較簡單,如下:

public void start() {
    getLifecycleProcessor().start();
    publishEvent(new ContextStartedEvent(this));
}

4.2、銷毀過程

調用 ClassPathXmlApplicationContext#close 方法將會關閉容器,具體邏輯將會在 doClose 方法執行。

doClose 這個方法首先發送 ContextClosedEvent,然再后開始銷毀 Bean。

靈魂拷問:如果我們顛倒上面兩者順序,結果會一樣嗎?

doClose 源碼如下:

protected void doClose() {
    if (this.active.get() && this.closed.compareAndSet(false, true)) {
        // 省略無關代碼

        try {
            // Publish shutdown event.
            publishEvent(new ContextClosedEvent(this));
        }
        catch (Throwable ex) {
            logger.warn("Exception thrown from ApplicationListener handling ContextClosedEvent", ex);
        }


        // 銷毀 Bean
        destroyBeans();

        // 省略無關代碼
    }
}

destroyBeans 最終將會執行 DisposableBeanAdapter#destroy,@PreDestroy、DisposableBean、destroy-method 三者定義的方法都將會在內部被執行。

首先執行 DestructionAwareBeanPostProcessor#postProcessBeforeDestruction,這裏方法類似與上面 BeanPostProcessor。

@PreDestroy 註解將會被 CommonAnnotationBeanPostProcessor 攔截,這裏類同時也繼承了 DestructionAwareBeanPostProcessor。

最後如果 Bean 為 DisposableBean 的子類,將會執行 destroy 方法,如果在 xml 定義了 destroy-method 方法,該方法也會被執行。

public void destroy() {
    if (!CollectionUtils.isEmpty(this.beanPostProcessors)) {
        for (DestructionAwareBeanPostProcessor processor : this.beanPostProcessors) {
            processor.postProcessBeforeDestruction(this.bean, this.beanName);
        }
    }

    if (this.invokeDisposableBean) {
        // 省略無關代碼
        // 如果 Bean 繼承 DisposableBean,執行 destroy 方法
        ((DisposableBean) bean).destroy();
        
    }

    if (this.destroyMethod != null) {
        // 執行 xml 指定的  destroy-method 方法
        invokeCustomDestroyMethod(this.destroyMethod);
    }
    else if (this.destroyMethodName != null) {
        Method methodToCall = determineDestroyMethod();
        if (methodToCall != null) {
            invokeCustomDestroyMethod(methodToCall);
        }
    }
}

五、總結

init-method/destroy-method 這種方式需要使用 XML 配置文件或單獨註解配置類,相對來說比較繁瑣。而InitializingBean/DisposableBean 這種方式需要單獨繼承 Spring 的接口實現相關方法。@PostConstruct/@PreDestroy 這種註解方式使用方式簡單,代碼清晰,比較推薦使用這種方式。

另外 ContextStartedEvent/ContextClosedEvent 這種方式比較適合在一些集成框架使用,比如 Dubbo 2.6.X 優雅停機就是用改機制。

六、Spring 歷史文章推薦

歡迎關注我的公眾號:程序通事,獲得日常乾貨推送。如果您對我的專題內容感興趣,也可以關注我的博客:

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選

Java描述設計模式(23):訪問者模式

本文源碼: ||

一、生活場景

1、場景描述

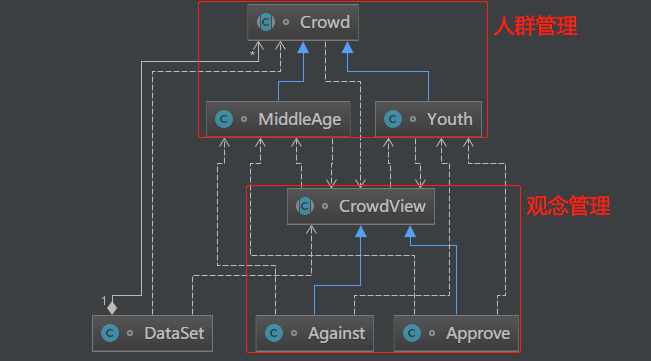
電競是遊戲比賽達到“競技”層面的體育項目。利用电子設備作為運動器械進行的、人與人之間的智力對抗運動。通過電競,可以提高人的反應能力、協調能力、團隊精神等。但是不同人群的對電競的持有的觀念不一樣,有的人認為電競就是沉迷網絡,持反對態度,而有的人就比較贊同。下面基於訪問者模式來描述該場景。

2、場景圖解

3、代碼實現

public class C01_InScene {
    public static void main(String[] args) {
        DataSet dataSet = new DataSet() ;
        dataSet.addCrowd(new Youth());
        dataSet.addCrowd(new MiddleAge());
        CrowdView crowdView = new Against() ;
        dataSet.display(crowdView);
        crowdView = new Approve() ;
        dataSet.display(crowdView);
    }
}
/**
 * 雙分派,不同人群管理
 */
abstract class Crowd {
    abstract void accept(CrowdView action);
}
class Youth extends Crowd {
    @Override
    public void accept(CrowdView view) {
        view.getYouthView(this);
    }
}
class MiddleAge extends Crowd {
    @Override
    public void accept(CrowdView view) {
        view.getMiddleAgeView (this);
    }
}
/**
 * 不同人群觀念的管理
 */
abstract class CrowdView {
    // 青年人觀念
    abstract void getYouthView (Youth youth);
    // 中年人觀念
    abstract void getMiddleAgeView (MiddleAge middleAge);
}
class Approve extends CrowdView {
    @Override
    public void getYouthView(Youth youth) {
        System.out.println("青年人贊同電競");
    }
    @Override
    public void getMiddleAgeView(MiddleAge middleAge) {
        System.out.println("中年人贊同電競");
    }
}
class Against extends CrowdView {
    @Override
    public void getYouthView(Youth youth) {
        System.out.println("青年人反對電競");
    }
    @Override
    public void getMiddleAgeView(MiddleAge middleAge) {
        System.out.println("中年人反對電競");
    }
}
/**
 * 提供一個數據集合
 */
class DataSet {
    private List<Crowd> crowdList = new ArrayList<>();
    public void addCrowd (Crowd crowd) {
        crowdList.add(crowd);
    }
    public void display(CrowdView crowdView) {
        for(Crowd crowd : crowdList) {
            crowd.accept(crowdView);
        }
    }
}

二、訪問者模式

1、基礎概念

訪問者模式是對象的行為模式,把作用於數據結構的各元素的操作封裝,操作之間沒有關聯。可以在不改變數據結構的前提下定義作用於這些元素的不同的操作。主要將數據結構與數據操作分離,解決數據結構和操作耦合問題核心原理:被訪問的類裏面加對外提供接待訪問者的接口。

2、模式圖解

3、核心角色

  • 抽象訪問者角色

聲明多個方法操作,具體訪問者角色需要實現的接口。

  • 具體訪問者角色

實現抽象訪問者所聲明的接口,就是各個訪問操作。

  • 抽象節點角色

聲明接受操作,接受訪問者對象作為參數。

  • 具體節點角色

實現抽象節點所規定的具體操作。

  • 結構對象角色

能枚舉結構中的所有元素,可以提供一個高層的接口,用來允許訪問者對象訪問每一個元素。

4、源碼實現

public class C02_Visitor {
    public static void main(String[] args) {
        ObjectStructure obs = new ObjectStructure();
        obs.add(new NodeA());
        obs.add(new NodeB());
        Visitor visitor = new VisitorA();
        obs.doAccept(visitor);
    }
}
/**
 * 抽象訪問者角色
 */
interface Visitor {
    /**
     * NodeA的訪問操作
     */
    void visit(NodeA node);
    /**
     * NodeB的訪問操作
     */
    void visit(NodeB node);
}
/**
 * 具體訪問者角色
 */
class VisitorA implements Visitor {
    @Override
    public void visit(NodeA node) {
        node.operationA() ;
    }
    @Override
    public void visit(NodeB node) {
        node.operationB() ;
    }
}
class VisitorB implements Visitor {
    @Override
    public void visit(NodeA node) {
        node.operationA() ;
    }
    @Override
    public void visit(NodeB node) {
        node.operationB() ;
    }
}
/**
 * 抽象節點角色
 */
abstract class Node {
    /**
     * 接收訪問者
     */
    abstract void accept(Visitor visitor);
}
/**
 * 具體節點角色
 */
class NodeA extends Node{
    @Override
    public void accept(Visitor visitor) {
        visitor.visit(this);
    }
    public void operationA(){
        System.out.println("NodeA.operationA");
    }
}
class NodeB extends Node{
    @Override
    public void accept(Visitor visitor) {
        visitor.visit(this);
    }
    public void operationB(){
        System.out.println("NodeB.operationB");
    }
}
/**
 * 結構對象角色類
 */
class ObjectStructure {
    private List<Node> nodes = new ArrayList<>();
    public void detach(Node node) {
        nodes.remove(node);
    }
    public void add(Node node){
        nodes.add(node);
    }
    public void doAccept(Visitor visitor){
        for(Node node : nodes) {
            node.accept(visitor);
        }
    }
}

三、Spring框架應用

1、Bean結構的訪問

BeanDefinitionVisitor類,遍歷bean的各個屬性;接口 BeanDefinition,定義Bean的各樣信息,比如屬性值、構造方法、參數等等。這裏封裝操作bean結構的相關方法,但卻沒有改變bean的結構。

2、核心代碼塊

public class BeanDefinitionVisitor {
    public void visitBeanDefinition(BeanDefinition beanDefinition) {
        this.visitParentName(beanDefinition);
        this.visitBeanClassName(beanDefinition);
        this.visitFactoryBeanName(beanDefinition);
        this.visitFactoryMethodName(beanDefinition);
        this.visitScope(beanDefinition);
        if (beanDefinition.hasPropertyValues()) {
            this.visitPropertyValues(beanDefinition.getPropertyValues());
        }
        if (beanDefinition.hasConstructorArgumentValues()) {
            ConstructorArgumentValues cas = beanDefinition.getConstructorArgumentValues();
            this.visitIndexedArgumentValues(cas.getIndexedArgumentValues());
            this.visitGenericArgumentValues(cas.getGenericArgumentValues());
        }
    }
}

四、模式總結

1、優點描述

(1) 訪問者模式符合單一職責原則、使程序具有良好的擴展性、靈活性;

(2) 訪問者模式適用與攔截器與過濾器等常見功能,數據結構相對穩定的場景;

2、缺點描述

(1) 訪問者關注其他類的內部細節,依賴性強,違反迪米特法則,這樣導致具體元素更新麻煩;

(2) 訪問者依賴具體元素,不是抽象元素,面向細節編程,違背依賴倒轉原則;

五、源代碼地址

GitHub·地址
https://github.com/cicadasmile/model-arithmetic-parent
GitEE·地址
https://gitee.com/cicadasmile/model-arithmetic-parent

本站聲明:網站內容來源於博客園,如有侵權,請聯繫我們,我們將及時處理【其他文章推薦】

※USB CONNECTOR掌控什麼技術要點? 帶您認識其相關發展及效能

※評比前十大台北網頁設計、台北網站設計公司知名案例作品心得分享

※智慧手機時代的來臨,RWD網頁設計已成為網頁設計推薦首選